 KI
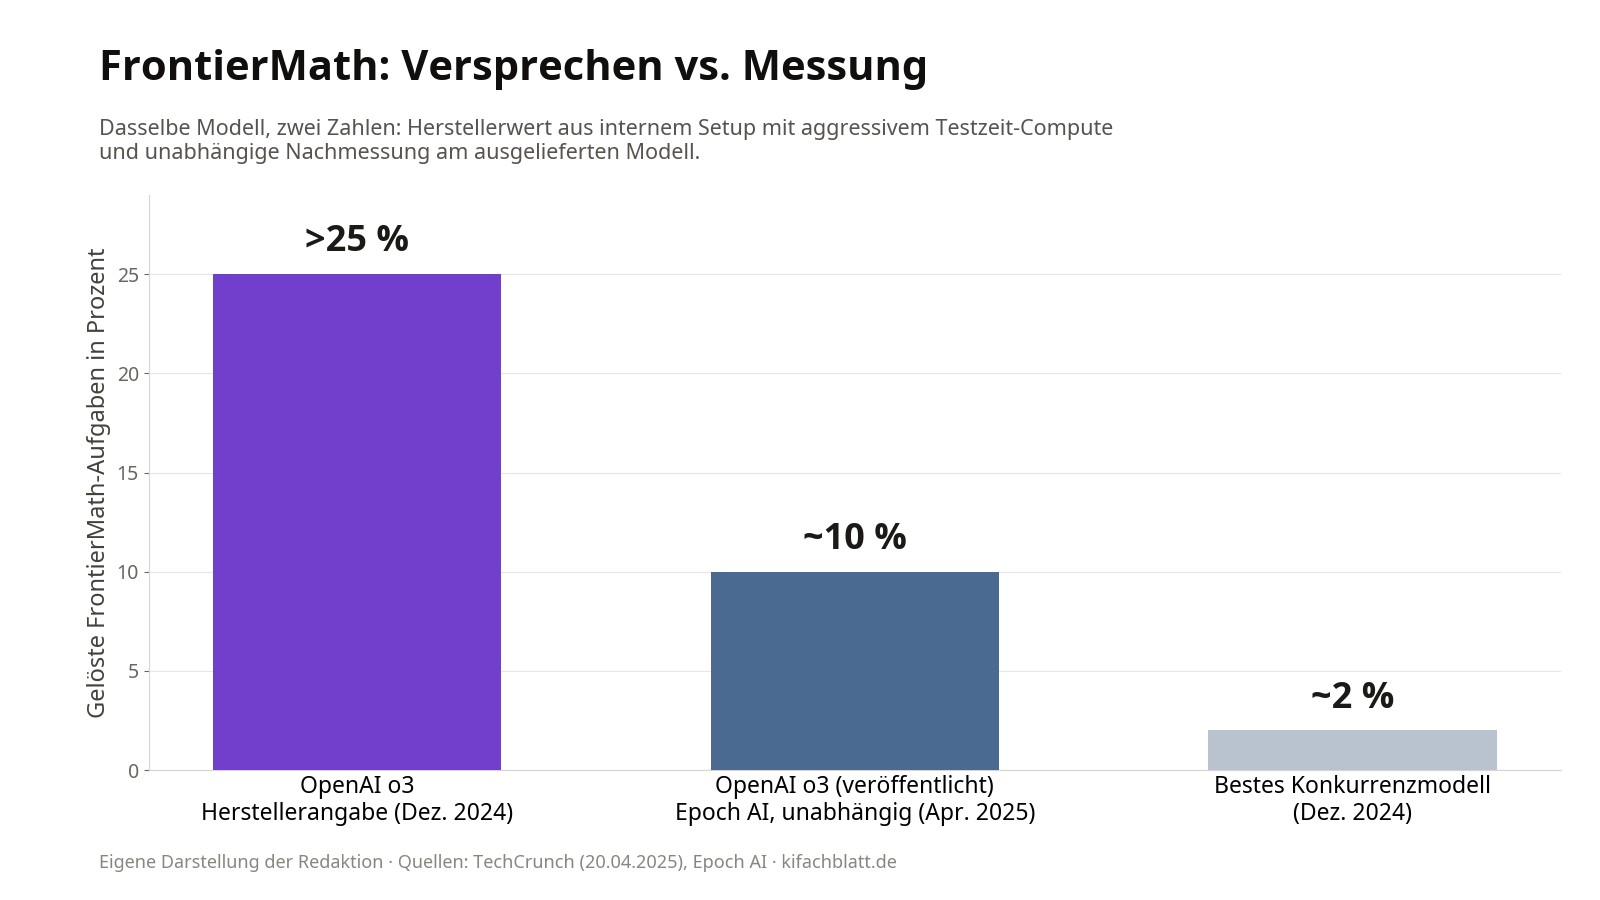
Zu jedem größeren Modell-Release gehört inzwischen eine Benchmark-Tabelle: Zeilen mit Testnamen, Spalten mit Konkurrenzmodellen, die eigene Zahl fett gesetzt und möglichst ganz oben. Diese Zahlen stammen fast immer aus dem Labor des Herstellers selbst. Wie weit Selbstauskunft und unabhängige Messung auseinanderliegen können, zeigt der wohl am besten dokumentierte Fall der jüngeren Modellgeschichte: Bei der Vorstellung von o3 im Dezember 2024 erklärte OpenAIs Forschungschef Mark Chen, das Modell löse mit aggressiven Testzeit-Compute-Einstellungen über 25 Prozent der Aufgaben von FrontierMath, eines extrem schweren Mathematik-Benchmarks. Zum Vergleich: Alle bis dahin verfügbaren Modelle lagen unter 2 Prozent [1].
Im April 2025 maß Epoch AI, das Forschungsinstitut hinter FrontierMath, das tatsächlich veröffentlichte o3 unabhängig nach. Ergebnis: rund 10 Prozent [1]. Zwischen den beiden Zahlen liegt der Faktor 2,5, und sie beschreiben denselben Modellnamen. Dieser Artikel legt dar, wie ein solcher Abstand zustande kommt, ohne dass jemand im engeren Sinne falsch rechnen muss: über Compute-Einstellungen, Werkzeugumgebungen, Teilmengen und Auswahlentscheidungen. Wir zeigen die belegten Fälle, rechnen die Größenordnungen offen nach und leiten ab, woran man eine belastbare Benchmark-Angabe erkennt. Alle Beispiele stammen aus den am Ende verlinkten Quellen; eigene Rechnungen sind als solche gekennzeichnet.
Der Fall o3: ein Modellname, zwei Messungen
Die 25 Prozent aus dem Dezember 2024 waren eine interne Messung. OpenAI kommunizierte sie in einem Livestream, mit dem Zusatz, sie sei mit aggressiven Testzeit-Compute-Einstellungen erreicht worden [1]. Das Modell, das Nutzerinnen und Entwickler Wochen später tatsächlich bekamen, war ein anderes: Die ARC Prize Foundation, die eine Vorabversion getestet hatte, stellte nach dem Release fest, das öffentliche o3 sei ein anderes, für Chat- und Produktnutzung abgestimmtes Modell, und alle veröffentlichten Compute-Stufen seien kleiner als die ursprünglich getestete Version. Die eigene frühere Berichterstattung etikettierte die Stiftung nachträglich als Vorschau um [1].
Today, all offerings out there have less than 2 percent. We're seeing internally, with o3 in aggressive test-time compute settings, we're able to get over 25 percent.
Epoch AI selbst lieferte die sachlichste Erklärung für den Abstand: Die Differenz könne an einem leistungsstärkeren internen Scaffold liegen, an mehr eingesetzter Rechenzeit pro Aufgabe oder daran, dass OpenAI auf einer anderen Teilmenge des Benchmarks gemessen habe, nämlich 180 Aufgaben aus dem Stand November 2024 statt der 290 Aufgaben der neueren privaten Version [1]. Dazu passt die Erklärung von OpenAI-Mitarbeiter Wenda Zhou, das ausgelieferte Modell sei stärker auf reale Anwendungsfälle und Geschwindigkeit optimiert, weshalb Abweichungen zu erwarten seien [1]. Fairerweise gehört zur Dokumentation auch: OpenAIs Dezember-Diagramm enthielt eine untere Schranke, die ungefähr dem später von Epoch gemessenen Wert entsprach [1].
Wie groß der Unterschied zwischen den Stufen ausfallen kann, bezifferte dieselbe Stiftung: Ihre Vorab-Messung von o3-preview auf ARC-AGI-1 lag bei 75,7 Prozent in der niedrigen Compute-Stufe (200 Dollar pro Aufgabe) und bei 87,5 Prozent in der hohen (34.400 Dollar pro Aufgabe) [1]. Ein und dieselbe Modellfamilie liefert also je nach eingesetztem Compute Ergebnisse, die fast zwölf Prozentpunkte auseinanderliegen. Eine Benchmark-Zahl ohne Angabe der Stufe ist damit nur die Hälfte der Information.
Der Fall ist deshalb kein Skandal im Sinn einer erfundenen Zahl, sondern ein Lehrstück in Kommunikation: Eine unter Idealbedingungen gemessene Obergrenze wurde zur Überschrift, die Auslieferungsversion lieferte davon deutlich weniger. Wer nur die Fett-Zahl aus dem Release mitnahm, hatte ein falsches Bild der Modellfähigkeit.
Die Stellschrauben hinter jeder Herstellerzahl
Ein Benchmark-Ergebnis ist keine Eigenschaft des Modells allein, sondern das Ergebnis eines Messaufbaus. Wer diesen Aufbau kontrolliert, hat mindestens sieben Stellschrauben in der Hand. Die folgende Übersicht fasst sie zusammen, jeweils mit einem belegten Beispiel aus den Quellen.
- Testzeit-Compute — wie viel Rechenzeit und Denktiefe pro Antwort eingesetzt wird: Der 25-Prozent-Wert von o3 entstand mit aggressiven Testzeit-Compute-Einstellungen [1].
- Scaffold — die Werkzeugumgebung um das Modell: Epoch nennt ein stärkeres internes Gerüst als möglichen Grund für den o3-Abstand [1]; FrontierMath gewährt Modellen eine Python-Umgebung mit ausreichend Bedenkzeit [7].
- Prompting — Zusatzinstruktionen an das Modell: Anthropic erzielt TAU-bench-Ergebnisse mit einem Prompt-Addendum, das das Reasoning im Werkzeuggebrauch verbessern soll [3].
- Schrittlimits — die maximal erlaubten Züge des Agenten: Anthropic erhöhte das TAU-bench-Maximum von 30 auf 100 Schritte [3].
- Denkbudget — der Umfang der Reasoning-Token: Anthropic berichtet Bestwerte mit erweitertem Denken bis 64K Token und kennzeichnet, welche Werte ohne entstanden [3].
- Teilmenge — welche Aufgaben des Benchmarks zählen: o3 wurde auf 180 statt 290 FrontierMath-Aufgaben gemessen [1]; bei SWE-bench wertet Anthropic alle 500 aus, für OpenAI-Modelle werden nur 477 berichtet [3].
- Auswahl der Zahl — welche Variante berichtet wird: Anthropic nennt jeweils den höchsten Wert mit oder ohne erweitertes Denken [3]; Meta testete vor Llama 4 privat 27 Varianten [4].
Bemerkenswert an der Anthropic-Dokumentation ist nicht, dass ein Hersteller diese Schrauben dreht, sondern dass er es offenlegt: In den Fußnoten der Modellankündigung steht, welche Werte mit erweitertem Denken entstanden, dass ein Prompt-Addendum verwendet wurde und auf wie vielen Aufgaben gemessen wurde [3]. Genau daran scheitert die Vergleichbarkeit trotzdem: Jeder Hersteller dreht an anderen Schrauben, und selbst mit Fußnoten bleiben zwei Tabellen aus zwei Laboren zwei verschiedene Messungen. Die ehrliche Fußnote löst das Vergleichsproblem nicht, sie macht es nur sichtbar.
Wenn der Benchmark dem Hersteller gehört
Der zweite Verzerrungsmechanismus liegt eine Ebene tiefer: bei den Aufgaben selbst. Epoch AI hat im Januar 2025 offengelegt, dass OpenAI die 300 Kernaufgaben von FrontierMath in Auftrag gegeben hatte und ihnen gehörten. OpenAI hatte Zugang zu den Aufgabenstellungen und den Lösungen, mit Ausnahme eines Holdout-Sets von 50 Aufgaben, für das der Hersteller nur die Fragen, nicht die Lösungen erhielt. Epoch durfte weiterhin beliebige Modelle auf dem Datensatz auswerten und veröffentlichen, brauchte aber die Erlaubnis von OpenAI, um die Beteiligung überhaupt öffentlich zu machen. Viele der beitragenden Mathematikerinnen und Mathematiker wussten bis zur Veröffentlichung nichts von der Finanzierung [2].
Das Design von FrontierMath zeigt zugleich, wie aufwendig der Schutz vor Kontamination ist: Der Benchmark umfasst 350 eigens erstellte Aufgaben in vier Schwierigkeitsstufen, von Olympiade-Niveau bis zu Problemen, die nach Aussage der beteiligten Mathematiker selbst Feldmedaillisten wie Terence Tao über Jahre widerstehen dürften. Jede Aufgabe hat eine geschlossene, maschinell prüfbare Antwort, die durch Erraten praktisch nicht zu treffen ist, und jede wird von Fachexperten begutachtet [7]. An dieser Qualität sollte sich nichts ändern, weil ein Hersteller die Aufgaben besitzt; an der Überprüfbarkeit aus Sicht der Öffentlichkeit schon.
Daraus folgt nicht, dass OpenAI die Aufgaben ins Training gemischt hat. Es folgt aber, dass Außenstehende es nicht prüfen können. Genau gegen dieses Risiko war FrontierMath angetreten: Alle Aufgaben sind neu und unveröffentlicht, damit kein Modell sie im Training gesehen haben kann [7]. Wenn der Auftraggeber eines Benchmarks die Aufgaben besitzt, hängt die Aussagekraft des Benchmarks an seinem Versprechen, diesen Vorsprung nicht zu nutzen. Das Fachwort dafür ist Kontamination: Taucht Testmaterial im Training auf, misst der Benchmark Gedächtnis statt Fähigkeit.
Epoch AI hat aus der Episode eigene Konsequenzen gezogen und angekündigt, Förderungen und Datenzugangsvereinbarungen künftig von Anfang an offenzulegen [2]. Der Vorgang bleibt trotzdem der Beleg dafür, dass hinter einer scheinbar neutralen Benchmark-Zahl Eigentums- und Vertraulichkeitsverhältnisse stehen können, die man als Leser der Tabelle nicht sieht.
Die Arena ist kein neutrales Feld
Auch die vermeintlich demokratische Alternative, das LMArena-Ranking (früher Chatbot Arena), ist nachweislich verzerrbar. Die Studie The Leaderboard Illusion untersuchte die Plattform und fand ein undeklariertes Privat-Testen: Eine Handvoll Anbieter darf vor dem Release mehrere Varianten spielen lassen und später die unliebsamen Ergebnisse zurückziehen. Im Extremfall dokumentierten die Autoren 27 private Varianten, die Meta im Vorfeld des Llama-4-Releases testete. Wer aus 27 Varianten die beste berichtet, produziert systematisch nach oben verzerrte Werte, weil die Auswahl der Zahl selbst Teil des Ergebnisses wird [4].
Die zweite Schieflage betrifft die Daten: Geschlossene Modelle werden häufiger gegeneinander gespielt und seltener aus der Arena entfernt. Auf Google und OpenAI entfielen nach Schätzung der Studie 19,2 beziehungsweise 20,4 Prozent aller Arenadaten, während 83 offene Modelle zusammen auf nur 29,7 Prozent kamen. Diese Datenasymmetrie ist wertvoll, denn wer Zugang zu Arenadaten hat, kann gezielt darauf trainieren: Die Autoren schätzen den möglichen relativen Leistungsgewinn auf der Arena-Verteilung auf bis zu 112 Prozent, konservativ gerechnet. Die Folge ist Overfitting auf die Eigenheiten der Plattform statt auf allgemeine Modellqualität [4].
Dass es sich nicht um Einzelfälle handelt, zeigt die Berichterstattung zum o3-Release: Meta räumte kurz zuvor ein, mit Benchmark-Werten einer Modellversion geworben zu haben, die sich von der an Entwickler ausgelieferten unterschied, und xAI stand wegen irreführender Diagramme zu Grok 3 in der Kritik [1].
Manchmal ist der Maßstab selbst defekt
Die dritte Fehlerquelle sitzt im Benchmark, nicht beim Hersteller. OpenAI selbst hat das 2024 für SWE-bench, den meistgenutzten Software-Engineering-Benchmark, dokumentiert: Bei der eigenen Prüfung fanden sich Aufgaben, die schwer oder gar unmöglich zu lösen waren, weil die Bewertungstests zu spezifisch oder themenfremd waren, weil die Fehlerbeschreibungen unterbestimmt waren oder weil die Entwicklungsumgebung nicht zuverlässig aufsetzbar war. Die Konsequenz war SWE-bench Verified, eine von Menschen geprüfte Teilmenge von 500 Aufgaben, die zuverlässiger messen soll [5].
Die Mechanik des Benchmarks erklärt, warum solche Fehler ins Gewicht fallen: Jede SWE-bench-Aufgabe besteht aus einem echten GitHub-Issue samt Codebasis; die Lösung gilt nur dann als gefunden, wenn sowohl die FAIL_TO_PASS-Tests (vorher rot, nachher grün) als auch die PASS_TO_PASS-Tests (dürfen nicht brechen) laufen. OpenAI führt als Beispiel eine Aufgabe aus scikit-learn an, bei der die Tests Verhalten prüften, das mit der eigentlichen Fehlerbeschreibung nichts zu tun hatte, sodass auch korrekte Lösungen durchfielen [5]. Laufen Bewertungstests an der Aufgabe vorbei, wird nicht das Modell schlechter, sondern der Maßstab.
Der Anlass bei OpenAI war ausgerechnet die eigene Risikobewertung: Im Rahmen des Preparedness Frameworks wertet das Unternehmen die Fähigkeit seiner Modelle zu autonomem Handeln aus, und Software-Engineering zählt dort zur mittleren Risikostufe. Wer ein Modell gegen ein Sicherheitskriterium messen will, darf den Maßstab nicht überinterpretieren; OpenAI arbeitete deshalb mit den SWE-bench-Autoren an der überarbeiteten Veröffentlichung [5].
Zur Einordnung der Größenordnung: Im August 2024 lag der Spitzenwert auf SWE-bench bei 20 Prozent und auf der Lite-Variante bei 43 Prozent [5]; auf solchen Teilmengen werden heute Werte über 70 Prozent gemeldet, etwa 74,5 Prozent für Claude Opus 4.1 auf der Verified-Variante [3]. Fortschritt und Maßstabswechsel laufen dabei durcheinander: Ein Wert auf dem Original und ein Wert auf der Verified-Teilmenge sind nicht dieselbe Messung, und auch Epoch AI fand bei der Zweitprüfung von FrontierMath in etwa einer von zwanzig Aufgaben Fehler, eine Fehlerrate auf dem Niveau klassischer Benchmarks wie ImageNet [7]. Wer zwei Modelle anhand von Zahlen aus unterschiedlichen Benchmark-Versionen vergleicht, vergleicht zwei verschiedene Lineale.
Was unabhängige Messungen anders machen
Der Gegenentwurf zur Selbstauskunft ist die standardisierte Fremdmessung. Das bekannteste Beispiel ist HELM der Stanford University: Vor dem Projekt waren Modelle im Mittel auf nur 17,9 Prozent der untersuchten Kern-Szenarien evaluiert worden, manche prominente Modelle teilten sich kein einziges Szenario. HELM maß 30 Modelle unter identischen Bedingungen auf 42 Szenarien und brachte die Abdeckung auf 96,0 Prozent, mit sieben Metriken pro Szenario statt nur Treffergenauigkeit. Entscheidend ist die Transparenz: Sämtliche Prompts und Modellantworten wurden öffentlich gemacht, damit andere die Messung nachvollziehen können [6].
Der Unterschied zur Einzelmetrik ist methodisch entscheidend: HELM misst neben der Treffergenauigkeit Kalibrierung, Robustheit, Fairness, Verzerrung, Toxizität und Effizienz, sodass Kompromisse sichtbar werden statt unter einer einzigen Zahl zu verschwinden. Von den 42 Szenarien waren 21 zuvor in der üblichen Modellevaluation gar nicht verwendet worden, und das Projekt versteht sich als lebendes Verfahren, das um neue Szenarien, Metriken und Modelle wächst [6].
Dieselbe Logik trugen die Nachmessungen von Epoch AI und die Umetikettierung der ARC Prize Foundation im Fall o3 an die Öffentlichkeit: Ein Dritter misst das tatsächlich verfügbare Modell unter einem veröffentlichten Aufbau und stellt das Ergebnis neben die Herstellerangabe [1]. Solche Replikationen sind der einzige Mechanismus, der Release-Tabellen ehrlich hält. Sie sind allerdings aufwendig, und sie hinken den Releases hinterher: Die 10-Prozent-Messung zu o3 erschien erst Monate nach der 25-Prozent-Schlagzeile [1].
Eigene Rechnung: Wie groß die Unterschiede wirklich sind
Daten als Tabelle
| FrontierMath, gelöste Aufgaben in Prozent | |
|---|---|
| OpenAI, interne Messung (Dez. 2024) | 25 % |
| Epoch AI, unabhängig (Apr. 2025) | 10 % |
| Beste Konkurrenz (Dez. 2024) | 2 % |
FrontierMath: Herstellerangabe und unabhängige Messung im Vergleich. Herstellerwert aus internem Setup mit aggressivem Testzeit-Compute. Eigene Darstellung, Quelle [1].
Drei Umrechnungen machen die Größenordnungen greifbar. Alle drei sind eigene Rechnungen auf Basis der Quellenzahlen; die Formeln stehen im Methodenteil.
Die zweite Rechnung verdient einen Zusatz: Sie beschreibt keine Manipulation, sondern Physik. Mehr Rechenzeit pro Aufgabe kauft Genauigkeit, und die Kurve ist teuer. Genau deshalb ist die Angabe der Messbedingungen so wichtig: Eine Zahl ohne die dazugehörige Compute-Stufe ist eine halbe Angabe, denn dieselbe Modellfamilie liefert je nach Stufe unterschiedliche Ergebnisse, wie die ARC-Prize-Werte zeigen [1].
Leseregeln für die nächste Benchmark-Tabelle
Aus den Fällen lassen sich sechs Fragen ableiten, die sich bei jeder neuen Modellankündigung in einer Minute stellen lassen:
- Wer hat gemessen: der Hersteller selbst oder ein unabhängiges Institut mit eigenem Aufbau?
- Unter welchen Bedingungen: welche Compute-Stufe, welches Scaffold, welche Schritt- und Tokenlimits, welches Prompting?
- Ist das getestete Modell das ausgelieferte Modell, oder eine interne beziehungsweise Vorabversion?
- Auf welcher Version und Teilmenge des Benchmarks wurde gemessen, und wem gehört der Benchmark?
- Wird der beste Lauf berichtet oder ein repräsentativer, und wie viele Varianten wurden vorher privat getestet?
- Gibt es eine unabhängige Replikation, und falls ja, mit welchem Ergebnis?
Die Antworten müssen nicht immer beunruhigen. Anthropic zeigt mit seinen Fußnoten, dass Hersteller ihre Messbedingungen offenlegen können [3], und OpenAI hat mit SWE-bench Verified selbst zur Reparatur eines fehlerhaften Maßstabs beigetragen [5]. Der Punkt ist nicht, Herstellerangaben pauschal zu misstrauen, sondern sie als das einzuordnen, was sie sind: Messungen unter selbstgewählten Bedingungen. Belastbar wird eine Modellbehauptung erst, wenn ein zweites Labor unter veröffentlichten Bedingungen zum selben Ergebnis kommt, wie es HELM als Dauerinstitution und Epoch AI im Einzelfall vormachen [6][1]. Bis dahin gilt für die Fett-Zahl in der Release-Tabelle dasselbe wie für jede andere Werbeaussage: Sie ist der Anfang der Prüfung, nicht ihr Ende.
Methode
Grundlage sind sieben Quellen, alle am 21. Oktober 2026 abgerufen: die TechCrunch-Dokumentation des o3-Falls mit den Originalzitaten von OpenAI, Epoch AI und der ARC Prize Foundation, die Offenlegung von Epoch AI zur FrontierMath-Finanzierung, die Anthropic-Ankündigung zu Claude Opus 4.1 mit ihren Benchmark-Fußnoten, die Studie The Leaderboard Illusion, OpenAIs SWE-bench-Verified-Ankündigung, das HELM-Paper und die FrontierMath-Dokumentation. Eigene Rechnungen: (1) 25/10 = 2,5; 25/2 = 12,5; 10/2 = 5. (2) 34.400/200 = 172; (34.400-200)/(87,5-75,7) = 34.200/11,8 ≈ 2.898, gerundet 2.900 Dollar je Prozentpunkt. (3) 29,7/83 ≈ 0,36 Prozent; 20,4/0,36 ≈ 57. Herstellerwert und Messwert im Diagramm sind die gerundeten Quellwerte über 25 beziehungsweise rund 10 Prozent.
Grenzen
Wir haben keine eigenen Messungen an Modellen vorgenommen; alle Benchmark-Zahlen stammen aus den genannten Quellen. Der o3-Fall wird über die TechCrunch-Berichterstattung belegt, die ihrerseits die Originalaussagen zitiert; die Originalposts von Epoch AI und der ARC Prize Foundation auf X haben wir nicht selbst geöffnet. Die Fälle stammen aus den Jahren 2024 und 2025; Offenlegungspraktiken der Hersteller können sich seitdem geändert haben. Die Abweichungen sind keine allgemeine Messgröße: Für andere Modelle und Benchmarks können Herstellerangaben und Fremdmessungen auch eng beieinanderliegen.
Quellen
- OpenAI's o3 AI model scores lower on a benchmark than the company initially implied, TechCrunch (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Clarifying the creation and use of the FrontierMath benchmark, Epoch AI (abgerufen 2026-10-21) ↩1 ↩2 ↩3
- Claude Opus 4.1 (Modellankündigung mit Benchmark-Fußnoten), Anthropic (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- The Leaderboard Illusion (Singh et al.), arXiv:2504.20879 (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4
- Introducing SWE-bench Verified, OpenAI (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4 ↩5
- Holistic Evaluation of Language Models (HELM, Liang et al.), arXiv:2211.09110 (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4
- About FrontierMath (Benchmark-Dokumentation), Epoch AI (abgerufen 2026-10-21) ↩1 ↩2 ↩3 ↩4