 KI
MiniMax hat am 19. Oktober 2026 M3.1 Flash veröffentlicht, die schnelle Variante seines Agenten-Modells. Der Hersteller verspricht einen Generationssprung bei agentischen Aufgaben, Programmierung, Computer Use und Cybersicherheit, fast dreimal schnellere Online-Inferenz und 70 Prozent niedrigere Nutzungskosten gegenüber dem Vorgänger [1]. Gleichzeitig bestätigte das Unternehmen, dass hinter dem seit Ende September anonym auf OpenRouter gelaufenen Modell Space Bunny eine frühe Fassung von M3.1 Flash steckte [1][2].
Dieser Artikel sortiert die Angaben: Was ist belegt, was ist Herstellerbehauptung, und was bedeuten Preis und Geschwindigkeit in der Praxis? Wie immer an dieser Stelle: Alle Leistungswerte stammen aus Selbstauskünften. Wir rechnen mit den veröffentlichten Zahlen weiter, prüfen sie aber nicht am Modell.
Was veröffentlicht wurde
M3.1 Flash ist über die MiniMax-API, das Abonnement M Plan und die Desktop-Anwendung MiniMax Code verfügbar [1]. Dazu kommen Gateways: Vercel listet das Modell unter dem Namen minimax/minimax-m3.1-flash im AI Gateway, AnyRouter führt es ebenfalls und erlaubt die Nutzung mit eigenem MiniMax-Schlüssel zum Herstellerpreis [3][4]. Die Modellgewichte sind es noch nicht: MiniMax kündigt an, sie später zu veröffentlichen. Ein leistungsstärkeres Pro-Modell soll ebenfalls folgen [1].
| Merkmal | Angabe |
|---|---|
| Verfügbar seit | 19. Oktober 2026 (API, M Plan, MiniMax Code) |
| Kontextfenster | 1 Million Token [3] |
| Eingaben | Text, Bild und Video [2][3] |
| Reasoning | Immer aktiv, fünf Stufen von Low bis Max [2][3] |
| Parameter | 428 Mrd. gesamt, laut Entwicklerhandbuch der Vorschau [2] |
| Ausgabegeschwindigkeit | Über 200 TPS Spitze, über 170 TPS Median [1] |
| Preis | 0,15 $ / 0,60 $ / 0,015 $ pro 1 Mio. Tokens (Eingabe / Ausgabe / Cache) [1] |
| Offene Gewichte | Angekündigt, noch nicht veröffentlicht [1] |
Die Parameterzahl von 428 Milliarden ist mit Vorsicht zu lesen: SiliconANGLE bezieht sie aus dem Entwicklerhandbuch der Vorschauversion, nicht aus einer öffentlichen Modellkarte [2]. Die Modellkarte auf Hugging Face war bei unserem Abruf am 20. Oktober 2026 nicht öffentlich erreichbar, der Server antwortete mit HTTP 401. Architekturdetails wie die Zahl aktiver Parameter pro Token sind bislang nicht öffentlich dokumentiert.
Das Space-Bunny-Vorspiel
Ungewöhnlich ist die Vorgeschichte. Seit Ende September 2026 lief auf dem Vermittlungsdienst OpenRouter ein Modell ohne Herstellerangabe unter dem Namen Space Bunny. Nutzerinnen und Nutzer ordneten es MiniMax zu, unter anderem über Eigenschaften des Tokenizers [2]. MiniMax bestätigte die Zuordnung erst mit der Veröffentlichung: Space Bunny war eine frühe Version von M3.1 Flash und hat nach Angaben des Unternehmens über 200 Billionen Tokens verarbeitet [1].
Zur Einordnung der Größenordnung (eigene Rechnung): 200 Billionen Tokens zum Listenpreis für ungecachte Eingabe von 0,15 Dollar pro Million wären umgerechnet 30 Millionen Dollar. Das ist eine Obergrenze und kein Umsatz: Ein Teil des Verkehrs war sicher Ausgabe zum höheren Preis, ein anderer Teil gecachte Eingabe zum Zehntel des Preises, und der anonyme Betrieb diente vermutlich der Datensammlung statt der Abrechnung. Die Zahl zeigt vor allem, dass MiniMax das Modell unter realer Last getestet hat, bevor der Name bekannt war.
Benchmarks: die Herstellerangaben im Detail
MiniMax veröffentlicht fünf Kennzahlen [1]. Auf BankerToolBench, einem Test für mehrstufige Bankenworkflows mit Werkzeugaufrufen, erreicht das Modell 76,2 Punkte. Auf DeepSWE v1.1, einem Softwareentwicklungs-Benchmark mit eigenständigem Testen, 73,7 Prozent. Auf OSWorld V2, das die Bedienung echter Computer misst, 61,7 Punkte, und auf Agents' Last Exam 29,6 Punkte. Für Cybersicherheitsaufgaben nennt MiniMax 82 Prozent auf CyberGym, einem Benchmark, den Forschende der University of California in Berkeley gebaut haben [1][2].
Daten als Tabelle
| Benchmark | M3.1 Flash |
|---|---|
| CyberGym | 82 Pkt. |
| BankerToolBench | 76,2 Pkt. |
| DeepSWE v1.1 | 73,7 Pkt. |
| OSWorld V2 | 61,7 Pkt. |
| Agents' Last Exam | 29,6 Pkt. |
Quelle: Herstellerangaben [1]
Herstellerangaben [1]; die Skalen der Benchmarks sind nicht untereinander vergleichbar, und die Werte sind nicht unabhängig geprüft.
Zwei Einordnungen sind nötig. Erstens: Die Skalen sind nicht vergleichbar. 29,6 Punkte auf Agents' Last Exam sind kein schwacher Wert in einer ansonsten starken Liste, sondern ein harter Benchmark, auf dem auch Spitzenmodelle niedrig liegen. Zweitens: MiniMax behauptet, auf OSWorld V2 und Agents' Last Exam vor allen anderen chinesischen Modellen zu liegen [1][2]. Das ist eine Marktaussage des Herstellers, die wir nicht nachprüfen können.
Der direkteste Vergleich ist DeepSeek V4.1 Flash, zwei Tage älter und zum gleichen Eingabepreis von 0,15 Dollar pro Million Tokens erhältlich [2][5]. DeepSeek meldet für sein Modell 77 Prozent auf DeepSWE v1.1, MiniMax 73,7 Prozent [2]. SiliconANGLE weist zu Recht darauf hin, dass keiner der beiden Werte unabhängig bestätigt ist. Dazu kommt: DeepSeek wertet nach eigener Modellkarte mit acht Samples pro Aufgabe, Temperatur 1,0 und einem Kontextlimit von einer Million Tokens aus [5]. Ob MiniMax vergleichbare Bedingungen gewählt hat, ist nicht dokumentiert.
Die Kostenrechnung
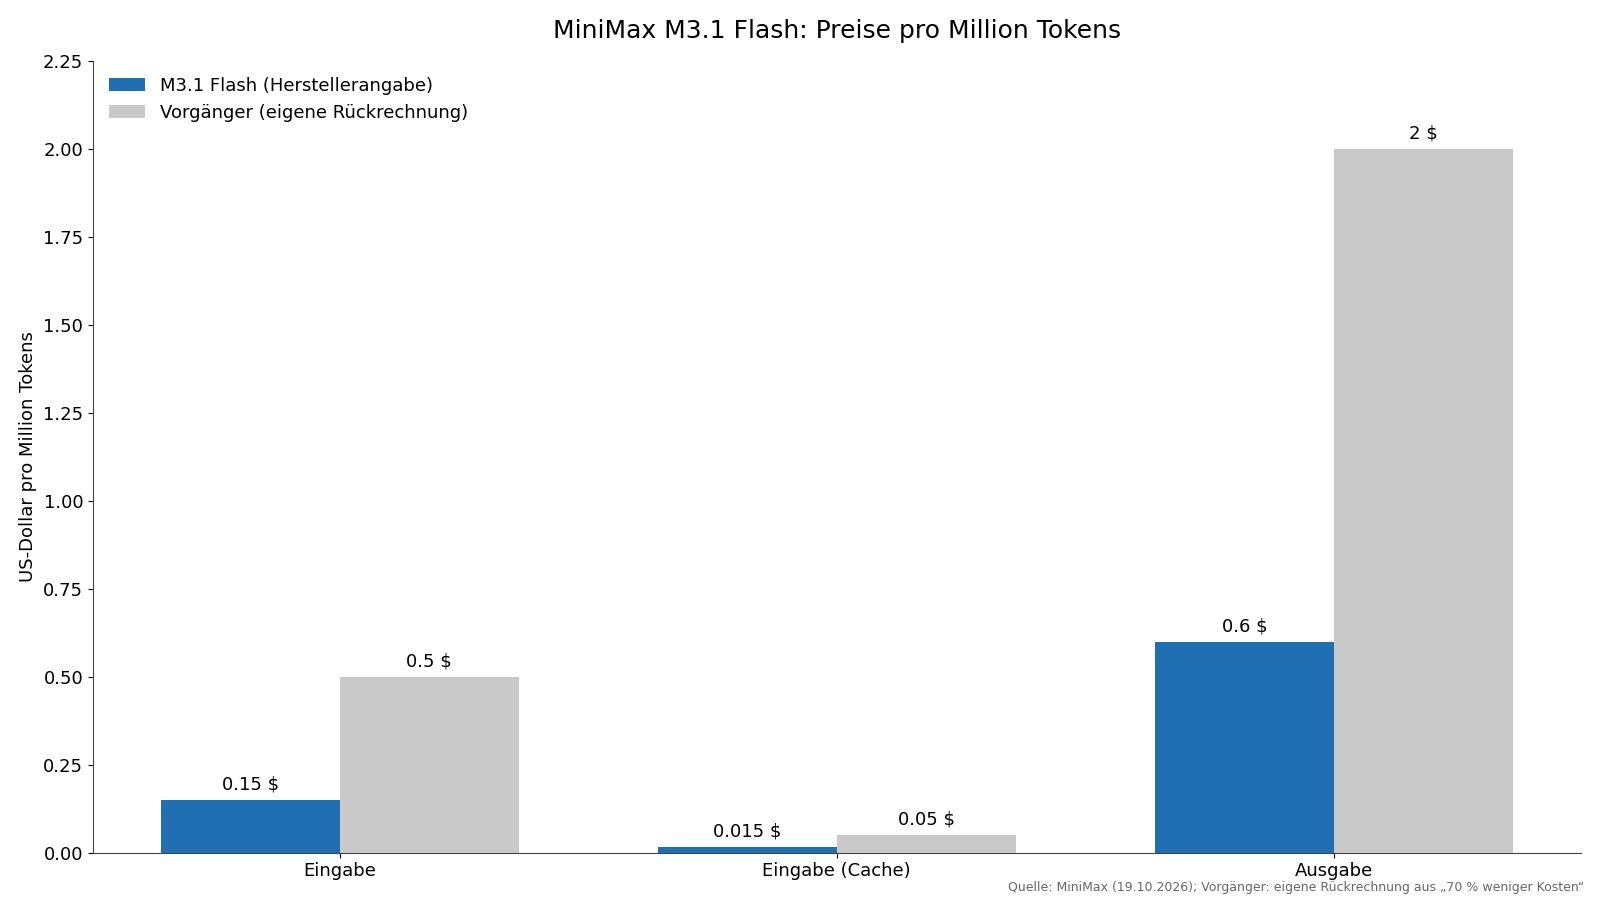
MiniMax verlangt 0,15 Dollar pro Million Eingabetokens, 0,60 Dollar pro Million Ausgabetokens und 0,015 Dollar pro Million gecachter Eingabetokens [1]. Agentische Anwendungen profitieren besonders vom Cache-Preis, weil lange Systemprompts und Werkzeugbeschreibungen bei jedem Schritt wiederkehren.
- Tokens pro Dollar (eigene Rechnung): Für einen Dollar gibt es rund 6,7 Millionen Eingabetokens, 66,7 Millionen gecachte Eingabetokens oder 1,67 Millionen Ausgabetokens.
- Implizierter Vorgängerpreis (eigene Rechnung): Wenn die Nutzung 70 Prozent weniger kostet als M3 und sich die Ermäßigung gleichmäßig verteilt, lag der alte Preis bei etwa 0,50 Dollar pro Million Eingabetokens und 2,00 Dollar pro Million Ausgabetokens. MiniMax nennt keine alten Preise, das ist eine Rückrechnung aus der Prozentangabe.
- Beispiel Agentenlauf (eigene Rechnung): Ein Lauf mit 50 Modellaufrufen à 10.000 Eingabetokens und 2.000 Ausgabetokens verbraucht 500.000 Eingabe- und 100.000 Ausgabetokens. Ohne Cache kostet das 0,075 plus 0,06, also rund 0,14 Dollar. Mit vollständig gecachter Eingabe sinkt es auf etwa 0,07 Dollar.
- Kosten pro Sekunde Ausgabe (eigene Rechnung): Bei 200 Tokens pro Sekunde kostet eine Sekunde Textgenerierung 0,00012 Dollar. Eine Minute ununterbrochener Ausgabe entspricht 12.000 Tokens und kostet 0,0072 Dollar.
- M3.1 Flash
- Vorgänger (imputiert)
Daten als Tabelle
| Tokenart | M3.1 Flash | Vorgänger (imputiert) |
|---|---|---|
| Eingabe | 0,15 $ | 0,5 $ |
| Eingabe (Cache) | 0,01 $ | 0,05 $ |
| Ausgabe | 0,6 $ | 2 $ |
Quelle: Herstellerangaben [1], eigene Rechnung
Herstellerpreise [1]; der Vorgängerpreis ist eine eigene Rückrechnung aus der Angabe „70 Prozent weniger Kosten" und eine Annahme, keine MiniMax-Zahl.
Im Marktkontext des Release-Trackers modeldrops.com liegt M3.1 Flash mit 0,15 Dollar Eingabe auf Augenhöhe mit DeepSeek V4.1 Flash und deutlich unter Muse Spark Open (1,25 Dollar) oder Gemini 4 Argon (2,00 Dollar) [6]. Der Tracker ist ein Aggregator und keine Primärquelle; die dortigen Preise haben wir nicht einzeln bei den Anbietern gegengeprüft.
Geschwindigkeit: was über 200 TPS bedeuten
MiniMax nennt Spitzenwerte über 200 Ausgabetokens pro Sekunde und einen Median von über 170 [1]. Als Grund nennt das Unternehmen aggressivere Sparsamkeit bei der Inferenz. Da die Architektur nicht öffentlich ist, lässt sich das nicht nachrechnen; 428 Milliarden Gesamtparameter bei dieser Geschwindigkeit deuten aber auf ein Mixture-of-Experts-Design mit geringer aktiver Parameterzahl hin (eigene Einschätzung, kein Herstellerfakt).
Für Agenten ist die Geschwindigkeit keine Kosmetik (eigene Rechnung): Ein Lauf mit 50 Schritten à 2.000 Ausgabetokens erzeugt 100.000 Tokens. Bei 200 Tokens pro Sekunde dauert die reine Generierung rund 8 Minuten, bei 60 Tokens pro Sekunde, einem für große Modelle üblichen Wert, fast 28 Minuten. Wer Agenten in Echtzeit beobachten oder korrigieren will, merkt den Unterschied sofort. Eine Antwort von 1.000 Tokens, etwa eine dreiviertel Seite Text, erscheint bei 200 TPS in fünf Sekunden.
Kontext, Multimodalität und dauerhaftes Reasoning
Das Kontextfenster umfasst eine Million Tokens [2][3]. Eine vollständig gefüllte Eingabe kostet ungecacht 0,15 Dollar, gecacht 0,015 Dollar (eigene Rechnung aus den Preisen). Das Modell verarbeitet neben Text auch Bilder und Videos [2][3]. Reasoning ist dauerhaft aktiv, Entwickelnde wählen eine von fünf Stufen zwischen Low und Max [2][3]. Wer Kosten sparen will, sollte die niedrige Stufe prüfen: Reasoning-Tokens sind Ausgabetokens und gehen zu 0,60 Dollar pro Million in Rechnung.
Vergleich mit DeepSeek V4.1 Flash
DeepSeek hat V4.1 Flash am 17. Oktober 2026 mit offenen Gewichten und einer ausführlichen Modellkarte veröffentlicht [5]. Das erlaubt einen Blick auf die unterschiedlichen Ansätze: DeepSeek dokumentiert 552 Milliarden Backbone-Parameter mit nur 8 Milliarden aktiven Parametern bei der Eingabe und 16 Milliarden bei der Ausgabe, einen FP4-quantisierten KV-Cache mit 890 Byte pro Token und spekulative Dekodierung [5]. MiniMax dokumentiert bislang keines dieser Details.
| Merkmal | MiniMax M3.1 Flash | DeepSeek V4.1 Flash |
|---|---|---|
| Veröffentlicht | 19.10.2026 | 17.10.2026 |
| Gewichte offen | Angekündigt, noch nicht da | Ja |
| Parameter | 428 Mrd. (Zweitquelle) [2] | 763 Mrd. gesamt, 552 Mrd. Backbone [5] |
| Aktive Parameter | Nicht dokumentiert | 8 Mrd. Eingabe / 16 Mrd. Ausgabe [5] |
| Kontext | 1 Mio. Tokens | 1 Mio. Tokens |
| DeepSWE v1.1 | 73,7 Prozent [1] | 77 Prozent [2] |
| Eingabepreis | 0,15 $ / 1 Mio. [1] | 0,15 $ / 1 Mio. (Schwachlast) [2] |
Beide Modelle zielen auf denselben Einsatz: lange, werkzeuggestützte Agentenläufe zu niedrigen Kosten. DeepSeek hat den transparenteren Release vorgelegt, MiniMax das ungewöhnlichere Testprogramm. Wer reproduzierbare Zahlen braucht, sollte beide auf eigenen Aufgaben messen, statt Herstellerbenchmarks zu vergleichen.
Kosten pro Token oder Kosten pro Aufgabe?
Die wichtigste Zahl des Releases steht nicht in der Preistabelle. MiniMax schreibt, agentische Aufgaben kosteten mit M3.1 Flash insgesamt 70 Prozent weniger als mit dem Vorgänger [1]. Das ist eine andere Behauptung als „die Tokens sind billiger": Sie umfasst, dass das Modell Aufgaben in weniger Schritten löst, seltener in Sackgassen läuft und weniger oft wiederholen muss. Ein Modell, das pro Token doppelt so viel kostet, aber eine Aufgabe in halb so vielen Aufrufen erledigt, ist in der Praxis das billigere Modell.
Zur Veranschaulichung (eigene Rechnung): Ein Agentenlauf mit 50 Aufrufen à 10.000 Eingabetokens und 2.000 Ausgabetokens kostet mit M3.1 Flash ohne Cache rund 0,14 Dollar. Gelingt dieselbe Aufgabe einem Modell zum doppelten Tokenpreis in nur 25 Aufrufen, kostet es 0,28 Dollar und ist trotz des „doppelt so teuren" Tokens unterm Strich gleich teuer, bei gleicher Quote gelöster Aufgaben aber schneller fertig. Genau diese Rechnung meint MiniMax, wenn das Unternehmen Preis und Leistung gemeinsam darstellt [1].
Die Ehrlichkeitsgrenze dieser Rechnung: MiniMax legt die Zusammensetzung der 70 Prozent nicht offen. Wie viel davon auf niedrigere Tokenpreise, wie viel auf weniger benötigte Schritte und wie viel auf höhere Cache-Trefferquoten entfällt, ist aus dem Veröffentlichungspost nicht abzulesen. Wer migrieren will, sollte die eigene Aufgabenmischung auf beiden Modellen laufen lassen und die Kosten pro gelöster Aufgabe vergleichen, nicht die Preisliste.
Die Cache-Ökonomie langer Agentenläufe
Der Cache-Preis von 0,015 Dollar pro Million Tokens liegt bei einem Zehntel des normalen Eingabepreises [1]. Das klingt nach einer Fußnote, ist aber die Stelle, an der lange Agentenläufe ökonomisch entschieden werden. Agenten schleppen ihren Kontext mit: Systemprompt, Werkzeugbeschreibungen, bisherige Beobachtungen. Bei jedem Aufruf wird fast dieselbe Eingabe erneut gesendet. Trifft der Cache, zahlt man dafür nur ein Zehntel.
Ein Rechenbeispiel (eigene Rechnung): Ein Wartungs-Agent arbeitet eine Stunde lang mit einem gewachsenen Kontext von durchschnittlich 200.000 Tokens und ruft das Modell 120-mal auf. Ohne Cache sind das 24 Millionen Eingabetokens zu je 0,15 Dollar, also 3,60 Dollar. Bei vollständiger Cache-Nutzung fallen 2,4 Millionen ungecachte und 21,6 Millionen gecachte Tokens an: 0,36 plus 0,32, zusammen rund 0,68 Dollar. Der Cache macht in diesem Beispiel 81 Prozent der Eingabekosten aus. Die tatsächliche Ersparnis hängt von der Trefferquote ab, die MiniMax nicht beziffert.
Für den Vergleich mit DeepSeek ist dieselbe Frage zu stellen: DeepSeek weist laut SiliconANGLE den gleichen Eingabepreis von 0,15 Dollar in Schwachlastzeiten aus [2]. Welche Cache-Preise und Trefferquoten dort gelten, geht aus der Modellkarte nicht hervor [5]. Wer die beiden Anbieter vergleichen will, misst am besten einen repräsentativen eigenen Lauf und vergleicht die Endabrechnung, nicht die Einzelpreise.
Ein Kontextfenster von einer Million Tokens, und was es kostet
Eine Million Tokens Eingabe entsprechen grob 700.000 bis 800.000 Wörtern, also mehreren dicken Büchern oder einem mittleren Code-Repository. Beide Modelle dieses Vergleichs, M3.1 Flash und DeepSeek V4.1 Flash, werben mit diesem Fenster [3][5]. Die Kosten für das Befüllen sind mit 0,15 Dollar pro Durchlauf überschaubar (eigene Rechnung). Die eigentliche Frage ist, wie zuverlässig die Modelle am Ende des Fensters noch arbeiten. Dazu gibt es von MiniMax keine Kennzahl. DeepSeek nennt in der Modellkarte immerhin die Testbedingungen seiner Langkontext-Evaluierungen, darunter Temperatur 1,0 und ein Limit von 500 Schritten pro Agent [5].
Praktischer Hinweis für eigene Tests: Ein volles Fenster bei jeder Anfrage zu senden ist selten sinnvoll. Bei 120 Aufrufen mit jeweils voller Million wären das 120 Millionen ungecachte Eingabetokens und damit 18 Dollar pro Stunde allein für die Eingabe (eigene Rechnung). Kontextmanagement, also das gezielte Kürzen, Zusammenfassen und Cachen, bleibt auch bei großen Fenstern eine eigene Ingenieursdisziplin.
Was „aggressivere Sparsamkeit" heißen könnte
MiniMax führt die höhere Geschwindigkeit auf „aggressivere Sparsamkeit" bei der Inferenz zurück, ohne Details zu nennen [1]. Was dahinter technisch stecken kann, zeigt der dokumentierte Fall: DeepSeek aktiviert bei V4.1 Flash pro Token nur 8 bis 16 Milliarden von 552 Milliarden Backbone-Parametern, quantisiert den KV-Cache nach FP4 und setzt auf spekulative Dekodierung [5]. Das sind die drei üblichen Stellschrauben für schnelle Inferenz großer Modelle: weniger aktive Parameter, komprimierter Kontextspeicher und paralleles Erraten mehrerer Tokens. Ob MiniMax denselben Weg geht, lässt sich ohne Modellkarte nicht prüfen. Die Kombination aus 428 Milliarden Gesamtparametern [2] und über 200 Tokens pro Sekunde [1] spricht aber dafür, dass pro Token nur ein kleiner Bruchteil des Modells rechnet (eigene Einschätzung).
Zur Veröffentlichungspraxis: Space Bunny noch einmal gelesen
Die Space-Bunny-Episode verdient einen zweiten Blick, weil sie zeigt, wie Modelltests 2026 funktionieren. MiniMax hat ein nicht fertiges Modell wochenlang unter neutralem Namen einem breiten Publikum ausgesetzt und dabei nach eigenen Angaben über 200 Billionen Tokens verarbeitet [1]. Für den Hersteller ist das wertvoll: echte Nutzungsdaten, ehrliche Vergleiche ohne Markenbonus, und eine Community, die selbst nach dem Urheber sucht. Für die Nutzerinnen und Nutzer bedeutet es, dass sie ungefragt Teil eines Feldversuchs waren. OpenRouter als Plattform ermöglicht solche anonymen Modelle ausdrücklich; wer dort experimentelle Modelle aufruft, sollte wissen, worauf man sich einlässt [2].
Zur Dimension der Zahl: 200 Billionen Tokens sind auch deshalb bemerkenswert, weil sie die Größenordnung zeigen, in der Agenten-Verkehr inzwischen gemessen wird. Zum Listenpreis für ungecachte Eingabe entsprächen sie 30 Millionen Dollar (eigene Rechnung, Obergrenze). Selbst wenn nur ein Bruchteil davon je abgerechnet worden wäre: Der anonyme Test war mit hoher Wahrscheinlichkeit das teuerste Qualitätssicherungsprogramm, das MiniMax für dieses Modell gefahren ist.
Einordnung
M3.1 Flash setzt die Entwicklung fort, die wir zuletzt bei Nemotron 3.5 Super und Lightning beschrieben haben: Modelle werden nicht nur besser, sondern vor allem billiger pro erledigter Aufgabe. MiniMax nennt Kostensenkung von 70 Prozent pro agentischer Aufgabe, nicht nur pro Token. Das ist die richtige Einheit, denn Agenten verbrauchen Tokens im Hintergrund. Sie ist aber auch die am schwersten prüfbare Angabe des Releases.
Die zweite Beobachtung betrifft die Veröffentlichungspraxis. Ein mehrwöchiger anonymer Großeinsatz unter falschem Namen, dann die offizielle Enthüllung: Das erzeugt Aufmerksamkeit und liefert echte Lastdaten. Es bedeutet auch, dass Nutzerinnen und Nutzer von OpenRouter wochenlang ein unbekanntes Modell bewertet haben, ohne es zu wissen. Man darf das geschicktes Marketing nennen, transparent ist es nicht.
Was noch offen ist
- Die angekündigten Gewichte: Lizenz, Format und Termin sind unbekannt.
- Die Modellkarte mit Architekturdetails, Trainingsdaten und Sicherheitsbewertung.
- Unabhängige Messungen der Benchmarkwerte, der Geschwindigkeit und der Kosten pro erledigter Aufgabe.
- Das angekündigte Pro-Modell.
Methode
Grundlage sind der Veröffentlichungspost von MiniMax, die Berichterstattung von SiliconANGLE, die Katalogseiten von AnyRouter und Vercel, die Modellkarte von DeepSeek V4.1 Flash und der Release-Tracker modeldrops.com, alle am 20. Oktober 2026 abgerufen. Alle Umrechnungen (Tokens pro Dollar, implizierter Vorgängerpreis, Beispielrechnungen zu Agentenläufen und Sprechzeiten) sind eigene Überschläge und im Text als solche gekennzeichnet. Wir haben das Modell nicht selbst ausgeführt. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Alle Benchmark-, Geschwindigkeits- und Kostenangaben zu M3.1 Flash sind Herstellerangaben und nicht unabhängig geprüft. Die Hugging-Face-Modellkarte war zum Abrufzeitpunkt nicht öffentlich (HTTP 401), Parameterzahl und Architekturdetails stammen daher aus Zweitquellen. Die Angabe von 428 Milliarden Parametern entstammt laut SiliconANGLE dem Entwicklerhandbuch der Vorschauversion. Preise können sich ändern. Der Vergleich mit DeepSeek V4.1 Flash beruht auf Herstellerangaben mit unterschiedlichen Testbedingungen. Keine eigenen Messungen.
Quellen
- MiniMax M3.1 Flash: Redefining Agent Performance and Cost, MiniMax (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- MiniMax launches M3.1 Flash model, says it cuts AI agent costs by 70%, SiliconANGLE (Duncan Riley) (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- MiniMax M3.1 Flash, AnyRouter (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- MiniMax M3.1 Flash now available on AI Gateway for free, Vercel (abgerufen 2026-10-20) ↩
- deepseek-ai/DeepSeek-V4.1-Flash (Modellkarte), Hugging Face (abgerufen 2026-10-20) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- AI Model Releases in October 2026, modeldrops.com (abgerufen 2026-10-20) ↩