 KI
Fünf Jahre lang galt in der KI-Forschung eine einfache Regel: Wer ein besseres Modell will, trainiert ein größeres. Seit etwa zwei Jahren verschiebt sich der Wettbewerb auf eine zweite Achse: Rechenzeit zur Antwortzeit, englisch Test-Time-Compute. Statt nur in das Training zu investieren, lassen Modelle sich beim Antworten mehr Zeit - sie denken länger nach, probieren mehrere Wege oder prüfen sich selbst. Dieser Artikel legt die Beleglage dar: von Chain-of-Thought über wiederholtes Sampling und Prozess-Bewerter bis zu DeepSeek-R1 und dem Minimalansatz s1. Alle Zahlen stammen aus den Originalpapieren, die wir geöffnet haben; eigene Umrechnungen sind als solche markiert.
Die zweite Skalierungsachse
Trainings-Skalierung ist gut vermessen: Mehr Parameter, mehr Daten, mehr Rechenzeit ergeben vorhersagbar bessere Modelle, die Scaling Laws und die Chinchilla-Skalierung beschreiben das. Test-Time-Compute kehrt die Logik um: Ein fertig trainiertes Modell wird nicht verändert, sondern darf pro Anfrage mehr rechnen - längere Zwischenschritte, mehrere Lösungsversuche, Suchverfahren. Die Kosten wandern damit von einer einmaligen Trainingsinvestition zu variablen Kosten pro Antwort. Die zentrale Forschungsfrage lautet: Wie viel Qualität kauft man sich mit jeder zusätzlichen Denksekunde, und wann lohnt sie sich mehr als ein größeres Modell?
Stufe 1: Chain-of-Thought, der Anfang
Den Anfang markiert das Chain-of-Thought-Paper von 2022: Gibt man einem ausreichend großen Modell einige Beispiele mit ausgeschriebenen Zwischenschritten vor, beginnt es selbst, in Zwischenschritten zu denken - und wird dadurch messbar besser. Mit nur acht solcher Beispiele erreichte ein 540-Milliarden-Parameter-Modell auf dem Mathe-Benchmark GSM8K damalige Bestwerte und schlug sogar ein extra darauf feinjustiertes GPT-3 mit Prüfmodell [1]. Die Erkenntnis war: Die Fähigkeit zum schrittweisen Denken steckt bereits in großen Modellen; man muss sie nur abrufen. Und der Abruf kostet Rechenzeit, denn die Zwischenschritte sind zusätzliche Token.
- Coverage: Der Anteil der Probleme, die mindestens einer von N Versuchen löst. Misst das Potenzial, nicht die Trefferquote einer einzelnen Antwort [2].
- Best-of-N: N Antworten erzeugen und mit einem Bewertungsmodell die beste auswählen - die naive Basislinie, die compute-optimale Verfahren schlagen müssen [4].
- Verifier / Prozess-Bewerter (PRM): Ein automatischer Richter. Ergebnis-Verifier prüfen nur die Endantwort; Prozess-Bewerter benoten jeden Denkschritt und sind als Suchrichter deutlich stärker [3].
- Budget Forcing: Laufzeit-Kontrolle der Denklänge: Denk-Ende erzwingen, wenn das Budget aufgebraucht ist, oder ein „Warte“ anhängen, wenn mehr Budget gewünscht ist [6].
Stufe 2: Viele Versuche und ein Richter
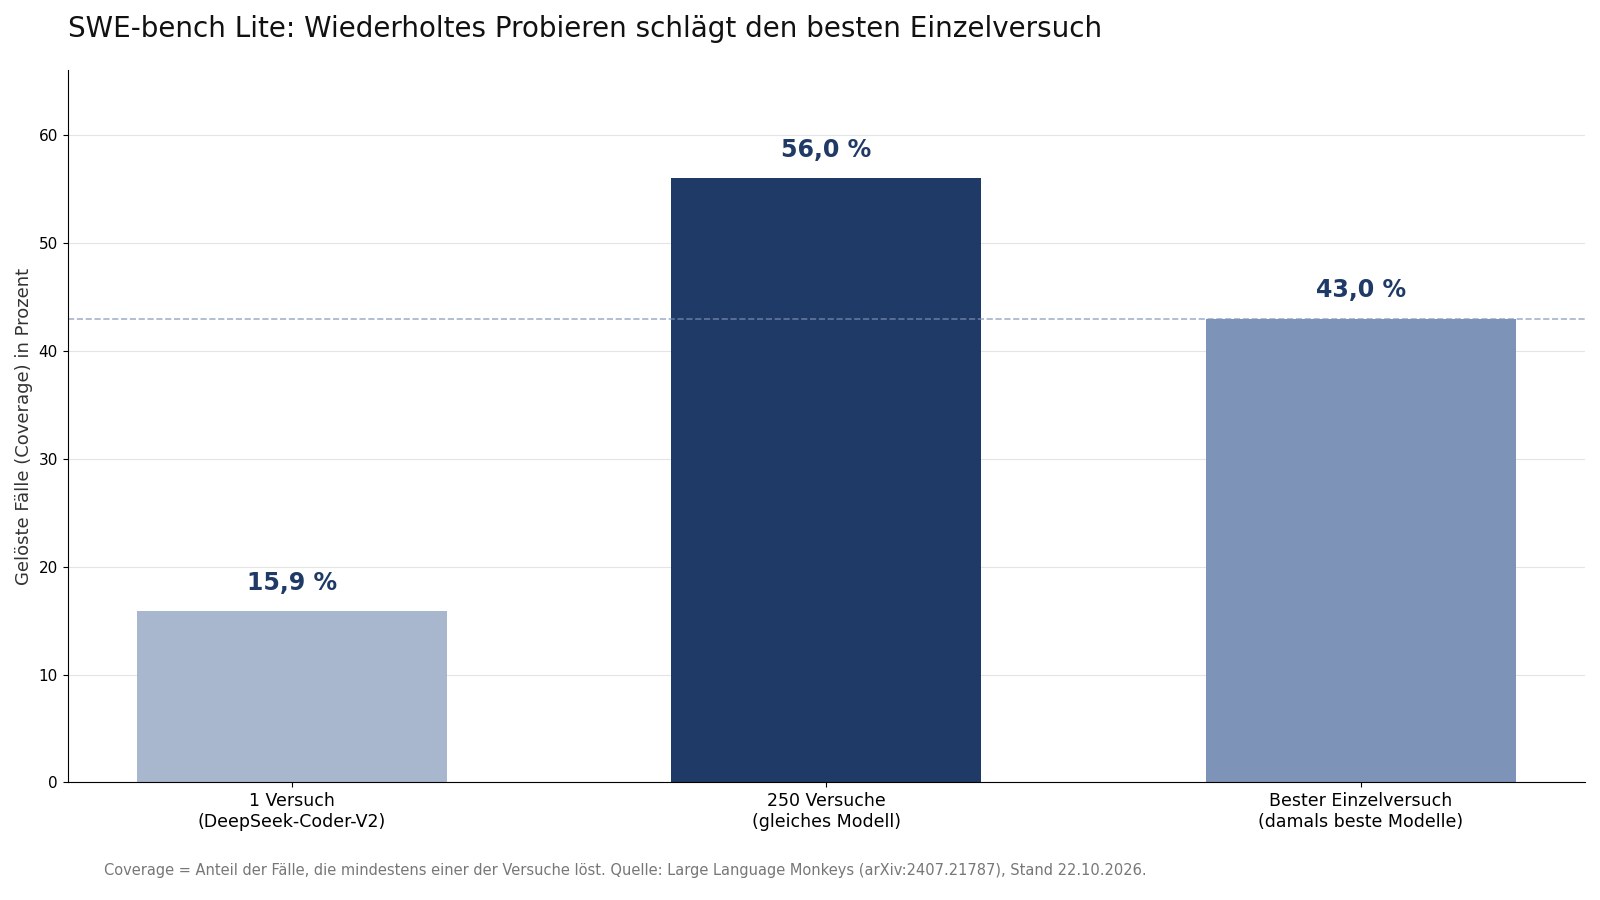
Die nächste Idee ist noch simpler: Statt einer Antwort gleich mehrere erzeugen. Die Studie Large Language Monkeys maß systematisch, wie die Trefferquote mit der Zahl der Versuche wächst. Ergebnis: Die sogenannte Coverage - der Anteil der Probleme, die mindestens einer der Versuche löst - wächst logarithmisch-linear über vier Größenordnungen der Versuchsanzahl, ein Verhalten, das sich als potenziertes Potenzgesetz beschreiben lässt [2]. Auf SWE-bench Lite stieg DeepSeek-Coder-V2-Instruct von 15,9 Prozent mit einem Versuch auf 56 Prozent mit 250 Versuchen - und überholte damit den damaligen Einzelversuch-Bestwert von 43 Prozent, der von weit stärkeren Modellen gehalten wurde [2].
Der Haken steckt im Auswählen: Coverage bedeutet nur, dass die richtige Antwort irgendwo in den 250 Versuchen steckt. Sie zu finden, braucht einen Richter. Wo Antworten automatisch prüfbar sind - Code mit Tests, Mathe mit Endwert, formale Beweise - übernimmt das ein automatischer Prüfer (Verifier), und die Coverage-Gewinne schlagen direkt in Leistung durch. Wo kein automatischer Richter existiert, zeigt dieselbe Studie das Plateau: Mehrheitsabstimmung und gelernte Bewertungsmodelle stagnieren jenseits einiger hundert Versuche und skalieren nicht mehr mit dem Versuchsbudget [2].
Wichtig ist die Feinheit des Befunds: Die Autoren sprechen deshalb von „Inference-Time Scaling Laws“: Die Beziehung zwischen Coverage und Versuchsanzahl ist häufig log-linear und lässt sich als potenziertes Potenzgesetz modellieren [2]. In Domänen mit automatischer Prüfung, etwa Programmierung und formale Beweise, übersetzt sich das eins zu eins in bessere Ergebnisse. In Domänen ohne Prüfer bleibt der Gewinn theoretisch: Er existiert in der Stichprobe, ist aber nicht aus ihr herausgreifbar [2].
Wie gut so ein Richter werden kann, zeigte OpenAIs Arbeit Let's Verify Step by Step: Ein Modell, das jeden einzelnen Denkschritt bewertet (Prozess-Aufsicht), schlug eines, das nur das Endergebnis beurteilt (Ergebnis-Aufsicht), deutlich - 78 Prozent gelöster Probleme auf einer repräsentativen Teilmenge des schwierigen MATH-Datensatzes. Zum Training diente der mitveröffentlichte Datensatz PRM800K mit menschlichen Schritt-Bewertungen [3]. Genau solche Prozess-Bewerter sind die Such-Richter der nächsten Stufe.
Stufe 3: Compute-optimal statt stur
Mehr Denkzeit hilft nicht pauschal. Die Google-Studie Scaling LLM Test-Time Compute Optimally verglich die beiden Hauptmechanismen - Suche gegen einen Prozess-Bewerter und schrittweises Überarbeiten der eigenen Antwort - und fand: Welcher Ansatz wie viel bringt, hängt entscheidend von der Schwierigkeit der Aufgabe ab [4]. Leichte Fragen sollte das Modell gar nicht lange bearbeiten, mittlere profitieren von Überarbeitung, nur die schwersten lohnen aufwendige Suche. Daraus leiteten die Autoren eine „compute-optimale“ Strategie ab, die pro Aufgabe entscheidet, wie viel und welche Art von Test-Time-Compute eingesetzt wird.
Die beiden Schlagzahlen der Studie: Compute-optimale Zuteilung ist bis zu viermal so effizient wie das naive Best-of-N-Verfahren [4]. Und in einem Vergleich bei gleichem Rechenaufwand schlug ein kleines Modell mit klug dosierter Denkzeit ein vierzehnmal größeres Modell ohne sie - allerdings nur auf Aufgaben, bei denen das kleine Modell eine nicht-triviale Erfolgsquote hatte; bei den schwersten Problemen blieb das größere Modell vorn [4]. Denkzeit ersetzt Parameter also nicht universell, sondern dort, wo das Basismodell die Lösung grundsätzlich erreichen kann.
Stufe 4: Reasoning antrainieren statt anfordern
Bis hierhin war mehr Denkzeit ein Trick zur Laufzeit. DeepSeek-R1 zeigte, dass man sie in die Modellpersönlichkeit hineintrainieren kann: Mit reinem Verstärkungslernen, ohne menschlich vorgeschriebene Denkvorlagen, entwickelte das Modell von selbst Verhaltensweisen wie Selbstreflexion, Verifikation und das dynamische Wechseln von Strategien - und übertraf damit auf prüfbaren Aufgaben wie Mathematik und Programmierwettbewerben Modelle, die auf menschlichen Demonstrationen überwacht gelernt hatten [5]. Die entstandenen Denkmuster ließen sich anschließend systematisch auf kleinere Modelle übertragen [5]. Damit war das Rezept öffentlich, das hinter OpenAIs o1 vermutet wurde, dessen Methode nie veröffentlicht wurde [6].
Zwei Details des R1-Papers sind für die Einordnung wichtig. Erstens der Adressat der Methode: Verstärkungslernen dieser Art braucht Aufgaben mit prüfbarem Ausgang; das Paper spricht von Mathematik, Programmierwettbewerben und STEM-Feldern, nicht von offenem Schreiben [5]. Zweitens die Weitergabe: Die im großen Modell entstandenen Denkmuster dienten als Lehrmaterial für kleinere Modelle - Reasoning wurde damit zu etwas Destillierbarem statt zu einer Eigenschaft, die nur sehr große Modelle besitzen [5].
Stufe 5: Der Minimalbeweis mit 1.000 Beispielen
Wie wenig Aufwand nötig ist, um Test-Time-Skalierung sichtbar zu machen, zeigte das s1-Projekt. Das Rezept besteht aus zwei Zutaten: einem Datensatz von nur 1.000 sorgfältig nach Schwierigkeit, Vielfalt und Qualität kuratierten Fragen mit Denkspuren, und „Budget Forcing“ - einer Laufzeit-Kontrolle, die das Modell zum Weiterdenken zwingt, indem sein Denk-Ende blockiert und stattdessen ein „Warte“ angehängt wird [6]. Das angehängte Wort treibt das Modell zum Gegenprüfen, was nach Beobachtung der Autoren häufig fehlerhafte Denkschritte korrigiert.
Die Ergebnisse: s1-32B, ein auf diese Weise nachtrainiertes Qwen2.5-32B, übertraf OpenAIs o1-preview auf Wettbewerbsmathematik um bis zu 27 Prozent (MATH und AIME24). Durch Hochdrehen des Denkbudgets stieg die AIME24-Trefferquote von 50 auf 57 Prozent - ein echter Skalierungseffekt zur Laufzeit, also bessere Ergebnisse allein durch längeres Denken [6]. Modell, Daten und Code sind offen [6].
- Ohne Eingriff
- Mit Budget Forcing
Daten als Tabelle
| Ohne Eingriff | Mit Budget Forcing | |
|---|---|---|
| AIME24 | 50Prozent | 57Prozent |
Test-Time-Skalierung im Realfall: allein das Erzwingen längerer Denkphasen hebt die Trefferquote um sieben Punkte. Quelle: s1-Paper [6].
Die Grenzen: Wann Denkzeit nichts bringt
Die Studien sind sich in der negativen Richtung bemerkenswert einig. Die compute-optimale Analyse fand, dass auf den schwersten Problemen zusätzliche Denkzeit gegenüber einem größeren Modell verliert - dort, wo das Basismodell die Lösung grundsätzlich nicht erreicht [4]. Die Sampling-Studie fand das Auswahlplateau ohne Verifier [2]. Und s1 zeigt im Kleinen dieselbe Logik: Budget Forcing wirkt, weil das Modell bereits Denkspuren gelernt hat; bei einem Modell ohne diese Basis bliebe das angehängte „Warte“ wirkungslos [6]. Mehr Zeit ist ein Multiplikator vorhandener Fähigkeit, kein Ersatz für sie.
Was das für Kosten und Praxis bedeutet
Drei Konsequenzen für den Alltag mit Modellen. Erstens werden Inferenzkosten variabel und aufgabenabhängig: Dieselbe Frage kann zehnmal so viel kosten, wenn das Modell länger denkt - Kosten pro Antwort statt Kosten pro Modell. Wer das kalkuliert, findet die Mechanik in unserem Inferenz-Kosten-Grundkurs und dem KV-Cache-Deep-Dive. Zweitens entscheidet der Prüfer über den Nutzen: Mit automatischem Verifier - Tests, Compiler, Endwert - skaliert wiederholtes Probieren fast ohne Deckel [2]; ohne Verifier flacht der Gewinn schnell ab [2][3]. Drittens gehört Schwierigkeits-Routing zur Infrastruktur: Leichtes schnell beantworten, Schweres suchen lassen - genau das ist die compute-optimale Strategie [4] und zugleich die Bauanleitung der aktuellen einstellbaren Reasoning-Modelle.
| Stufe | Idee | Belegter Kernbefund | Quelle |
|---|---|---|---|
| Chain-of-Thought (2022) | Zwischenschritte vormachen | 8 Beispiele heben 540B-Modell auf GSM8K-Bestwert, schlägt feinjustiertes GPT-3 mit Verifier | [1] |
| Wiederholtes Sampling (2024) | Viele Versuche erzeugen | Coverage log-linear über 4 Größenordnungen; 15,9 % auf 56 % bei 250 Versuchen; ohne Verifier Plateau jenseits einiger hundert Versuche | [2] |
| Prozess-Bewerter (2023) | Jeden Schritt benoten | Prozess-Aufsicht schlägt Ergebnis-Aufsicht deutlich; 78 % auf MATH-Teilmenge; PRM800K offen | [3] |
| Compute-optimale Zuteilung (2024) | Denkzeit nach Schwierigkeit dosieren | Bis zu 4-mal effizienter als Best-of-N; kleines Modell schlägt 14-mal größeres bei FLOPs-Gleichstand | [4] |
| Reasoning-Training und Minimalismus (2025) | Denkverhalten antrainieren, dann dosieren | R1: Selbstreflexion emergent aus reinem RL; s1: 1.000 Beispiele plus Budget Forcing, 50 auf 57 % AIME24 | [5] [6] |
Bleibt die Einordnung: Test-Time-Compute ist kein Ersatz für gute Basismodelle, sondern ein Multiplikator mit Sollbruchstelle - dort, wo das Modell keine Route zur Lösung mehr findet, hilft auch längeres Denken nicht, und die Studien zeigen genau diese Grenze [4][6]. Aber innerhalb dieser Grenze hat sich die Frage „wie stark ist das Modell“ in zwei Fragen aufgeteilt: wie stark es trainiert ist - und wie lange es nachdenken darf.
Methode
Grundlage sind sechs Originalpapiere (Chain-of-Thought, Large Language Monkeys, Let's Verify Step by Step, Scaling Test-Time Compute, DeepSeek-R1, s1), deren arXiv-Seiten am 22. Oktober 2026 geöffnet wurden; die zitierten Kennzahlen stammen aus den Abstracts und zugänglichen Volltext-Auszügen. Eigene Rechnungen: (1) Versuche pro Coverage-Punkt = 250 Versuche für 40,1 Punkte, also gut 6 Versuche pro Punkt; (2) s1-Nachtraining = 16 H100 x 26/60 Stunden = rund 6,9 GPU-Stunden; (3) s1-AIME24-Delta = 57 minus 50 = 7 Prozentpunkte. Alle als eigene Rechnung gekennzeichnet.
Grenzen
- Die starken Befunde konzentrieren sich auf Mathematik, Code und formale Beweise - also Domänen mit automatischem Prüfer; auf offene Aufgaben ohne Verifier lassen sie sich nicht übertragen [2].
- Coverage ist nicht Antwortqualität: Dass die richtige Lösung unter 250 Versuchen ist, heißt nicht, dass das System sie erkennt [2].
- OpenAIs o1-Methodik ist nicht öffentlich; Aussagen darüber stammen aus Sekundärquellen wie dem s1-Paper [6].
- Die zitierten Studien stammen aus den Jahren 2022 bis 2025; Benchmark-Referenzpunkte wie der Einzelversuch-Bestwert von 43 Prozent auf SWE-bench Lite sind zwischenzeitlich überholt.
Quellen
- Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, arXiv:2201.11903 (abgerufen 2026-10-22) ↩1 ↩2
- Large Language Monkeys: Scaling Inference Compute with Repeated Sampling, arXiv:2407.21787 (abgerufen 2026-10-22) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Let's Verify Step by Step, arXiv:2305.20050 (abgerufen 2026-10-22) ↩1 ↩2 ↩3 ↩4
- Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters, arXiv:2408.03314 (abgerufen 2026-10-22) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, arXiv:2501.12948 (abgerufen 2026-10-22) ↩1 ↩2 ↩3 ↩4 ↩5
- s1: Simple test-time scaling, arXiv:2501.19393 (abgerufen 2026-10-22) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6