 KI
Forschung
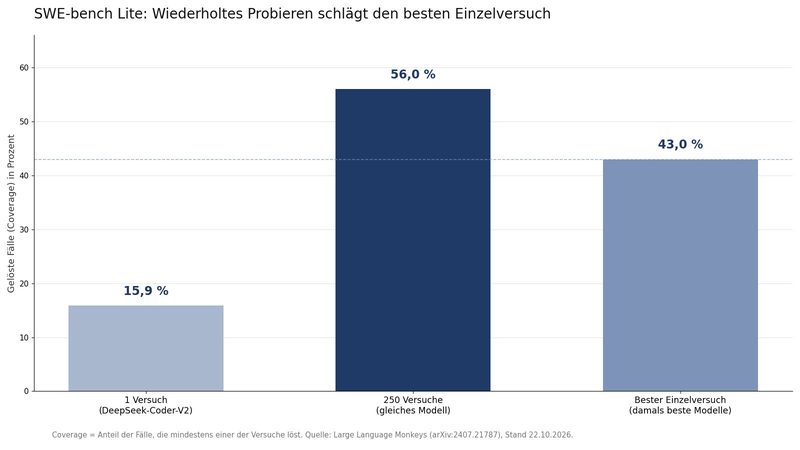
Test-Time-Compute: Die zweite Skalierungsachse der KI
Erst Chain-of-Thought, dann Verstärkungslernen, jetzt Budget Forcing: Warum Modelle mit mehr Denkzeit besser werden - und was die Forschung dazu belegt.
Lesen →
Erst Chain-of-Thought, dann Verstärkungslernen, jetzt Budget Forcing: Warum Modelle mit mehr Denkzeit besser werden - und was die Forschung dazu belegt.