 KI
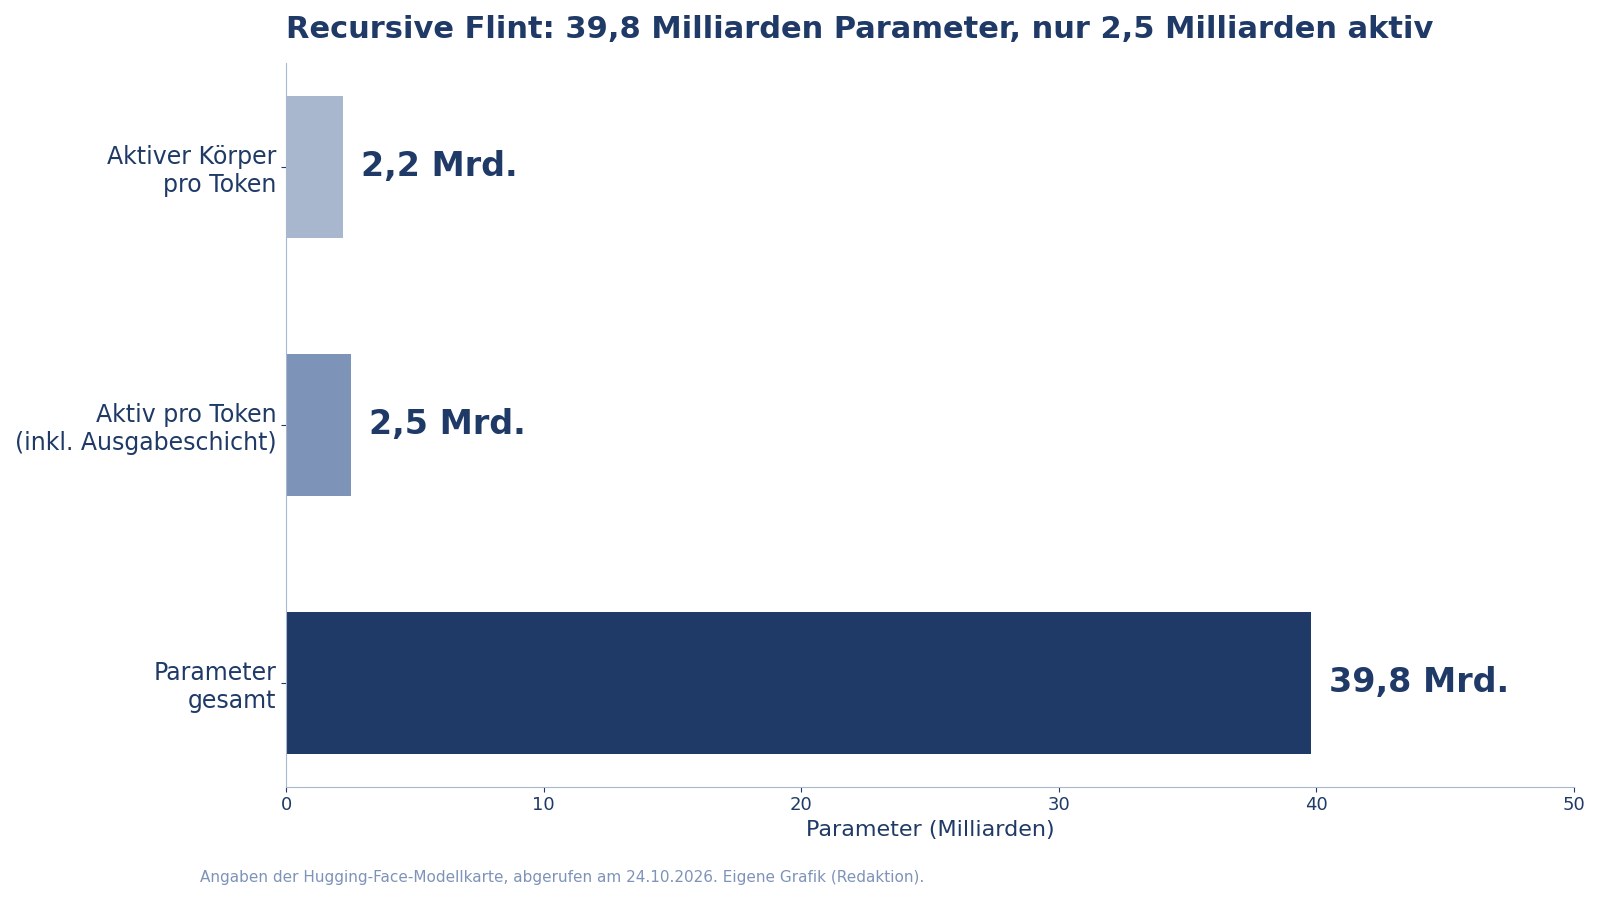
Mit Recursive Flint ist diese Woche ein Coding-Modell erschienen, das einen anderen Weg geht als die Frontier-Klasse: 39,8 Milliarden Parameter insgesamt, aber nur rund 2,5 Milliarden aktiv pro Token, Apache-2.0-Gewichte auf Hugging Face und das Versprechen, auf einem MacBook Pro über 125 Token pro Sekunde zu erreichen [1][2]. Entwickelt hat es ein kleines Team des Unternehmens Recursive in unter vier Monaten - maßgeblich mit Hilfe der eigenen „Eureka Machine“, eines Systems für automatisierte KI-Forschung [2]. Dieser Artikel legt die Modellkarte offen: Was ist belegt, was ist Herstellerangabe, für wen ist das Modell gedacht?
Architektur: extrem sparsam aktiviert
Flint ist ein Decoder-only-Transformer mit Mixture-of-Experts-Aufbau: 49 Schichten (zwei dichte, dann 47 MoE-Schichten), 256 routbare Experten pro MoE-Schicht, von denen pro Token sechs gewählt werden, plus ein stets aktiver gemeinsamer Experte [1]. Die Aktivparameter liegen bei rund 2,5 Milliarden inklusive Ausgabeschicht; der aktive Modellkörper allein kommt auf etwa 2,2 Milliarden - „40B-A2.5B“ ist die gerundete Größenbezeichnung [1].
Bei der Attention mischt Flint 35 Sliding-Window-Schichten (Fenster: 513 Token) mit 14 Vollattention-Schichten; 32 Abfrageköpfe teilen sich 4 Schlüssel-Wert-Köpfe, dazu kommen pro Kopf eine QK-RMSNorm und gelernte Attention-Sinks [1]. Das dokumentierte Kontextfenster umfasst 262.144 Token inklusive Prompt und Ausgabe [1]; Recursive spricht auf der Ankündigungsseite von bis zu 512.000 Token, empfiehlt aber, für beste Ergebnisse innerhalb von 256.000 zu bleiben [2]. Der angegebene Wissensstand ist Juni 2026 [1].
| Merkmal | Angabe |
|---|---|
| Parameter gesamt / aktiv | 39,8 Mrd. / ~2,5 Mrd. pro Token (Körper ~2,2 Mrd.) |
| Aufbau | 49 Schichten: 2 dicht + 47 MoE; 256 Experten, 6 aktiv + 1 geteilter |
| Attention | 35 Sliding-Window- (513 Token) + 14 Vollattention-Schichten; 32 Q-/4 KV-Köpfe |
| Kontext | 262.144 Token dokumentiert; Hersteller empfiehlt ≤ 256.000 |
| Wissensstand | Juni 2026 |
| Checkpoint | BF16 (~80 GB), quantisierte Varianten für NVIDIA und Apple Silicon |
| Lizenz | Apache 2.0 |
| Downloads im letzten Monat | 1.904 (Stand 24.10.2026) |
Gemessene Leistung - und ihre Fußnoten
Auf der Modellkarte meldet Recursive drei zentrale Werte: 54,9 Prozent auf Terminal-Bench 2.1, 89,7 Prozent auf SWE-bench Pro v2 und 74,2 Prozent auf SWE-bench Verified [1]. Das Vorgehen ist ungewöhnlich genau dokumentiert: Temperatur 1,0, Top-p 0,95, Top-k 20; Terminal-Bench mit dem Terminus-2-Harness, SWE-bench mit mini-swe-agent; Agenten-Werte als mittleres Pass@1 über mindestens fünf Versuche [1]. Zwei Einschränkungen nennt die Karte selbst: Vergleichswerte anderer Modelle sind „developer-reported“, also den jeweiligen Herstellerangaben entnommen, und Flints Terminal-Bench-Wert wertet Lösungen, die über Websuche zustande kamen, als nicht erfolgreich - eine Strenge, die fremde Werte nicht unbedingt teilen [1].
Daten als Tabelle
| Pass@1 in Prozent | |
|---|---|
| Terminal-Bench 2.1 | 54,9 |
| SWE-bench Pro v2 | 89,7 |
| SWE-bench Verified | 74,2 |
Herstellerangaben von der Modellkarte; jeweils mittleres Pass@1 über mindestens fünf Versuche, Temperatur 1.0 / Top-p 0.95 / Top-k 20. Terminal-Bench wertet per Websuche gefundene Lösungen als nicht erfolgreich. Quelle [1].
Zur Einordnung: Recursive positioniert Flint als bestes MoE-Modell unter 50 Milliarden Gesamtparametern auf agentischen Coding-Benchmarks und gibt an, die Coding-Leistung dichter Modelle mit 25 bis 40 Milliarden Parametern zu erreichen - bei mehr als fünffacher Geschwindigkeit [2]. Das sind Herstellerangaben; eine unabhängige Replikation steht mit knapp 2.000 Downloads im ersten Monat noch aus [1].
Tempo durch Quantisierung und eigene Kernel
Die Geschwindigkeitsangaben - über 125 Token pro Sekunde auf einem MacBook Pro mit M4 Pro, über 150 auf einer 64-GB-NVIDIA-RTX-Spark bei kurzen Kontexten - erklärt Recursive mit dem Zusammenspiel aus wenigen Aktivparametern, Quantisierung und maßgeschneiderten Kerneln [2]. Ungewöhnlich: Die Eureka Machine quantisierte entgegen der üblichen Praxis auch die Ausgabeschicht (lm_head) auf 4 Bit - bei nur 2,5 Milliarden Aktivparametern mache die Ausgabeschicht einen großen Teil der pro Token gelesenen Gewichte aus [2]. Um die Genauigkeit zu halten, folgte eine Offline-Destillation, in der das quantisierte Modell an eigenen, vorgesampelten Antworten mit dem 16-Bit-Modell als Lehrer nachtrainiert wurde; das habe die Trainingsschritte gegenüber der quantisierungsbewussten Basislinie fast halbiert [2]. Das quantisierte NVFP4-Modell liege über alle Benchmarks gerechnet innerhalb von 0,7 Punkten des 16-Bit-Modells (Herstellerangabe) [2].
Für Apple-Chips der Generationen M4 und M5 erzeugte das System laut Recursive einen Metal-Megakernel, der den gesamten Decode-Vorwärtsdurchlauf in einem einzigen Kernel verschmilzt [2]. Betreiben lässt sich Flint über llama.cpp, Ollama, Unsloth, LM Studio, vLLM und SGLang; Recursive veröffentlicht zusätzlich „rec“, eine eigene schlanke Inferenz-Engine für M4- und M5-Macs [2].
Gebaut von einer Maschine, die Forschung baut
Das zweite Thema dieses Releases ist der Entstehungsprozess: Recursive beschreibt die Eureka Machine als System, das den Forschungskreislauf automatisiert - Ideen vorschlagen, implementieren, testen und aus den Ergebnissen die nächsten Versuche ableiten [2]. An Flint habe sie von Daten über Optimierer und Trainingsrezepte bis zu Infrastruktur und Inferenzleistung mitgearbeitet; die Architektur (40 Milliarden total, 2,5 Milliarden aktiv) sei das Ergebnis ihrer Suche über verschiedene Expertenkonfigurationen, ausgehend von einer Basislinie mit 35 Milliarden total und 3 Milliarden aktiv [2]. „Unser kleines Team aus Menschen und Agenten“ habe Flint in unter vier Monaten von Grund auf gebaut [2]. Das ist eine Herstellererzählung ohne unabhängige Bestätigung - aber ein konkretes, überprüfbares Artefakt: Das Modell existiert, die Gewichte liegen offen, die Messungen sind dokumentiert.
Für wen ist Flint gedacht?
Die Modellkarte selbst ist erfrischend nüchtern: Flint solle Codebases untersuchen, Fehler beheben, Features implementieren und Tests schreiben - lokal, ohne dass Daten den eigenen Rechner verlassen [1]. Für komplexe Aufgaben empfiehlt Recursive, die Arbeit in kleinere Teilaufgaben zu zerlegen und explizite Anweisungen zu geben; das Modell brauche möglicherweise mehr Führung als große geschlossene Coding-Modelle [2]. Zur Ausgabebudgetierung rät die Karte bei schweren Problemen zu mindestens 32.768 Tokens inklusive Reasoning, und sie warnt selbst: Langes Reasoning kann das Budget aufbrauchen, bevor die Antwort fertig ist, und die Kontextkonfiguration sei eine Kapazitätsgrenze, keine Genauigkeitsgarantie über alle Längen [1].
Der BF16-Checkpoint beansprucht rund 80 Gigabyte; für den vorgesehenen SGLang-Betrieb genügt laut Karte eine B300- oder H200-GPU pro Replik [1]. Wer keine solche Karte hat, ist auf die quantisierten Varianten für NVIDIA- und Apple-Silicon-Laufzeiten angewiesen, die separat vorbereitet werden [1] - genau hier liegt die Zielgruppe: lokale Coding-Agenten auf Workstation-Hardware, als Offline- und Datenschutz-Alternative zur API. Über Ollama ist das Modell seit dieser Woche ebenfalls verfügbar; die dort angebotene quantisierte Variante kommt auf rund 23 Gigabyte [3].
Methode
Grundlage sind die Hugging-Face-Modellkarte (Architektur, Benchmark-Werte mit Messbedingungen, Limitationen) und die Ankündigungsseite von Recursive (Geschwindigkeit, Quantisierungsverfahren, Eureka Machine), beide am 24. Oktober 2026 abgerufen. Die Benchmark-Darstellung übernimmt die Kartenwerte unverändert; Geschwindigkeits- und Prozessangaben sind als Herstellerangaben gekennzeichnet. Keine eigenen Messungen.
Grenzen
Alle Leistungs-, Geschwindigkeits- und Prozessangaben stammen vom Hersteller und sind nicht unabhängig repliziert; Vergleichswerte anderer Modelle auf der Karte sind ebenfalls Herstellerangaben der jeweiligen Anbieter. Die Terminal-Bench-Wertung (Websuche zählt als nicht erfolgreich) erschwert den direkten Vergleich mit anders gewerteten Läufen. Das Modell ist sehr neu (rund 1.900 Downloads im ersten Monat), Praxisberichte fehlen noch.