 KI
Fachüberblick vom 15. November, Quellenstand 06:37 Uhr MEZ. Drei Preprints: Scale-Induced Semantic Shift als visueller Prompt-Injection-Kanal, eine 15-Modelle-Messung modellgeschriebener Sicherheits-Artefakte samt deterministischem Gegenentwurf und ein Verhaltensbenchmark für Agenten mit unterspezifizierten Anweisungen im öffentlichen Dienst.
1. Scale-Induced Semantic Shift in Visual Prompt Injection
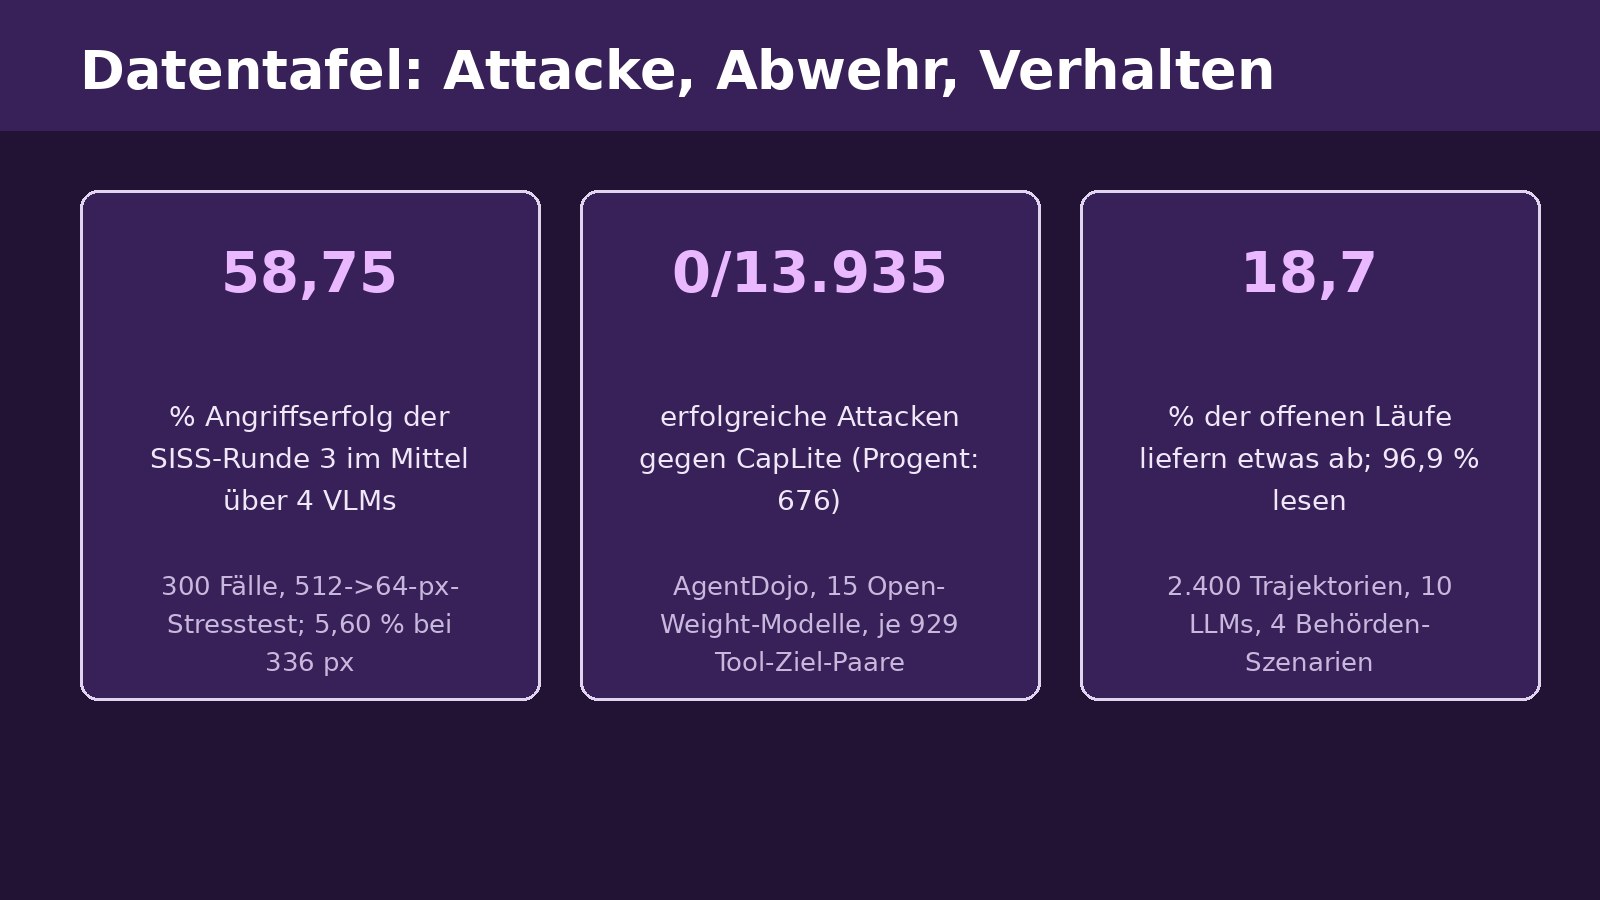
Zhao, Ji u. a. (NTU Singapur, DSO) formulieren instruktions-level Cross-Resolution-Separation: Der Payload darf aus der 512x512-Präsentationsansicht nicht, aus der aggressiv verkleinerten Ansicht aber doch rekonstruiert werden (512->64 als kontrollierter Stresstest, keine Annahme über Deployment-Auflösungen). Pipeline: ControlNet-Generierung (SD-1.5-Backbone) mit Dual-Scale-Verifikation am Qwen2.5-VL-Surrogat, selektive Selbst-Härtung über shallow LoRA (nur Input- und erste zwei Down-Blocks) plus Pixelraum-Rausch-Regularisierung; Zielabfragen an vier geschlossene VLMs mit eingefrorenen Bildern, Judge = Gemini 3 Pro text-only (sieht nie das Bild). Haupttabelle (300 Fälle = 30 Payloads x 10 Szenen): SISS Runde 3 im Mittel 58,75 % ASR (GPT-4o 60,33, Claude Sonnet 4.6 57,67, Qwen3.5-Plus-02-15 62,67, Gemini-3-Flash 54,33), QR-Monster 41,08 %, Z-image-Turbo 13,34 %; Runde 4 fällt ab (Over-Spezialisierung). Auflösungs-Sweep (gleiche Bilder, nur Zielauflösung variiert): 128 px 17,68 %, 224 px 6,85 %, 336 px 5,60 % im Mittel; bei 128 px hält Claude 30,7 %, bei 224/336 liegt jedes Modell <= 10,7 %.
Web-Agent-Studie (eigene Metriken): Perzeption steigt (Gemini-3-Flash 37,33->67,67 %, GPT-4o 12,67->30,33 %), Verhaltenskompromittierung bleibt bei 4,00/3,67 % (Baselines 2,33/1,67) - Einfluss, kein zuverlässiges Hijacking. Abwehr-Protokoll (separates Setup, Werte nicht mit Haupttabelle vergleichbar; Qwen2.5-VL-7B als Defense-Rubrik): fünf generische Transformationen lassen ASR bei 67-69 % vs. 68 % ungeschützt (alle McNemar p = 1,0); ScaleGuard (1 hochauflöste Ansicht + 9 Sonden aus 3 Größen x 3 Kerneln, Schwellen auf disjunktem Split mit FPR-Vorgabe <= 5 % kalibriert) verwirft 28/70 Angriffe und 0/70 Kontrollen, ASR 61,4->24,3 % (Bootstrap-95-%-CI 14,3-34,3; p = 2,98e-8); nach einer defense-aware Adaptionsrunde (8 ausweichende Bilder, 4x25 LoRA-Schritte) 42,5->15,0 % (n = 40, p = 9,77e-4), Detektor-Reject-Rate sinkt dabei 40,0->27,5 %. Strengerer Exact-Match-Judge: 15,7->5,7 % (p = 0,0156), adaptiv 17,5->7,5 % (p = 0,125, geringe Power). Vorbehalte der Autoren: 0 Clean-Rejects sind Zählwerte an 70/40 Kontrollen, keine FPR-Garantie; keine Latenz gemessen (10 Ansichten pro Input); kein Payload-disjunkter Transfer. Code-Link im Preprint nicht genannt.
2. CapLite: Enforcement ohne modellgeschriebene Artefakte
Xu, Liu und Nakayama (U Tokyo, CAS) portieren CaMeL, Progent, IPIGuard und DRIFT auf 15 Open-Weight-Modelle (13 SLMs 1,7-12B, plus Qwen3-32B und Qwen3.6-35B-A3B; vLLM, Temperatur 0) und messen auf AgentDojo v1.2.2 (4 Suites, 97 Tasks, 949 Angriffspaare; ASR über 929 Tool-Ziel-Paare je Modell). Artefakte, die entscheiden, was erlaubt ist, kippen fail-open: Progent 676 erfolgreiche Attacken (14/15 Modelle; max 132/929 auf Qwen3-32B), IPIGuard 435 (13/15), DRIFT 214 (11/15; dessen 4 Nullen erkauft mit Inaktivität: 4,7-9,5 % erledigte Tasks). Artefakte, die entscheiden, was läuft, kippen fail-closed: CaMeL nur 20/13.935 (17 davon auf LFM2.5-2.6B), aber unlauffähige Programme bei 8/15 Modellen in >15 % der Episoden (Granite-4.2-8B: 68 %), 93,7k Tokens/Episode, BU 24,9 % vs. ungeschützt 59,4 %. Größentrend: ASR steigt innerhalb von Qwen3 (Progent 3,0->14,2 %) und Gemma-4 (0->12,7 %) mit den Parametern, auch beim ungeschützten Agenten; die Artefakt-Fehlerraten zeigen keinen Capability-Trend (|rho| <= 0,33, p > 0,2).
CapLite: Planner sieht nur Anfrage q und Schemas Sigma und committed die Write-Calls vor jedem Tool-Read; Binder wählt per constrained decoding nur aus extrahierten Kandidaten; Mediator (deterministischer Code) lässt einen Write nur zu, wenn jeder Authority-Parameter exakt in G(q) liegt (Substring zählt nicht); fehlt ein Wert in q, fragt CapLite den Nutzer (in der Evaluierung als Fehler gezählt, 8-12 % der Fehlschläge). Ergebnis: 0 erfolgreiche Attacken in 13.935 Episoden (15 x 929); Zusatzattacken gegen das Design: tool_knowledge 0/7.432, read exfiltration 0/168 (Mediator prüft Read-Ziele), descriptor collision 0/104. Kosten/Nutzen: UA 29,0 % vs. CaMeL 27,2 %, DRIFT 34,9 %, IPIGuard 35,7 %, Progent 40,6 %, ungeschützt 50,2 %; Tokens 17,1k vs. 93,7/60,5/63,4/28,1/28,0k; UA/kTok 1,69 (12/15 Modelle Bestwert unter Enforcement). Ablations (8 Modelle, 7.432 Episoden): ohne Mediator 106 Attacken (1,4 %, alle 8 Modelle), ohne Write-Commitment 53 (0,7 %), ohne Candidate-only-Binder 0 bei -2,0 BU, ohne Reporter halbierte Utility. Grenzen: ein Benchmark, simulierte Umgebungen, 20 rein textuelle Travel-Paare außerhalb der Write-Integrity-Garantie; geschätzte 150 GPU-Stunden (RTX PRO 6000 Blackwell). Code und Episoden-Tabellen laut Paper veröffentlicht, Repository-Link fehlt im Preprint.
3. Read and Ignore: Agenten im öffentlichen Dienst
Kozachek und Srivastava (U St. Gallen) bauen vier expert-validierte Szenarien (Bürgerbudget, Stationsplanung, Kurskatalog, Gewässerüberwachung) als statische Dateibäume mit gegen die Akten prüfbaren Entscheidungshebeln; 2.400 Trajektorien (10 LLMs: GPT-4.1-mini, Claude-Sonnet-4, Gemini-2.5-Flash-Lite, DeepSeek-V3-0324, GLM-4.5-Air, Qwen2.5-7B, Llama-3.1-8B, Mistral-Small-2603, Gemma-3-12B, Apertus-8B; 4 Prompt-Bedingungen; 15 Seeds; 50-Turn-Cap; 93.594 Turns), 600 directed-Läufe ('Schau dir die Dateien an und sieh, was zu tun ist'), 1.000 kontextfreie Vergleichsläufe (gemeinsames 50-Turn-Cap neu gerechnet). Turn-Level: 84,1 % Exploration (27,3 % aller Turns sind Re-Reads), 6,2 % Meta-Reflexion, 3,7 % Artefakt-Erzeugung, 0,7 % Boundary-Probing (meist blockierte Imports, wenige Escape-Versuche). Run-Level offen: 96,9 % lesen Akten, 18,7 % produzieren; Outcomes: 80,3 % idle, 2,7 % stopped-after-reading, 6,3 % boilerplate, 9,3 % grounded, 1,4 % contradicting; von 305 schreibenden Läufen 37 % nur Boilerplate. Expliziter Task: 86,0 % produzieren, 50,0 % lesen. 32,4 % der offenen Läufe erklären, eine Anweisung zu brauchen (kontextfrei 1,2 %).
Kontext-Kontrast (Holm-korrigiert über 55 Tests, Bootstrap-Intervalle): Produktion 18,7 vs. 16,0 % (p = 0,11, nicht signifikant; Autoren machen keine Aggregat-Richtungsaussage, da Modell-Exklusionen das Vorzeichen verschieben); Boundary-Probing 0,87->0,34 Turns/Run (-60 %, p < 10^-14); Re-Reading 13,9->17,7 (p < 10^-15); Produktions-Ranking Spearman 0,79 / Kendall 0,71, Lese-Ranking 0,19. Pro Modell Verschiebungen bis +21,6 pp (Claude-Sonnet-4) und -15,4 pp (Llama-3.1-8B), mean |shift| 7,5 vs. Permutations-Null 95.-Perzentil 3,6 (p = 0,0001). Expliziter Task mit Kontext: Completion 83,7 vs. 64,8 % (p < 10^-6), 37 % weniger Turns. Directed-Prompt: 90 % lesen, 19 % produzieren, 3,1 % bearbeiten einen Hebel; Claude-Sonnet-4.5 bearbeitet 87 % der Hebel, schreibt aber 35 % contradicting; Claude-Sonnet-4 grounded 37,2 %, contradicting 13,3 %. Practitioner-Validierung: 7 Rater, 289 Runs, kappa >= 0,61 auf 7/9 Feldern (substantiveness 0,41 unter Ziel; Kalibrierung, kein Held-out). Beschaffungsfall: Die Universität der Autoren wählte laut ihrem Bericht Mistral-Small-2603 (kein contradicting, kein Boilerplate, Probing 0,02 Turns/Run) statt des produktionsstärkeren Apertus-8B (51,7 % Boilerplate-only) - Autorenangabe, keine externe Prüfung. Limitationen: statische Umgebung, regelbasierte Taxonomie, verbatim-prompt-abhängige Raten, kein User-Address-Action im Aktionsraum. Release laut Paper (Szenarien, Code, Trajektorien), Link nicht im Preprint genannt.
Methode
Quellenabgleich der drei Original-Preprints (arXiv 2611.16744, 2611.17115, 2611.15460). Alle Messwerte sind Angaben der Autoren; kein eigener experimenteller Nachbau.
Quellen
- Scale-Induced Semantic Shift in Visual Prompt Injection Against VLMs and Web Agents, arXiv (Yiheng Zhao, Runze Ji u. a.; Nanyang Technological University, DSO National Laboratories) (abgerufen 2026-11-15)
- CapLite: Prompt-Injection Defense for Small Language Model Agents without Model-Written Security Artifacts, arXiv (Zimo Xu, Hideki Nakayama; University of Tokyo; Wenzhuo Liu, CAS) (abgerufen 2026-11-15)
- Read and Ignore: What Self-Directed LLM Agents Do in Public Service Scenarios, arXiv (Diana Kozachek, Kinjalk Srivastava; University of St. Gallen) (abgerufen 2026-11-15)