 KI
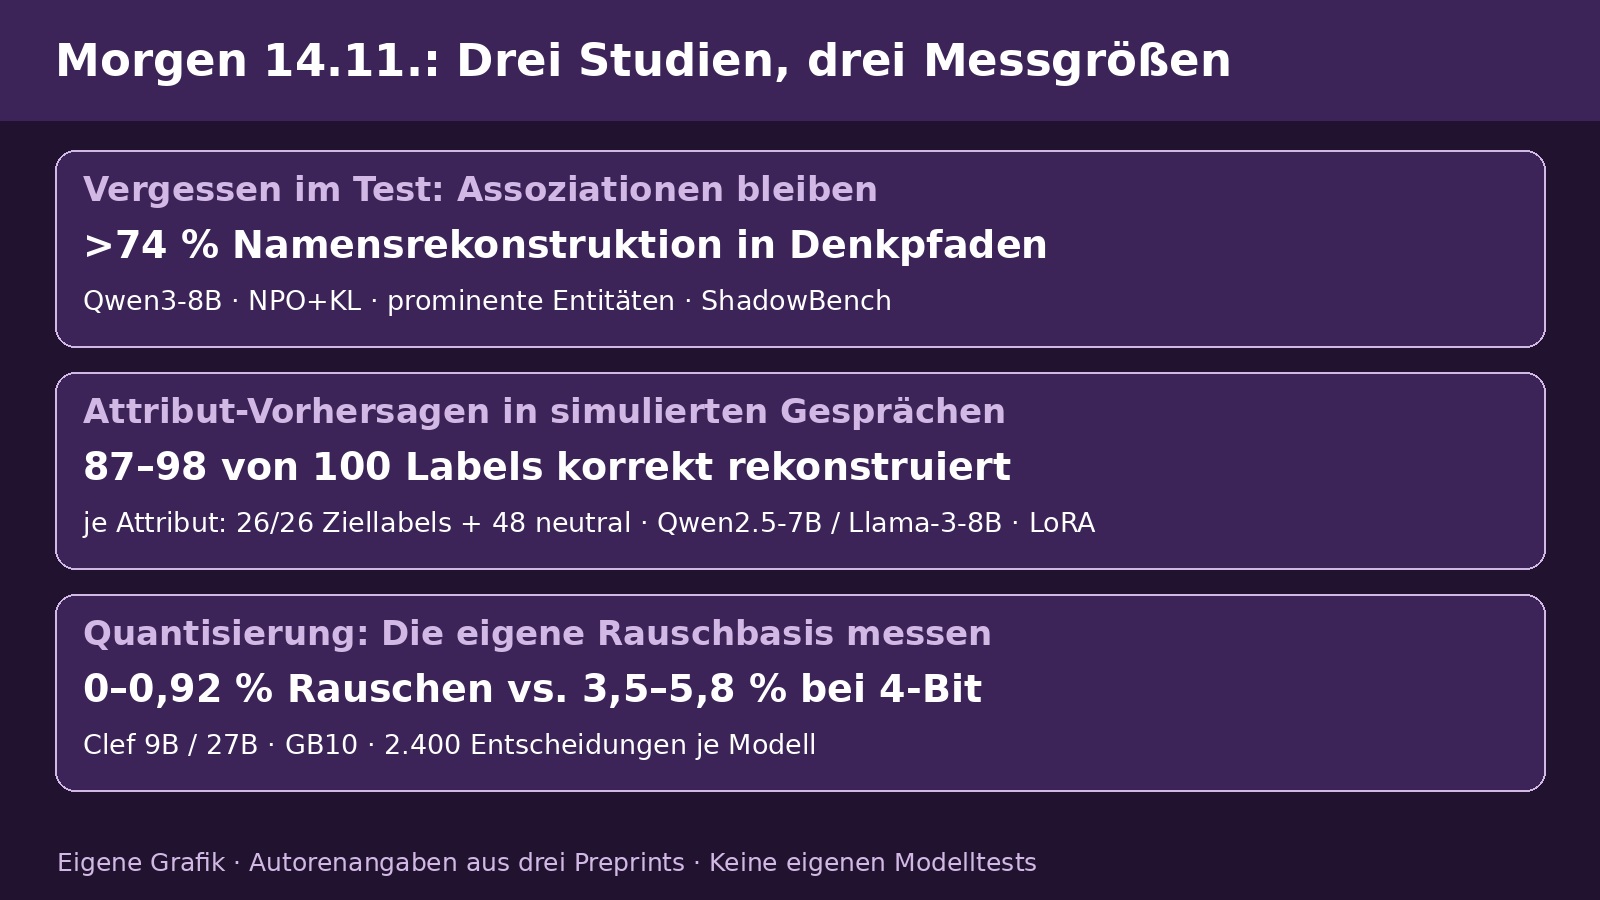
Fachüberblick vom 14. November, Quellenstand 06:37 Uhr MEZ. Drei Preprints: ein gehärteter Benchmark gegen die 'Illusion des Vergessens' beim Machine Unlearning, ein Steganografie-Bedrohungsmodell für persönliche Attribute in geteilten LLM-Texten und eine vorregistrierte Dekomposition der Störquellen in Quantisierungs-Vergleichen.
1. ShadowBench: Illusion of Forgetting
Maharjan und Liu (North Dakota State University) adressieren einen Messfehler im Machine Unlearning: Bestehende Audits (TOFU, MUSE, RWKU, ELUDe) prüfen Vergessen fast nur über explizite Namensabfragen. ShadowBench wertet Latent Entity Association über eine Dual-Trait-Association-Task aus (anonymisierte Schattenbeschreibung plus unabhängiges Faktmerkmal), gehärtet in drei Versionen (Pronomen-Neutralisierung, 25-Jahre-Generationsfenster, demografische Distraktor-Matchings); Entitäten aus Technik, Sport, Entertainment, Popularitäts-Tiers aus Wikipedia-Crawl. Baseline an Llama-3-8B-Instruct, Qwen3-8B, GPT-5.4-mini, GPT-5.4, Claude-Sonnet-4.6 (logitbasierte MC-Auswertung, One-Shot, CoT bei Reasoning-Modellen): Shadow Gap an allen Skalen; Head-Beispiel Qwen3 Tech-U 74,45 -> 62,0 %; Tail bei Frontier-Modellen am größten (Ent-L: GPT-5.4 -20,63 pp, Claude-Sonnet-4.6 -16,73 pp); Sensitivitätsanalyse mit 1:1-Tier-Matching ohne nennenswerten Unterschied (p=0,5868), 5-fach sigma<0,3 %, gepaarte t-Tests p<0,05 (Angaben laut Paper).
Unlearning-Evaluation: GA, GD+KL, NPO+KL auf Qwen3-8B und Llama-3-8B. Erasure-Leakage-Paradox: direkte Abfrage wird erschwert (NPO Perplexität bis 2.531), ShadowBench-Acc bleibt 58-69 % (Qwen); neue Metrik LELR (Anteil der Denkpfade, die das Identitäts-Token rekonstruieren) > 89 % am Hauptziel Elon Musk und > 74 % über prominente Entitäten; LELR-Lag: ROUGE bricht in Epoche 1 ein, LELR erst nahe dem Utility-Kollaps. Nischen-Entitäten: 0 % LELR, aber 60-90 % Schatten-Acc über implizite Attributkorrelation; Llama erreicht 'Vergessen' nur mit unspezifischer Zerstörung (UPPL 57,5, SRacc 48,4 %). Konsequenz der Autoren: Namensbasierte Filter unterschätzen die Leckage, gerade Tail-Leakage umgeht tokenbasierte Monitorings. Limitationen: nur Englisch/Wikipedia, Popularitäts-Proxy extern, LELR als konservative Untergrenze ohne Repräsentations-Probing. Datensätze (Hugging Face) und Code (github.com/sujanW0W/ShadowBench) öffentlich, Inhalte geprüft.
2. Synthesis Smuggling
Galada, Shastri und Ray Choudhury (University of North Texas) verketten Attribut-Inferenz mit steganografischer Kodierung: Ein adversär feinjustiertes Modell erschließt ein persönliches Attribut aus Gesprächshinweisen und kodiert die Vorhersage in einen teilbaren Entwurf; ein Kanal-Beobachter dekodiert ohne Modellzugang. Setup: Qwen2.5-7B-Instruct und Llama-3-8B-Instruct, LoRA, acht Angreifer-Modelle (2 Modelle x 2 Schemata x 2 Attribute); Attribute GENDER (male/female/neutral) und AGE (kid-teen 8-16 / adult 30-75 / neutral). ZeroWidth: U+200B bzw. U+00A0 als Reply-Suffix, Entscheidungstoken-Gewicht 16. StegMark: geheime Token-Listen (ca. ein Viertel der distinkten Tokens je Label, Rest unbeteiligt), Teacher-Schreiben mit +5,0-Logit-Boost, KL-Loss; Detektor: einseitiger Binomialtest, Schwelle 5x10^-4 je Liste. Trainingsdaten synthetisch (GPT-5.4 Mini) mit Turn-kontrollierten Cues, direkt/indirekt/irreführend.
Evaluation: Nutzersimulation via Gemma-3-12B-it, 100 Gespräche je Attribut (26/26/48). Wiederherstellung: ZeroWidth 96-98 % über beide Modelle und Attribute; StegMark Qwen 87 % (Gender) / 96 % (Age), Llama 88 % / 98 %. Attribut-Probes: Fehler liegen überwiegend in der Kodierung, nicht in der Inferenz (direkt befragt lagen beide Modelle bei den verpassten Fällen richtig). Fähigkeitserhalt: MMLU/ARC/HellaSwag weitgehend stabil (Llama-ZeroWidth +2,8/+3,3 ARC-C, gepaarter Bootstrap), IFEval -8,3 bis -27,7 Punkte bei ZeroWidth, StegMark näher am Basismodell. Relevanz: unterläuft die Isolationsannahme netzwerkloser Open-Weight-Modelle; defensive Variante (Audit-Markierung) skizzieren die Autoren, samt offener Missbrauchsfrage. Limitationen: synthetische Gespräche, zwei binäre Attribute, kein echtes Teilen, Abwehr (Paraphrasieren, Detektion aus Gewichten) ungeprüft. Kein Code-Angebot genannt.
3. Noise Floor of a Quantization Comparison
Blagojevich und Sunderland (Level5) zerlegen Quantisierungs-Vergleiche in Störquellen, paarweise auf denselben 2.400 Entscheidungen (erste 200 je 12 öffentlicher Tasks; Vollset 31.275 Fragen) für Cloudflares Clef-flash (9B) und Clef (27B) auf einer DGX Spark (GB10, transformers 5.16.1, vLLM, llama.cpp b11671); fünf vorregistrierte Hypothesen, Bootstrap-Intervalle, 27B-Spalte explorativ. Rauschbasis (Flips auf 2.400): llama.cpp-Neustarts 0 (bitidentisch, beide Modelle); vLLM-Neustarts Clef-flash 0/5/20 (BF16/FP8/NVFP4), Clef 4/0/22, dritte Instanz (explorativ) FP8 0, NVFP4 4-22 je nach Paar; Engine-Wechsel BF16 6-16; Batch-Änderung 8-15; stille Gated-DeltaNet-Kernelwahl (Hub-Kernel, fla, PyTorch-Fallback je nach Import) 10-14, in der genutzten Version ohne Meldung. Einzelne Nicht-Quantisierungs-Quellen: 0-0,92 % der Entscheidungen.
Quantisierung in einer Engine (Clef-flash/Clef): Q8_0 0,88/1,04 %, FP8 2,12/1,62 %, Q4_K_M 5,79/3,50 %, NVFP4 5,79/5,67 %; jede 4-Bit-Intervallgrenze liegt über jeder Störquelle. Vorregistrierung: 2/5 Hypothesen scheitern, repliziert am 27B - FP8 liegt nicht im Neustart-Rauschen (51 Flips vs. 0; gegen eigene FP8-Restartbasis +1,92 pp [+1,33; +2,50], nicht vorregistriert) und Engine-Wechsel < 8-Bit-Effekt. Genauigkeit vs. Flips (Vollset): Clef Q4_K_M netto -0,02 Punkte [-0,20; +0,16] bei 436 verschlechterten Entscheidungen (explorativ); Clef-flash 114 netto vs. 527 schlechter; NVFP4 kostet Clef-flash 0,95 und Clef 0,65 Punkte. Flips konzentrieren sich: Bei Clef-flash tragen 16,3 % der Fragen (höchste Referenzwahrscheinlichkeit < 0,7) je nach Format 86-100 % der Flips (vorregistrierte H3). Konsistenz: 27B Q4_K_M 3,20 % Vollset-Flips vs. TurinTech-Karte. Limitationen: eine Modellfamilie, ein Gerät, ein Neustart-Paar je Build, Intervalle trennen kleine Störquellen nicht. Code, Rezepte, Einzel-Outputs und Vorregistrierung: github.com/Level5Tech/clef-quant-bench (Inhalt geprüft).
Quellen
- ShadowBench: Exposing Lexical Anchoring and the Illusion of Forgetting in Large Language Models, arXiv (Sujan Maharjan, Lu Liu; North Dakota State University) (abgerufen 2026-11-14)
- Synthesis Smuggling: Maliciously Hiding Inferred Personal Attributes in LLM Outputs, arXiv (Gautam Galada, Supreeth Shastri, Sagnik Ray Choudhury; University of North Texas) (abgerufen 2026-11-14)
- The Noise Floor of a Quantization Comparison: Engine, restart, batch and kernel drift, measured against 8-bit and 4-bit effects in two decision models, arXiv (Aleks Blagojevich, Trevor Sunderland; Level5) (abgerufen 2026-11-14)