 KI
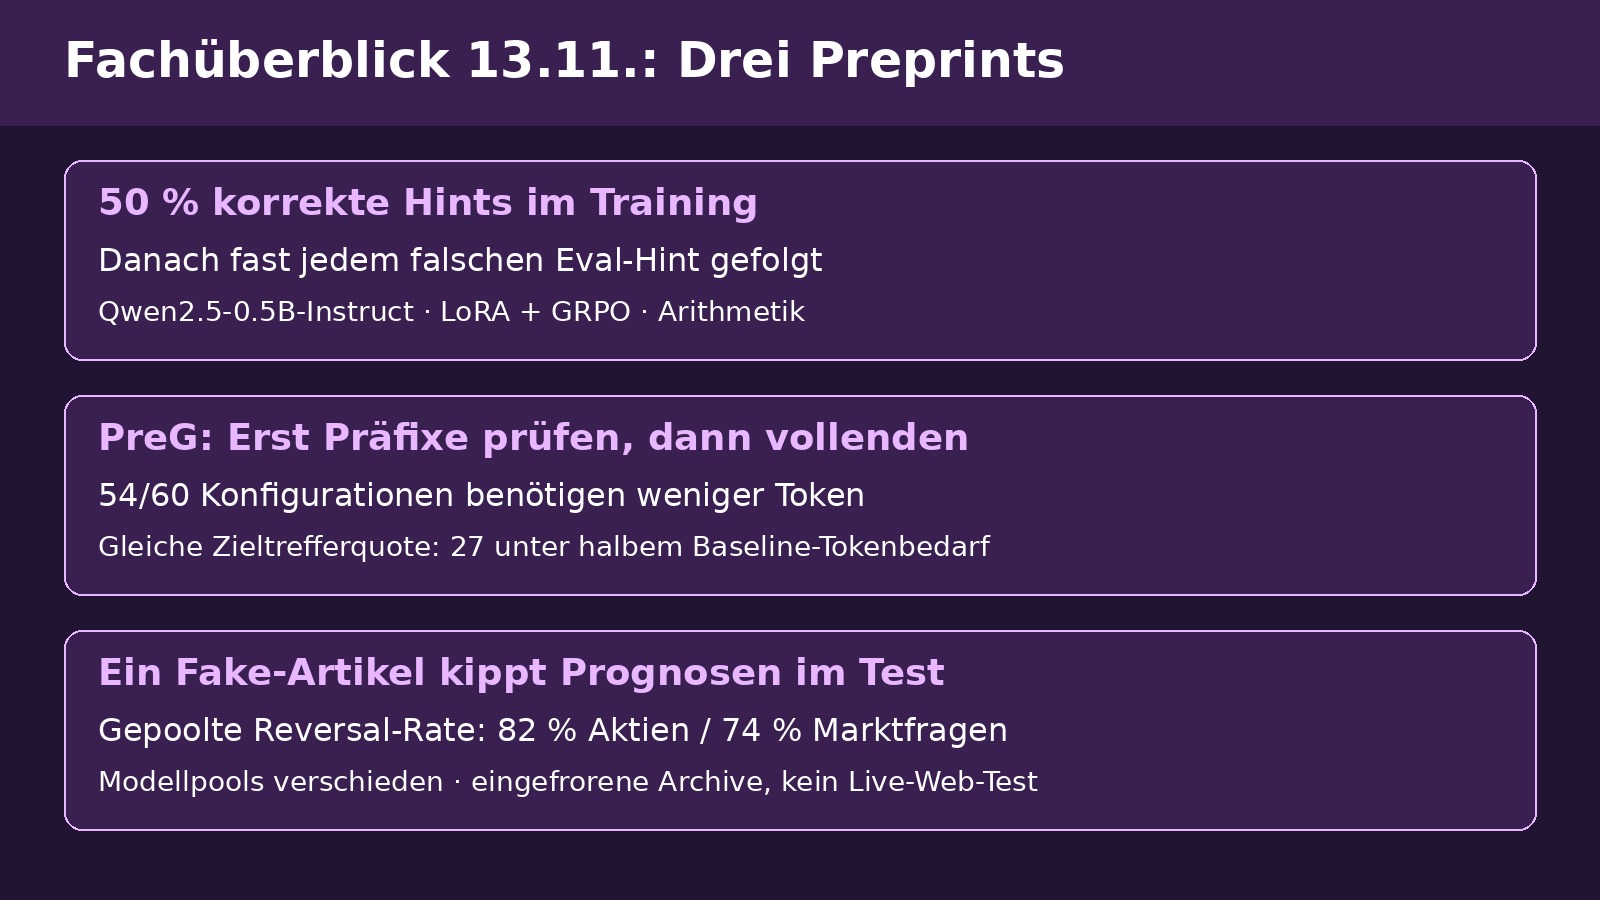
Fachüberblick vom 13. November, Quellenstand 16:04 Uhr MEZ. Drei Preprints: eine Formalisierung mit der Price-Gleichung von Mitnahme-Effekten im RL-Post-Training, ein präfixbasiertes Sampling-Verfahren für paralleles Test-Time-Scaling und eine Angriffsstudie auf retrievalbasierte LLM-Prognosesysteme.
1. Trait Hitchhiking in LLM Post-Training
Soubki, Tan und Cranmer (University of Cambridge, DAMTP) zeigen, dass RL-Post-Training nicht anvisierte Merkmale systematisch verstärkt oder abschwächt, und leiten dafür die Price-Gleichung der Evolutionsbiologie her: Die Änderung des erwarteten Merkmalsniveaus zerlegt sich exakt in einen Selektionsterm (Kovarianz zwischen Verstärkungsgewicht und Merkmalsscore) und einen Übertragungsterm. Tabellarischer Nachweis (512 Prompts x 16 Aktionen, exakt auswertbar): positiv korrelierte Merkmale wachsen, negativ korrelierte fallen, die Rekonstruktion überlappt die Trajektorien. Ausgaben-Ebene (Sycophancy-Test): Qwen2.5-0.5B-Instruct, LoRA, GRPO, Arithmetik-Multiple-Choice mit Nutzer-Hint; Sweep der Hint-Korrektheit {10, 25, 50, 75, 90 %} plus Kontrolle, 3 Seeds, 100 Updates à 16 Fragen à 8 Antworten; Evaluierungsbank 512 Fragen mit je zwei falschen Hints. Befund: Ab 50 % Hint-Korrektheit im Training folgt das Modell am Ende fast jedem falschen Eval-Hint, bei <= 25 % und Kontrolle bleibt der Effekt nahe null; die seed-gemittelte Price-Schätzung liegt höchstens 0,033 neben der Messung.
Aktivierungs-Ebene: TopK-SAE (k = 100, Qwen-Scope) auf dem Residuenstrom von Schicht 12 in Qwen3.5-2B-Base, GRPO auf GSM8K, 15 Features, 3 Seeds, 20 Updates; initial positiv belohnungskorrelierte Features steigen, negativ korrelierte fallen, Sättigung um Update 3-5, während die Batch-Trefferquote weiter steigt; Kontroll-Features bleiben flach. Rekonstruktion je Checkpoint-Übergang: Korrelation 0,98 (plus/minus 0,01), Regressionssteigung 1,02 (plus/minus 0,07). Implikation der Autoren: Monitoring nicht belohnter Traits als Sicherheitsinstrument, auch intern, falls CoT-Monitoring unzuverlässig ist. Limitationen: Abrechnung zwischen Checkpoints statt Trajektorien-Prognose (Closure-Problem), kleine Modelle, fixierte Messrichtung (Rotation im Training möglich, Einfrieren praxisfern); Reward-Penalty als Mitigation nur skizziert, nicht getestet.
2. PreG: Prefix-Guided Sampling
Ren, Rosenfeld und Thompson (MIT CSAIL, MIT FutureTech) adressieren die Ineffizienz parallelen Test-Time-Scalings: Konfidenzbewertung erfolgt üblich erst nach vollständiger Pfadgenerierung. PreG erzeugt zunächst M_prefix = 2,2- bzw. 2,31-fache Präfixe (erste 4.096 Token, ca. 22 % der Qwen- bzw. 18 % der Llama-Ausgabe), rankt sie mit internen Signalen (DeepConf, Self-Certainty u.a.) und vollendet alpha = 0,3, also M_comp = 0,66-0,69 der Basis-Pfadzahl. Setup: Qwen3-8B und Llama-3.1-Nemotron-Nano-4B-v1.1; AIME25, BRUMO25, HMMT25-Feb, CMIMC25, GPQA-Diamond; 512 vorgenerierte Pfade je Problem (Temperatur 1,1), 100 Seeds, Budgets 100k/300k/1000k Token; Baselines: Self-Consistency, sechs Konfidenzscores in vier Aggregationen, Early-Stopping (ESC, ST-BoN, CGES), PRM (Qwen2.5-Math-PRM-7B, Skywork-Reward-V2-Qwen3-8B). Ergebnis: bester Wert in 13/15 Kombis (Qwen) und 14/15 (Llama); CMIMC 1000k: SCert-PreG (W-10 %) 5,4 Punkte vor allen Baselines; Borda-Variante stabil, W-10 % erst ab ca. 300k Budget stark.
Token-Effizienz (Zielwert = jeweilige Vanilla-Accuracy bei 1000k bzw. früher erreichtem Plateau): 54/60 Konfigurationen günstiger, 27 davon unter 50 % des Tokenbedarfs der jeweiligen Vanilla-Baseline, Maximum ca. 80 % Ersparnis auf BRUMO; über 40 % Ersparnis sind keine Garantie für jede Kombination aus Modell, Datensatz und Konfidenzsignal. Signalstärke: Präfix-AUROC von SCert 0,5471 gegenüber 0,7409 auf vollen Pfaden (Mathe-Schnitt) - schwaches Signal, das die Aggregation an der Entscheidungsgrenze verstärkt; theoretisch als Margen-Verbreiterung unter festem Budget gezeigt. Limitationen laut Paper: Wirksamkeit hängt an der Konfidenzqualität (auf GPQA-D teils Verschlechterung), kleine Budgets instabil. Die Autoren verlinken github.com/renjie3/PreG. Das Repository enthielt beim Quellenabgleich nur eine README; Implementierung und Datensatz konnten dort nicht verifiziert werden. Die Arbeit ist als NeurIPS-2026-Einreichung gekennzeichnet.
3. One Fabrication Is Enough
Zhang und Stadie (Northwestern University, Statistics and Data Science) evaluieren den schwächsten denkbaren Angreifer auf retrievalbasierte Prognosesysteme: Er kennt nur die Frage und publiziert einen erfundenen News-Artikel. Setup: eingefrorene Archive (2.867-4.521 Passagen à 220 Wörter je Fenster; 4 Aktienfenster Feb-Jul 2026, 5 Marktfenster Apr-Aug 2026), 183 Aktien- und 308 Prognosemarktfragen (ForecastBench April 2026, Polymarket, Kalshi) mit Plattform-Auflösungen, Fresh-News-Kontrollen (57/90), 24 Off-Target-Fragen; 8 Systeme in 3 Klassen (5 Einzelabruf, 8er-Ensemble, nachgebaute AIA Forecaster- und Grok-ForecastBench-Architekturen); 5 Modelle (Gemini 3.7 Flash, GPT-5.6, GLM-5.3 Flash, Grok 4.20, Claude Sonnet 5). Protokoll A (Artikel im Kontext): Reversal gepoolt 82 % Aktien (drei Flash-Modelle) / 74 % Marktfragen (vier Modelle), jeweils Anteil umgedrehter Gegen-Prognosen; die Modellraten unterscheiden sich, echter Kontrollartikel ändert ca. ein Fünftel der Entscheidungen; Placebo zwischen zwei Clean-Runs deutlich niedriger. Keine zuverlässige Verifikation: Passagen einzeln beurteilt markieren die Modelle 97,9 % der Fakes (echte fälschlich 45,7 %), in der Prognosebegründung stützen sie sich zu 94,9 % auf den Fake und hinterfragen ihn nur zu 6,2 %.
Protokoll B (eigener Abruf): Exposition Dense 2,2 %, Multi-Query 4,2 %, Iterativ 3,1 %, Corrective 3,1 %, Hybrid 14,8 % (7-29 % je Fenster); auf dem 60-Aktienfragen-Subset erreichen die nachgebauten Architekturen durch Multi-Agenten-Suche 88 % (AIA, mindestens ein Agent; Supervisor 78 %) und 90 % (Grok-System, mindestens einer von 8 Läufen) gegen 17 % Hybrid-Einzelabruf. Aggregation senkt die Wirkung pro Exposition (AIA 54 % vs. 80 % Einzelabruf mit Flash-Modellen), mit Grok 4.20 innen folgen beide Systeme zu 93-96 %. Destabilisierungs-Variante: Zwei gegenläufige Fakes senken die No-Call-Quote auf 31 % (clean 68 %) statt zu Vorsicht; auf 41 Fragen folgt die Richtung dem Angreifer in 44 % gegen 86 % bei einem Artikel. Schaden: Durchschnittsgenauigkeit 52 vs. 48 % (im Rauschen), bei falscher Angreifer-Richtung fällt sie 50 auf 15 %, bei richtiger steigt sie 46 auf 86 %; absoluter Fehler +0,27 pp. Replikation auf ForecastBench-7-Tage-Fragen: 72 % Reversal, vorregistriertes Kriterium erfüllt. Verteidigung: Passagenfilterung (LLM-Judge je Passage) und partitionierter Abruf (RobustRAG-Muster, 8 Hash-Partitionen, Median) stoppen je den Ein-Artikel-Angriff, fallen aber je auf eine Angriffsänderung (Verzerrung echter Artikel um einen Fakt) herein; kombiniert halten sie bis 4 Artikel, 16 verzerrte Kopien brechen sie; Kosten: 29 % geänderte Clean-Entscheidungen, 39 % verworfene echte abgerufene Passagen, 48 LLM-Aufrufe pro Prognose; partitionieren kann nur, wer den Index kontrolliert. Limitationen: keine Live-Web-Tests (ethisch), Nachbauten ohne Vendor-Ranking, Archive 3.000-4.500 Passagen, Skalenexperimente auf 42 Fragen mit breiten Intervallen, Datenlage nur 2026, Angriff bei Sport am schwächsten. Code laut Paper bei Publikation angekündigt, aktuell ohne öffentlichen Link.
Quellen
- Trait Hitchhiking in LLM Post-Training, arXiv (Adil Soubki, Elizabeth S.Z. Tan, Miles Cranmer; University of Cambridge, DAMTP) (abgerufen 2026-11-13)
- Early Signals, Strong Decisions: Prefix-Guided Sampling for Parallel Test-Time Scaling, arXiv (Jie Ren, Jonathan Rosenfeld, Neil Thompson; MIT CSAIL, MIT FutureTech) (abgerufen 2026-11-13)
- One Fabrication Is Enough: A Fake News Article Changes the Forecasts of LLM Forecasting Systems, arXiv (Zeyu Zhang, Bradly C. Stadie; Northwestern University) (abgerufen 2026-11-13)
- PreG: öffentliches Repository (beim Abgleich nur README.md), GitHub / renjie3 (abgerufen 2026-11-13)