 KI
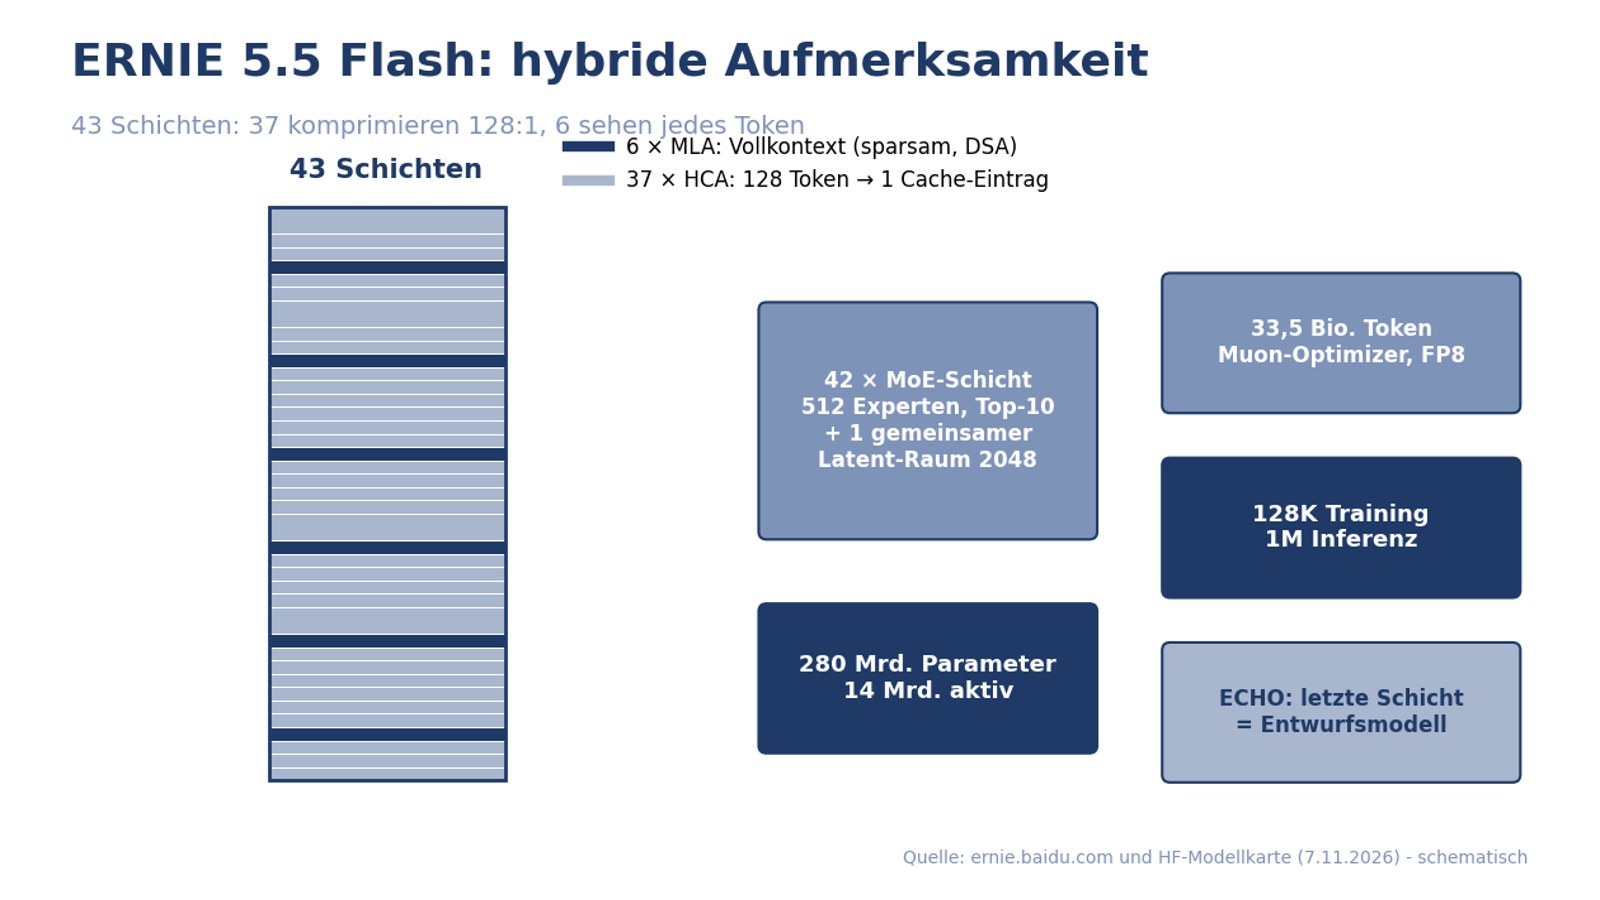
Baidu hat ERNIE-5.5-Flash-Base veröffentlicht: ein sparsam aktiviertes MoE-Basismodell mit 280 Milliarden Parametern, von denen pro Token 14 Milliarden aktiv sind [1][2]. Der Technical Blog datiert die Veröffentlichung auf den 5. November 2026; das Hugging-Face-Repository war bereits am 21. Oktober angelegt worden (Plattform-API) [1][2]. Es ist der Checkpoint am Ende des Vortrainings - ohne Mid- oder Post-Training - und richtet sich an alle, die selbst weitertrainieren wollen: Domänenanpassung, Instruction-Tuning, RL-Forschung. Eine nachtrainierte Version soll folgen [2].
Die Eckdaten
ERNIE-5.5-Flash-Base im Überblick (Herstellerangaben aus Karte und Blog) [1][2]
Modell
280 Milliarden Parameter gesamt, 14 Milliarden aktiv pro Token. 43 Schichten (1 dichte FFN-Schicht plus 42 MoE-Schichten), Modellbreite 4096, 64 Aufmerksamkeitsköpfe, Vokabular 201.216. Zusätzlich 0,36 Milliarden Parameter für ECHO (nicht in den Zählungen enthalten).
Training
Von Grund auf trainiert auf 33,5 Billionen Token mit dem Muon-Optimizer in FP8-Mischpräzision. Trainingskontext schrittweise auf 128K erweitert; Feintuning und Inferenz unterstützen 1.048.576 Token - die veröffentlichte Konfiguration aktiviert den 1M-Kontext.
Gewichte und Betrieb
FP8- und BF16-Safetensors auf Hugging Face und ModelScope. Serving über SGLang (offizielles Docker-Image) oder vLLM mit Baidus Plugin, jeweils Completions-API. Lizenz: ERNIE 5.5 Flash Base Model License Agreement v1.0 (Details unten).
Hybride Aufmerksamkeit: komprimieren, wo es geht
Der Kern der Architektur ist eine Arbeitsteilung der 43 Schichten [1][2]: Nur jede siebte Schicht (insgesamt sechs) behält mit Multi-head Latent Attention (MLA) Zugriff auf jedes einzelne Token des Kontexts. Die übrigen 37 Schichten nutzen Heavily Compressed Attention (HCA): Je 128 Token werden zu einem einzigen Cache-Eintrag verdichtet, dazu kommt ein kurzes Fenster unkomprimierter, jüngster Token. Jede Schicht sieht also weiterhin die ganze Sequenz - aber nur ein Bruchteil landet im KV-Cache. Die Kopfdimensionen sind an die Kosten angepasst: Die günstigen HCA-Schichten bekommen breite 512er-Köpfe, die teuren MLA-Schichten schmale 256er [1][2].
Baidu sagt, bei vergleichbarem KV-Cache-Budget schlage die Kombination HCA plus wenige MLA-Schichten die Alternative HCA plus viele schwächer komprimierende CSA-Schichten [2]. Die MLA-Schichten selbst arbeiten sparsam (DSA): Ein leichter Indexer bewertet frühere Positionen pro Anfrage, gerechnet wird nur über die Top-k - die Kosten pro Anfrage wachsen damit nicht mehr mit der Kontextlänge, bei laut Anbieter gleichem Vortrainings-Loss wie dichte Aufmerksamkeit [1][2].
Zwei weitere Eingriffe stecken in jeder Aufmerksamkeitsschicht: Das Gating des Aufmerksamkeitsausgangs wird aus dem niedrigrangigen Query-Latent statt aus dem Hidden State berechnet - 75 Prozent weniger Gating-Parameter bei laut Ablation besserer Qualität. Und Virtual Head Attention (VHA, verlinktes Paper) mischt nach der Aufmerksamkeit niedrigrangig über die Köpfe hinweg, mit Identitäts-Abkürzung; zur Inferenz wird der Schritt in den Kernel gefaltet. QK-Norm kommt überall zum Einsatz [1][2].
MoE mit mehreren Routern in halber Breite
Statt eines einzigen Routers pro MoE-Schicht setzt Baidu mehrere unabhängig initialisierte Sigmoid-Router ein (Multi-Router, verlinktes Paper) [1][2]. Begründung aus dem Blog: Die Scores eines einzelnen Routers korrelieren vor allem in mittleren und tiefen Schichten nur schwach mit dem tatsächlichen Nutzen der Experten - und weil nicht gewählte Experten keinen Gradienten liefern, verstärken sich Fehlentscheidungen selbst. Mehrere Router mit unterschiedlichen Vorlieben machen die Auswahl korrigierbarer; Anzahl aktiver Experten, FLOPs und Kommunikationsvolumen bleiben gleich [2].
Jede MoE-Schicht hat 512 routbare Experten (Top-10) plus einen gemeinsamen Experten. Die Experten laufen in einem 2048-dimensionalen Latent-Raum statt in voller 4096er-Breite, was Dispatch/Combine-Verkehr und Experten-FLOPs etwa halbiert. Lastausgleich ohne Hilfsverlust, RMSNorm vor der Rückprojektion, SiTU-GLU-Aktivierungen und ein lernbarer Skalar pro Experte stabilisieren das Training über alle 43 Schichten [1][2].
ECHO statt separatem MTP-Modul
Für Multi-Token-Vorhersage hängen andere Modelle ein Zusatzmodul an. ECHO nutzt stattdessen die letzte Schicht des Backbones selbst, um künftige Token vorherzusagen - der Zukunfts-Loss formt damit direkt die Next-Token-Parameter [1][2]. Nebeneffekt: Dieselbe Schicht dient als eingebautes Entwurfsmodell für spekulative Dekodierung. Obwohl nur auf ein Zusatz-Token trainiert, entwirft sie laut Anbieter mehrere Token voraus mit höherer Annahmerate als ein gleich trainiertes Zusatzmodul [2]. Dazu kommen Manifold-constrained Hyper-Connections (vier parallele Residualströme) und ein MultiMax-Ausgabekopf mit lernbarer stückweiser Temperatur [1][2].
Trainingssystem: Muon auf tausenden GPUs
Trainiert wurde mit Muon - ein Optimizer, der Updates pro Parametermatrix orthogonalisiert und dadurch andere Kommunikationsmuster braucht als Adam [2]. Baidu bündelt dafür die Synchronisation dichter und MoE-Parameter in einer gemeinsamen kollektiven Operation über Knoten gleichen Rangs; laut Blog sinken Latenz und Jitter im Cluster deutlich, ohne die Optimizer-Semantik zu ändern. Eine speicherbalancierte Verteilung der Optimizer-Zustände vermeidet OOM-Hotspots und langsame Checkpoints. Der eigens gebaute Kernel FlashMask-4 (CuTe-DSL, SM90 und SM100) unterstützt Kopfdimensionen bis 576/512 und ist auf SM100 laut Anbieter bis zu 175 Prozent schneller vorwärts und 74 Prozent schneller rückwärts als FlashAttention-4 MaskMod - alles Anbieterangaben [1][2].
Die gemeldeten Messwerte
Baidu verglich das Basismodell mit drei offenen Basismodellen ähnlicher Größe - DeepSeek-V4-Flash-Base (284B-A13B), Hy3-preview-Base (295B-A21B) und MiMo-V2.5-Base (310B-A15B) - in einer einheitlichen Pipeline: gleiche Harness, gleiche Prompts, gleiche Few-Shot-Beispiele, gleicher LLM-Judge für Freitext [1][2]. Das ist sauberer als der übliche Kartenvergleich, bleibt aber eine Messung des Anbieters.
Daten als Tabelle
| ERNIE-5.5-Flash-Base | |
|---|---|
| MMLU | 93,3 |
| MMLU-Pro | 78,4 |
| GPQA | 60,2 |
| HumanEval+ | 82,3 |
| LiveCodeBench | 40,1 |
| LongBench-v2 | 48,7 |
Anbieterangaben aus Baidus einheitlicher Testpipeline, von uns nicht unabhängig nachgemessen [1][2]. Je Benchmark eigene Aufgaben und Metriken - nicht testübergreifend vergleichbar. Es sind Basismodell-Werte ohne Nachtraining.
In den meisten Zeilen der Tabelle führt ERNIE-5.5-Flash-Base - nicht in allen: ChineseSimpleQA geht an DeepSeek-V4-Flash-Base (75,3 zu 73,0), BBH mit Chain-of-Thought an Hy3-preview (90,0 zu 89,2), INCLUDE-lite knapp an DeepSeek (79,8 zu 79,5), FullStackBench an Hy3 (56,7 zu 54,6), HELMET-Rerank an DeepSeek (60,0 zu 56,2) und InfiniteBench knapp an DeepSeek (48,0 zu 46,5) [1][2]. Beachtenswert: Obwohl 37 der 43 Schichten nur eine 128-fach komprimierte Sequenz sehen, halten die Langkontext-Werte (HELMET, RepoQA 91,7, LongBench-v2 48,7) laut Tabelle mit - Baidu führt das auf die sechs MLA-Schichten zurück [2].
Die Lizenz: EU ausgeschlossen, Umsatzschwelle im erlaubten Gebiet
Wichtig für Leser in Deutschland: Die Lizenz (Version 1.0 vom 5. November 2026) definiert ihr Gebiet ausdrücklich als weltweit außer EU, Vereinigtem Königreich und Südkorea (§1.11). Rechte werden ausschließlich innerhalb dieses Gebiets gewährt (§2); §5.3 verbietet außerhalb auch Nutzung, Vervielfältigung, Veränderung, Verteilung und Darstellung des Modells, seiner Ableitungen und Ausgaben. Diese Standardlizenz gewährt daher in der EU einschließlich Deutschland keine entsprechenden Nutzungsrechte, unabhängig von Umsatz oder nichtkommerziellem Zweck. Ob eine separate Erlaubnis oder andere Rechtsgrundlagen greifen könnten, haben wir nicht geprüft [3]. Die eigene Lizenz (Version 1.0 vom 5. November 2026) ist kein Standard-Open-Source-Text [3]. Nur im erlaubten Gebiet gilt: Nichtkommerzielle Nutzung - Forschung, Lehre, Evaluation, persönliche Experimente - ist kostenfrei. Kommerzielle Nutzung ist ebenfalls kostenfrei, solange der Umsatz in den jeweils vorangegangenen zwölf Monaten der damit verbundenen Produkte und Dienste höchstens 50 Millionen US-Dollar beträgt; Bedingungen: einmalige Nutzungsmeldung an Baidu vor dem ersten Einsatz und ein gut sichtbarer Hinweis 'Powered by ERNIE'. Über 50 Millionen US-Dollar ist vorher eine gesonderte schriftliche Genehmigung nötig - wächst der Umsatz während der Nutzung über die Schwelle, muss die Nutzung bis zur Genehmigung ruhen [3].
Drei Details sind lesenswert [3]: Erstens wird der Umsatz konzernweit aggregiert - Unternehmen unter gemeinsamer Kontrolle (mehr als 50 Prozent) gelten als ein Operator. Zweitens gelten abgeleitete Modelle (Feintuning, Quantisierung, Pruning, Distillation auf andere Modelle) als lizenzpflichtig im selben Rahmen. Drittens untersagt Klausel 5.5, das Modell, Ableitungen oder deren Ausgaben zur Verbesserung anderer KI-Modelle zu nutzen - erlaubt ist nur die Arbeit an eigenen Derivaten. Bei 50 Millionen US-Dollar oder mehr darf Baidu einmal pro Kalenderjahr eine schriftliche Compliance-Erklärung anfordern [3].
Einordnung
ERNIE-5.5-Flash-Base ist eine Wette auf Weitertraining: Baidu gibt das Fundament ab, bevor eigene Ausrichtung es festlegt, und optimiert jedes Bauteil auf die Kosten, die Feintuning und Agentenbetrieb später verursachen - KV-Cache, aktivierte Rechenleistung, Langkontext [1][2]. Die vereinheitlichte Vergleichspipeline ist transparenter als üblich, und die Architekturdetails (HCA/MLA-Teilung, Multi-Router, ECHO) sind konkret genug, um sie nachzuvollziehen [1][2]. Zugleich bleiben alle Zahlen Herstellerangaben, die Standardlizenz schließt die EU, das Vereinigte Königreich und Südkorea vollständig aus. Nur im erlaubten Gebiet gelten Meldung und Branding unterhalb beziehungsweise bis zur Umsatzschwelle, darüber eine vorherige schriftliche Genehmigung [3].
FAQ
Methode
Analyse auf Basis der vollständig gelesenen Modellkarte, des vollständig gelesenen Technical Blogs (Datierung 5. November 2026) und des vollständig gelesenen Lizenztexts, ergänzt um die Hugging-Face-Repository-API (Anlagedatum). Sämtliche Messwerte sind Herstellerangaben aus einer vom Anbieter vereinheitlichten Pipeline. Keine eigenen Tests.
Grenzen
Keine eigenen Tests. Alle Benchmark-Werte stammen vom Anbieter; die Vergleichsmodelle wurden ebenfalls von Baidu mit derselben Pipeline gemessen, nicht von den jeweiligen Herstellern. Effizienzangaben zum Training (FlashMask-4, verteilter Muon) sind Anbieterangaben ohne unabhängige Prüfung. Wir haben keine Fremdmessung ausgewertet - ob es eine gibt, können wir nicht ausschließen. Die Standardlizenz schließt die EU, das Vereinigte Königreich und Südkorea aus [3].
Quellen
- baidu/ERNIE-5.5-Flash-Base (Modellkarte und Repository-API), Hugging Face / Baidu (abgerufen 2026-11-07) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- ERNIE 5.5 Flash Base (Technical Blog, 5. November 2026), Baidu ERNIE (abgerufen 2026-11-07) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- ERNIE 5.5 Flash Base Model License Agreement v1.0, Baidu (Lizenztext im Repository) (abgerufen 2026-11-07) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6