 KI
DeepSeek hat Mitte Oktober mit V4.1-Flash-1017 ein Update seines offenen Flash-Modells nachgelegt. Es ist ausdrücklich ein 'minor update' - aber eines mit klarer Richtung: bessere Werte bei Reasoning, Coding, Agenten- und visuellen Aufgaben, bei gleichzeitig kürzerer Ausführungszeit und kürzeren Antworten. Laut DeepSeek verschiebt das die Kosten-Fähigkeits-Pareto-Front über mehrere Agenten-Harnesses hinweg [1].
Die Zahlen des Updates
Der auffälligste Sprung: Auf Terminal-Bench 4.0 (im Claude-Code-Harness gemessen) steigt das Modell von 31,2 auf 42,3 Prozent - und liegt damit vor GPT-5.6 Sol (39,9) und GLM-5.3 (37,9), wenn auch hinter Opus 5 (51,8) [1]. DeepSWE v1.1 im Mini-SWE-V2-Harness steigt auf 77,0 Prozent und führt damit die Karten-Tabelle an [1]. Auch die Vision-Werte mit Tools steigen durchgängig, etwa Chartography auf 83,0 und BabyVision auf 92,5 Prozent [1].
| Benchmark | 1017 | V4.1-Flash | Bester anderer Wert |
|---|---|---|---|
| Terminal-Bench 4.0 | 42,3 | 31,2 | 51,8 (Opus 5) |
| DeepSWE v1.1 | 77,0 | 74,2 | 74,0 (Opus 5) |
| ProgramBench | 29,1 | 20,3 | 37,0 (Opus 5) |
| NL2Repo-Bench | 68,2 | 65,4 | 75,3 (Opus 5) |
| Automation-Bench v1.0.6 | 60,5 | 54,8 | 50,3 (Opus 5) |
| Agents' Last Exam | 35,4 | 31,8 | 28,6 (Opus 5) |
| Apex Bench v1.1 | 72,1 | 64,6 | 65,8 (Opus 5) |
| HLE ohne Tools | 42,6 | 36,8 | 56,3 (Opus 5) |
Auffällig an der Tabelle: Bei den Agenten-Benchmarks (Agents' Last Exam, Automation-Bench, Apex Bench) führt das 1017-Update das gesamte Vergleichsfeld an, bei den reinen Wissens- und Repo-Benchmarks bleibt Opus 5 vorn [1]. Wie immer bei Hersteller-Tabellen gilt: DeepSeek wählt Harness, Reasoning-Einstellungen und Vergleichsmodelle selbst.
Daten als Tabelle
| Gelöste Aufgaben in Prozent | |
|---|---|
| Opus 5 | 51,8 |
| DS-1017 | 42,3 |
| GPT-5.6 Sol | 39,9 |
| GLM-5.3 | 37,9 |
| DS-Flash | 31,2 |
| Kimi K3 | 12,6 |
Herstellerangaben DeepSeek [1]
Die Architektur dahinter
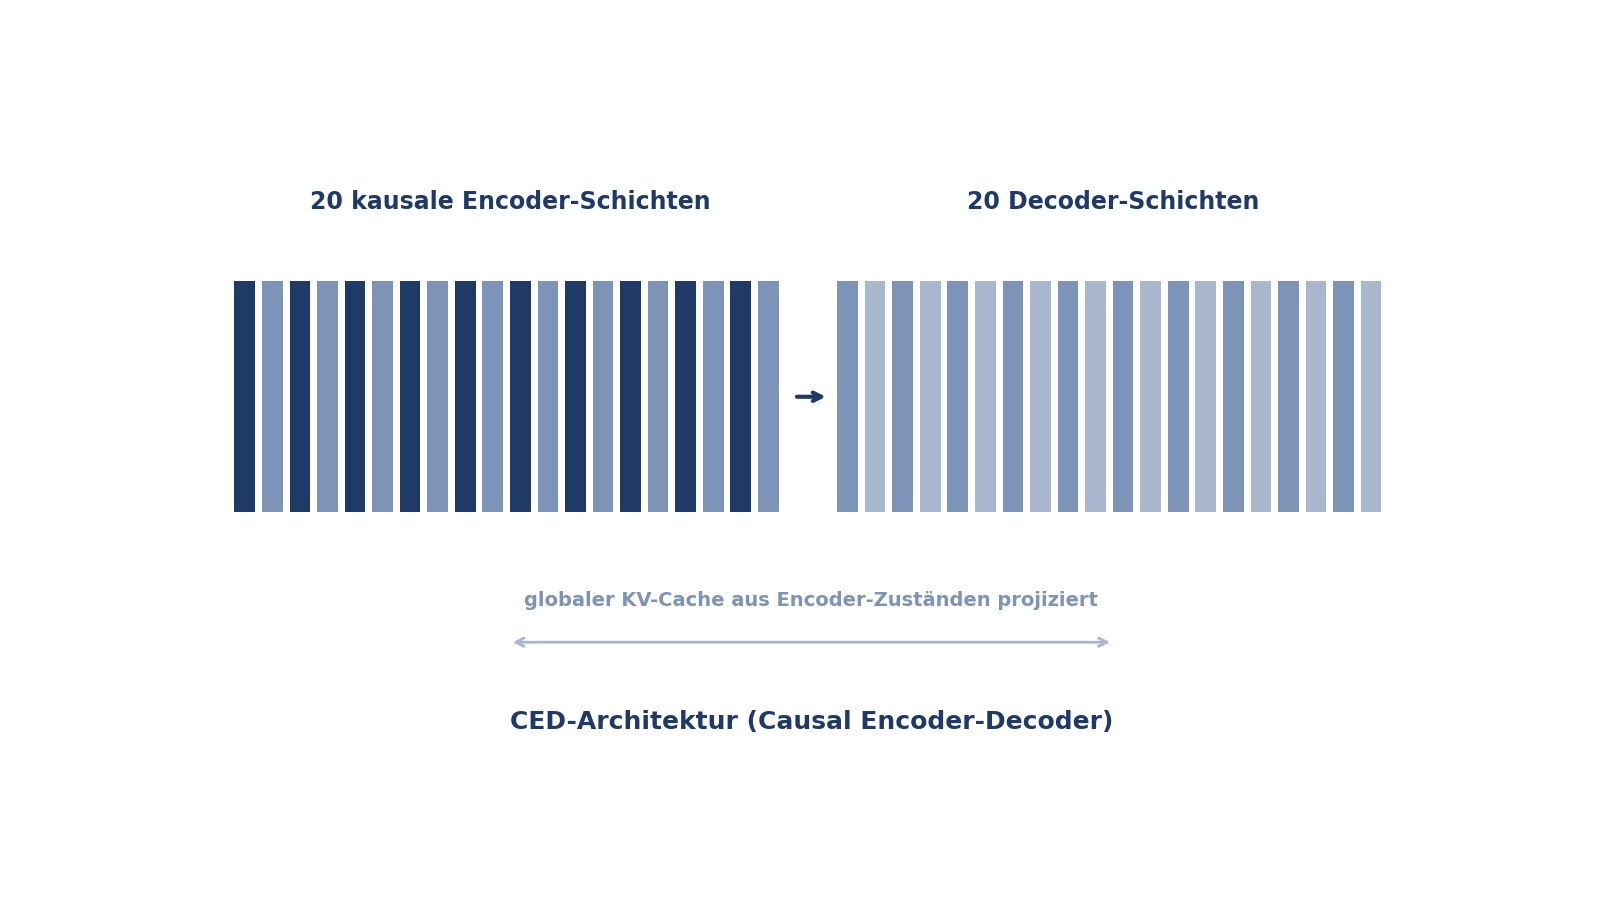
V4.1-Flash ist ein multimodales Mixture-of-Experts-Modell mit 552 Milliarden Backbone-Parametern und Unterstützung für Kontexte bis zu einer Million Tokens; die Hugging-Face-Seite beziffert die Gesamtgröße der Gewichtsdateien auf 763 Milliarden Parameter [1][3]. Der Clou ist die CED-Architektur (Causal Encoder-Decoder): 20 kausale Encoder-Schichten gefolgt von 20 Decoder-Schichten, wobei der globale KV-Cache des Decoders aus den letzten Encoder-Zuständen projiziert wird statt aus jeder Decoder-Schicht selbst [3].
Das Ergebnis: Pro Token aktiviert das Modell nur 8 Milliarden Parameter beim Prefill und 16 Milliarden beim Decode - teuer ist vor allem die Eingabe, und genau die wird bei Agenten-Workloads billig [3]. Dazu kommen SWA Bounded Replay, das den persistenten KV-Cache auf etwa ein Achtel von V4-Flash drückt, und Compressed Sparse Attention 2 mit drei statischen Modi (Full, Reindex, Reuse) [3].
Kein Jinja-Template - aber ein Rust-Toolkit
Praktisch relevant: Das Release enthält bewusst kein Jinja-Chat-Template. Stattdessen liefert DeepSeek eine eigenständige Python-Referenzimplementierung (encoding.py) mit Testfällen für Mehrfachdialoge, Tool-Aufrufe, Thinking-Modus und Bildinhalte [1]. Für den Produktivbetrieb empfiehlt DeepSeek deepseek-recipe: eine Sammlung von Rust-Bibliotheken mit Python-Bindings, die Messages-, Chat-Completions- und Responses-API-Anfragen in das Conversation-Format des Modells übersetzt - MIT-lizenziert, rund 2.500 GitHub-Sterne [1][2]. Modellinferenz, Tool-Ausführung und HTTP-Transport bleiben bewusst dem Aufrufer überlassen [2].
Für eigene Deployments nennt die Karte empfohlene Parameter: Temperatur 1.0, top_p 1.0, Kontextfenster 1M Tokens und mindestens 256K max_tokens [1]. Die Gewichte stehen unter der MIT-Lizenz - inklusive kommerzieller Nutzung [1].
Einordnung: Effizienz als Wettbewerbsachse
Das 1017-Update ist Mitte Oktober erschienen; gut eine Woche später hat auch OpenAI mit GPT-6.1 Terra ein Effizienz-Modell nachgelegt - die Richtung ist bei beiden gleich: kürzere, schnellere, billigere Agenten-Ausführung statt maximaler Einzelleistung. DeepSeeks Unterschied bleibt die Offenheit: MIT-Lizenz und 95.889 Downloads im letzten Monat (Stand: 27.10.2026) [1]. Wer V4.1-Flash bereits einsetzt, bekommt mit 1017 ein Drop-in-Update; die vollständige Architektur- und Kompressionsgeschichte steht in unseren früheren Analysen zum KV-Cache und zu DeepInfer [3].
Methode
Analyse auf Basis der DeepSeek-Modellkarten (V4.1-Flash-1017 und V4.1-Flash) sowie des deepseek-recipe-Repositorys. Alle Benchmark-Zahlen stammen vom Hersteller und wurden in herstellereigenen Harness-Konfigurationen erhoben; sie wurden nicht unabhängig reproduziert.
Grenzen
Die Vergleichswerte für andere Modelle (Opus 5, GPT-5.6 Sol, GLM-5.3, Kimi K3) stammen aus DeepSeeks eigener Tabelle, nicht aus unabhängigen Messungen. Das Modell wurde von der Redaktion nicht selbst ausgeführt; lokale Inferenz eines Modells dieser Größe ist ohne entsprechende GPU-Infrastruktur nicht praktikabel.
Quellen
- deepseek-ai/DeepSeek-V4.1-Flash-1017 - Modellkarte, Hugging Face / DeepSeek (abgerufen 2026-10-27) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- deepseek-ai/deepseek-recipe - Repository, GitHub / DeepSeek (abgerufen 2026-10-27) ↩1 ↩2
- deepseek-ai/DeepSeek-V4.1-Flash - Modellkarte, Hugging Face / DeepSeek (abgerufen 2026-10-27) ↩1 ↩2 ↩3 ↩4 ↩5