 KI
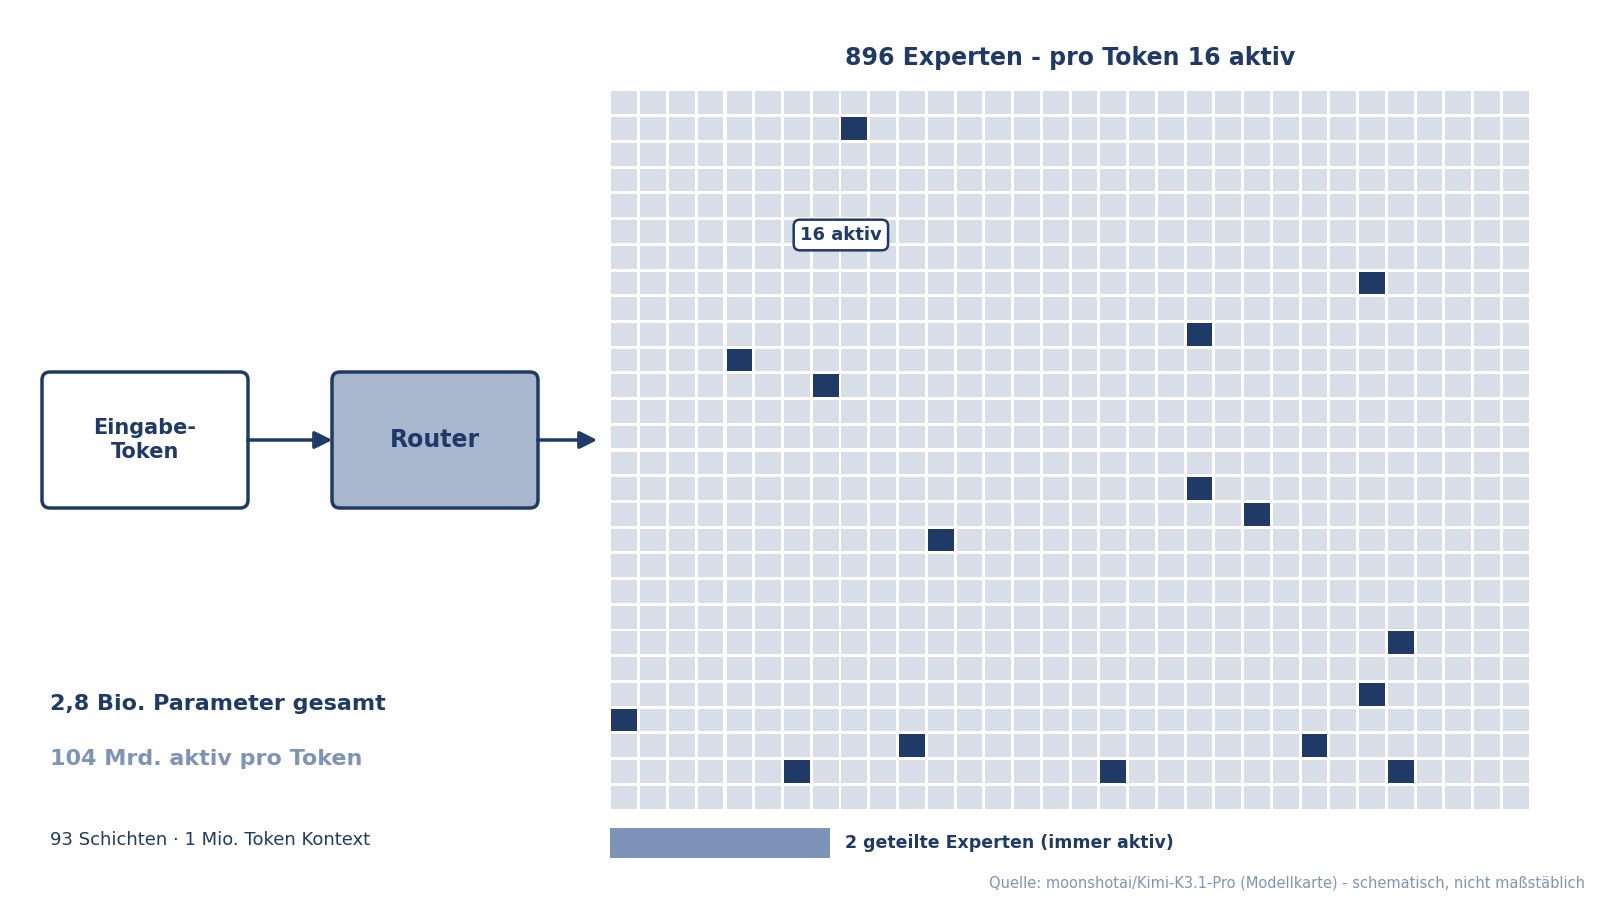
Moonshot AI hat Kimi K3.1 Pro veröffentlicht, das erste Modell der neuen K3.1-Serie und nach Herstellerangabe das leistungsfähigste offene Modell des Unternehmens in der 3-Billionen-Parameter-Klasse [1]. Moonshot hatte die Freigabe der vollständigen Gewichte bis zum 4. November angekündigt [1]; sie liegen auf Hugging Face vor, das Repository wurde laut Plattform-API am 2. November 2026 angelegt und ist nicht zugangsbeschränkt [2].
Die Eckdaten
Kimi K3.1 Pro im Überblick (Herstellerangaben aus der Modellkarte) [2]
Parameter
2,8 Billionen Parameter gesamt, 104 Milliarden aktiv pro Token (Mixture-of-Experts)
Schichten und Experten
93 Schichten mit 69 KDA- und 24 Gated-DSA-Attention-Schichten; die Modellkarte nennt separat eine Dense-Schicht; 896 Experten, davon 16 pro Token aktiv, plus zwei geteilte Experten
Aufmerksamkeit
69 KDA-Schichten und 24 Schichten mit Gated DeepSeek Sparse Attention (Gated DSA); 96 Köpfe, Hidden-Dimension 7.168. Gegenüber Kimi K3 ersetzt das Modell die voll aufmerksamen Gated-MLA-Schichten durch Gated DSA, für effizientere Verarbeitung langer Kontexte [2]
Kontext und Vokabular
1.048.576 Token Kontextlänge, Vokabular 160.000
Bildverarbeitung und Quantisierung
MoonViT-V2-Encoder mit 401 Millionen Parametern; Eingabe Text und Bild, Ausgabe Text. Gewichte in MXFP4, Aktivierungen in MXFP8, quantisierungsbewusst trainiert [2]
Lizenz
Eigene 'Kimi K3.1 Pro License' (Lizenztext von uns gelesen) [3]: Nutzung, Vervielfältigung, Änderung, Verbreitung und Verkauf sind erlaubt; Copyright- und Erlaubnisvermerk müssen erhalten bleiben. Betreibt der Lizenznehmer oder eines seiner verbundenen Unternehmen ein 'Model as a Service'-Geschäft und überschreitet ihr zusammengefasster Gesamtumsatz in beliebigen zwölf aufeinanderfolgenden Monaten 20 Mio. US-Dollar, ist vor jeder kommerziellen Nutzung eine gesonderte Vereinbarung mit Moonshot nötig. MaaS meint hier Inferenz oder Fine-Tuning für Dritte mit wesentlicher Kontrolle über Eingaben, Parameter oder Trainingsdaten. Bloß in Produktfunktionen eingebettete Modellfähigkeiten und die reine Weiterleitung an fremd gehostete Modelle zählen nicht dazu. Für kommerzielle Produkte oder Dienste mit mehr als 100 Mio. monatlich aktiven Nutzern ODER mehr als 20 Mio. US-Dollar Monatsumsatz ist 'Kimi K3.1-Pro' deutlich in der Oberfläche anzuzeigen. Beide Zusatzbedingungen entfallen bei interner Nutzung ohne Bereitstellung des Modells, seiner Ausgaben oder Fähigkeiten an Dritte sowie bei Zugriff über offizielle Moonshot-Produkte oder zertifizierte Inferenzpartner [3].
Was neu ist gegenüber Kimi K3
K3.1 Pro ist laut Moonshot eine weitertrainierte Version von Kimi K3 mit deutlich mehr Rechenaufwand im Post-Training: gemeinsames Reinforcement Learning über Hunderte von Anwendungsdomänen hinweg [1][2]. Die Architektur bleibt in der 3-Billionen-Klasse, der Kontext bei einer Million Token; der spürbare Unterschied soll in Coding, 3D-Erstellung, Finanzrecherche und faktischer Genauigkeit liegen [1]. Parallel erscheint die Variante Kimi K3.1 Pro Highspeed, die laut Hersteller die zwei- bis dreifache Geschwindigkeit liefert [1].
Die gemeldeten Messwerte
Für die Werte der Modellkarte gilt, soweit nicht anders vermerkt: reasoning effort max, Temperatur 1,0, top-p 0,95. Das Prüfprogramm (Harness) unterscheidet je Benchmark, die Fußnoten der Karte listen die Details; Kimi K3.1 Pro wurde in mehreren Coding-Tests mit dem Claude-Code-Harness ausgewertet, Vergleichswerte stammen teils aus Blogs und Leaderboards der jeweiligen Anbieter [2]. Auf Terminal-Bench 4.0 meldet Moonshot 65,7 Punkte - nach Herstellerangabe vor GPT-6 Astra (58,2) und knapp hinter Claude Opus 5.5 (66,4) [1][2]. Weitere gemeldete Werte: 92,7 auf BenchCAD mit Werkzeugen (Teilmenge von 1.000 Fällen aus 17.900, Voxel-IoU) und 92,1 auf BrowseComp [2].
Einzelergebnisse aus der Modellkarte, keine Rangliste zwischen Tests: Jeder Benchmark hat eigene Aufgaben, Metriken und Prüfprogramme. Die folgenden Zahlen dürfen nicht testübergreifend als Leistungsabstände verglichen werden [2].
| Benchmark | Gemeldeter Wert |
|---|---|
| Terminal-Bench 4.0 | 65,7 |
| SWE-Marathon v1.1 | 51,7 |
| DeepSWE v1.1 | 75,5 |
| HLE-Full mit Werkzeugen | 70,0 |
| BrowseComp | 92,1 |
| OfficeQA Pro v2 | 64,4 |
| OSWorld V2.1 | 79,6 |
Mehrere Werte stammen aus internen Benchmarks und sind entsprechend gekennzeichnet: Auf Kimi Code Bench 3.0 Long-horizon (intern) erreicht das Modell 61,2, auf den internen Finanztests verbessert es sich gegenüber Kimi K3 um 7,2 Punkte (Financial Modeling) und 11,6 Punkte (Financial Research), bei Business Operation meldet Moonshot etwa das 4,2-Fache des Vorgängers [1]. Auf der internen Hallu Bench Hard, einem Stresstest für faktische Genauigkeit mit Werkzeugzugang, sank die Halluzinationsrate auf Aussageebene von 23,4 Prozent (K3) auf 8,3 Prozent; der Anteil der Antworten mit mindestens einem Faktenfehler lag laut Moonshot bei 42,4 Prozent der Vorgängerrate. Der Hersteller weist selbst darauf hin, dass die Beispiele gezielt fehlerträchtig konstruiert sind und die Raten nicht dem Alltag entsprechen [1].
3D-Erstellung und ein langer Agentenlauf
Als Beleg für langfristiges agentisches Arbeiten beschreibt der Hersteller einen internen Test, in dem K3.1 Pro einen Laufsimulator auf Basis von human-atlas baute, einem offenen anatomischen Modell mit 296 Skelett- und 402 Muskelkomponenten: Über 167 Missionen und 420 unabhängige Überprüfungen analysierte das Modell Ergebnisse und verfeinerte die Steuerung, bis die simulierte Figur 11,2 Sekunden kontinuierlich mit Wechselschritten lief statt nach Sekunden umzufallen. Als die Belohnungssteuerung die Armbewegung nicht verbesserte, führte das Modell laut Blog offene Tests der Simulationsdynamik durch und korrigierte 36 Fehler in den Hebelarm-Berechnungen der Schultermuskeln [1]. Ein vom Hersteller ausgewähltes internes Einzelbeispiel, keine unabhängige Replikation und kein Nachweis allgemeiner Zuverlässigkeit.
Cyber-Kontrollen beim offenen Modell
Für die Veröffentlichung der Gewichte hat Moonshot nach eigenen Angaben cyber-bezogene Daten aus dem Mid-Training-Korpus und aus den RL-Umgebungen entfernt, nachdem interne Versuche gezeigt hätten, dass diese Daten die Fähigkeiten zur Schwachstellenforschung deutlich erhöhen [1]. Auf dem internen xdev-bench-hard (von Experten kuratierte Aufgaben zu Schwachstellensuche und Exploit-Entwicklung an realem Quellcode, unter anderem Linux-Kernel, Node.js, JavaScriptCore, Exim, VirGL; pass@3) kam ein Checkpoint ohne diese Entfernung auf 90,5 Prozent, das veröffentlichte Modell auf 81,0 Prozent [1][2]. Moonshot schreibt, das Modell bleibe in Cyber-Fähigkeiten hinter den proprietären Spitzenmodellen zurück [1].
Verfügbarkeit und Betrieb
Die Gewichte liegen als 96 Safetensors-Dateien auf Hugging Face [2]. Die API läuft über platform.kimi.ai mit den Modellkennungen kimi-k3.1-pro und kimi-k3.1-pro-highspeed und ist OpenAI- wie Anthropic-kompatibel; Zero Data Retention ist laut Blog verfügbar [1][2]. Für den Eigenbetrieb nennt die Karte vLLM, SGLang und TokenSpeed mit jeweiligen Anleitungen [2]. Das Denkniveau steuert das Feld reasoning_effort (low, high, max; Standard max); bei mehrteiligen Gesprächen muss die komplette Assistenten-Nachricht einschließlich reasoning_content zurückgegeben werden, sonst verliert das Modell den Gedankenfaden [2].
Einordnung
Kimi K3.1 Pro ist ein offen gewichtetes Modell mit 2,8 Billionen Parametern - die Schlagzeilen-Werte sind allerdings Herstellerangaben, mehrere davon aus internen Benchmarks, und die Vergleichswerte stammen aus unterschiedlichen Prüfprogrammen. Die Lizenz enthält nutzungsabhängige Zusatzbedingungen: Die Umsatzklausel für Modell-Dienste und die Anzeigepflicht für sehr große Produkte machen aus 'offenen Gewichten' nicht 'Open Source' im engeren Sinn. Für den Eigenbetrieb fallen trotz MXFP4-Quantisierung 96 Gewichtsdateien an - ein Mehr-GPU-Projekt, kein Laptop-Modell.
Methode
Analyse auf Basis des vollständig gelesenen Technik-Blogs von Moonshot AI, der vollständig gelesenen Hugging-Face-Modellkarte, des im Repository gelesenen Lizenztexts (Datei LICENSE) und der Hugging-Face-Repository-API (Anlagedatum, Dateiliste). Sämtliche Messwerte sind Herstellerangaben; Vergleichswerte anderer Modelle werden nur als Angaben der Moonshot-Quellen zitiert. Keine eigenen Tests.
Grenzen
Keine eigenen Tests. Ein Teil der Werte stammt aus internen Benchmarks des Herstellers (im Text gekennzeichnet). Das Anlagedatum des Repositories (2.11.2026) belegt nur die Repo-Anlage, nicht den Zeitpunkt der Gewichtsverfügbarkeit. Die Halluzinationsraten stammen aus einem Stresstest mit gezielt fehlerträchtigen Prompts und sind laut Hersteller nicht auf den Alltag übertragbar. Für diesen Artikel haben wir keine unabhängige Replikation vorgenommen.
Quellen
- Introducing Kimi K3.1 Pro (Technik-Blog), Moonshot AI (abgerufen 2026-11-05) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- moonshotai/Kimi-K3.1-Pro (Modellkarte und Repository-API), Hugging Face / Moonshot AI (abgerufen 2026-11-05) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Kimi K3.1 Pro License (Lizenztext im Repository), Hugging Face / Moonshot AI (abgerufen 2026-11-05) ↩1 ↩2 ↩3