 KI
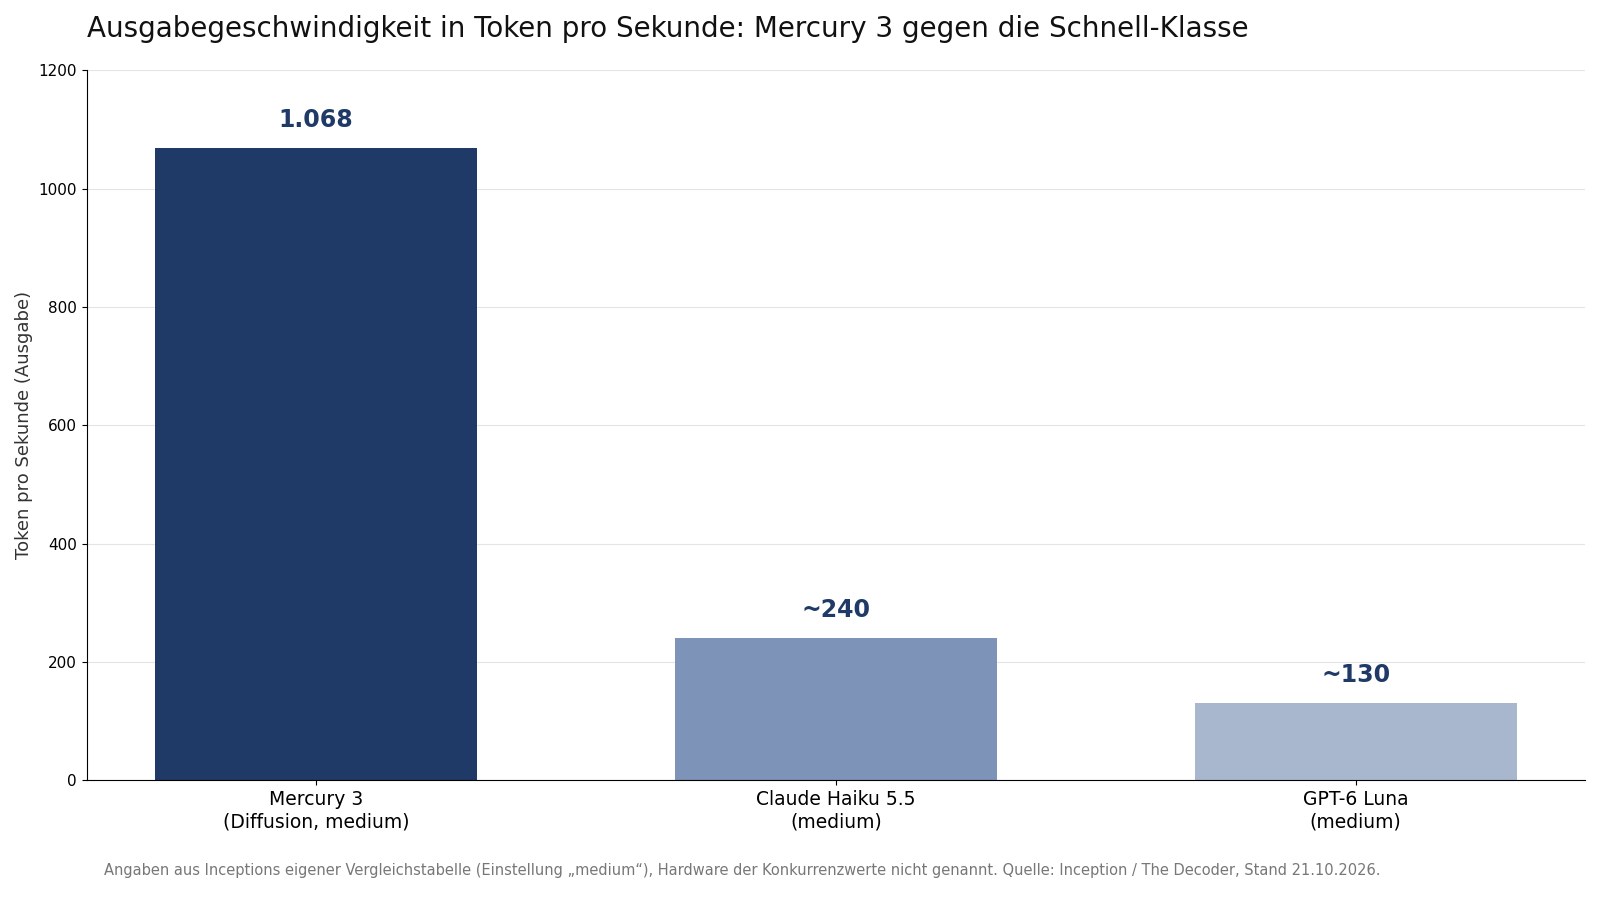
Inception hat mit Mercury 3 das bislang stärkste Diffusion-Sprachmodell vorgestellt: Laut Hersteller schlägt es GPT-6 Luna und Claude Haiku 5.5 in acht von zwölf Benchmarks und erzeugt dabei 1.068 Token pro Sekunde, also vier- bis achtmal schneller als die beiden Vergleichsmodelle [1][2]. Die Zahlen stammen aus Inceptions eigener Tabelle, nicht aus unabhängiger Messung. Trotzdem ist das Release ein markanter Datenpunkt: Erstmals steht ein Text-Diffusionsmodell in derselben Leistungsklasse wie etablierte autoregressive Schnell-Modelle. Dieser Artikel erklärt die Technik dahinter, liest die Benchmark-Tabelle im Detail und rechnet nach, was die Angaben praktisch bedeuten.
Was Inception vorgestellt hat
Mercury 3 ist das vierte Modell des Startups seit Mercury 1 im Juni 2025 [2]. Mercury 2 führte Anfang 2026 erstmals Reasoning-Zwischenschritte in ein Diffusionsmodell ein, Mercury 2.5 ergänzte einstellbares Reasoning und ein Kontextfenster von 260.000 Token [2][3]. Mercury 3 erweitert das Kontextfenster auf eine Million Token und ist nach Herstellerangabe mehr als vierzigmal so groß wie Mercury 1, bei gleichbleibender Geschwindigkeit [1][2].
Das Modell ist ab sofort über Inceptions API-Plattform sowie über OpenRouter, Baseten und Vercel verfügbar und spricht eine OpenAI-kompatible API, lässt sich also ohne Codeänderung in bestehende Anwendungen einhängen [1]. Der Listenpreis liegt bei 0,20 US-Dollar pro Million Eingabe-Token und 0,70 Dollar pro Million Ausgabe-Token; zum Start gibt Inception 50 Prozent Rabatt (0,10 beziehungsweise 0,35 Dollar), zwischengespeicherte Eingabe-Token kosten 90 Prozent weniger [1][2]. Enterprise-Kunden bekommen dedizierte Kapazität, Autoscaling und konfigurierbare Datenaufbewahrung [1].
Um das Modell herum baut Inception eine Echtzeit-Produktpalette. Mercury Voice ist auf minimale Zeit bis zum ersten Antwort-Token optimiert und läuft laut Hersteller bereits bei Audivi AI, Altur und OpenCall; Mercury Decide ist ein Modell für Massenklassifikation [1]. Als Early-Access-Einsätze nennt Inception Sprach- und Chat-Support, Echtzeit-Nachhilfe, Daten-Engineering und Web-Navigation [1].
Inception wurde unter anderem mit 50 Millionen US-Dollar von NVentures (Nvidia), M12 (Microsoft) und Snowflake Ventures finanziert [3]. Mitgründer Stefano Ermon ordnet das Release so ein: Die Grenzen der Diffusions-Skalierung seien Rechenleistung und Daten, keine grundsätzlichen algorithmischen Hürden; das nächste Modell befinde sich bereits im Training [2].
Wie ein Diffusion-Sprachmodell Text erzeugt
Klassische Sprachmodelle wie GPT oder Claude arbeiten autoregressiv: Sie erzeugen Token für Token, und jedes neue Token muss auf das vorherige warten. Diese Sequentialität ist der fundamentale Geschwindigkeitsengpass; sie ist auch der Grund, warum der KV-Cache als Speicherabkürzung überhaupt nötig wird. Diffusionsmodelle, bekannt aus der Bilderzeugung, drehen das Prinzip um: Sie beginnen mit einer verrauschten oder maskierten Rohfassung der gesamten Antwort und verfeinern sie über mehrere Durchgänge, wobei in jedem Durchgang viele Token gleichzeitig bestimmt werden [3][4].
Die Idee ist älter als der aktuelle Hype. Diffusion-LM zeigte 2022 erstmals, dass sich Text als kontinuierlicher Diffusionsprozess über Wortvektoren erzeugen lässt, inklusive feingranularer Steuerung bei sechs Kontrollaufgaben [6]. SEDD übertrug 2024 das Score-Matching sauber auf diskrete Token und schlug damit erstmals GPT-2, bei ähnlicher Qualität mit bis zu 32-mal weniger Netzwerkauswertungen [7]. LLaDA bewies Anfang 2025, dass ein von Grund auf als Diffusionsmodell trainiertes 8-Milliarden-Parameter-Modell mit LLaMA-3-8B mithalten kann; nebenbei löste es die sogenannte Reversal Curse und schlug GPT-4o in einer Gedicht-Umkehraufgabe [5].
Googles offenes DiffusionGemma, dessen technischer Bericht die Mechanik aktuell am besten dokumentiert, verfeinert Blöcke von 256 Token parallel und kommt so auf rund 20 fertige Token pro Vorwärtsdurchlauf [4]. Auf einer einzelnen H100 erreicht es laut Bericht etwa 1.500 Ausgabe-Token pro Sekunde, schneller als autoregressive Modelle selbst mit spekulativer Decodierung [4]. Entstanden ist es nicht aus dem Nichts: Es ist eine Umschulung des autoregressiven Gemma-4-Modells (25,2 Milliarden Parameter, 3,8 Milliarden aktiv) mit weniger als zehn Prozent des ursprünglichen Trainings-Token-Budgets, zuerst überwachtes Denoising, dann Verstärkungslernen mit Sampler-Distillation [4].
Zwei Eigenschaften hat die autoregressive Bauweise strukturell nicht. Erstens Füllen und Überarbeiten in der Mitte: Weil die Erzeugung nicht strikt von links nach rechts läuft, können Diffusionsmodelle Lücken im Text gezielt auffüllen; SEDD erreichte dabei Qualität auf Niveau von Nucleus-Sampling, bei gleichzeitig steuerbarer Position [7]. Zweitens Steuerbarkeit: Diffusion-LM demonstrierte schon 2022, dass sich Attribute wie Syntaxstruktur oder Länge gradientenbasiert in den Erzeugungsprozess hineinregeln lassen, ohne das Modell neu zu trainieren [6]. Beides sind Fähigkeiten, die in der Praxis etwa für strukturierte Ausgaben und Nachbearbeitung zählen.
Die Benchmark-Tabelle im Detail
Inception vergleicht Mercury 3 mit GPT-6 Luna und Claude Haiku 5.5, alle drei in der Einstellung „medium“. Von den zwölf ausgewiesenen Tests gewinnt Mercury 3 acht, GPT-6 Luna zwei, Claude Haiku 5.5 ebenfalls zwei [3]. Am deutlichsten ist der Vorsprung bei der Instruktionsbefolgung: Im IFBench erreicht Mercury 3 76,84 Punkte, GPT-6 Luna 61,82 und Claude Haiku 5.5 54,65. Auch im agentischen Programmieren auf SWE-Bench Atlas liegt Mercury 3 mit 51,08 klar vor 33,33 und 32,26 [3].
| Benchmark | Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 | Sieger |
|---|---|---|---|---|
| GDPval (Elo) | 1.237,2 | 1.204,0 | 1.225,0 | Mercury 3 |
| τ³-bench Banking | 30,24 | 23,00 | 13,06 | Mercury 3 |
| MultiChallenge | 60,35 | 51,49 | 52,48 | Mercury 3 |
| AA-Omniscience-Public | 46,44 | 46,94 | 37,22 | GPT-6 Luna |
| IFBench | 76,84 | 61,82 | 54,65 | Mercury 3 |
| GPQA Diamond | 89,23 | 86,36 | 84,51 | Mercury 3 |
| AA-LCR v1.1 (langer Kontext) | 77,67 | 78,30 | 74,70 | GPT-6 Luna |
| MRCR v2 (langer Kontext) | 75,50 | 62,72 | 78,40 | Claude Haiku 5.5 |
| SWE-Bench Atlas (agentisch) | 51,08 | 33,33 | 32,26 | Mercury 3 |
| DeepSWE v1 (agentisch) | 46,31 | 37,76 | 51,62 | Claude Haiku 5.5 |
| BrowseComp+ (agentische Suche) | 55,18 | 50,50 | 45,78 | Mercury 3 |
| DeepSearchQA (agentische Suche) | 71,33 | 60,00 | 65,22 | Mercury 3 |
Die Niederlagen sind aufschlussreich: Claude Haiku 5.5 gewinnt den längeren Coding-Test DeepSWE v1 mit 51,62 zu 46,31 und die Langtext-Suche MRCR v2, GPT-6 Luna die beiden Tests von Artificial Analysis (Omniscience und Long-Context-Retrieval) [3]. Inceptions eigene Kurzfassung formuliert deshalb vorsichtiger als die Überschrift der Ankündigung: Qualität sei „auf Augenhöhe oder besser“ [1]. Es ist auch kein Zufall, dass die verlorenen Tests ausgerechnet langes Lesen und langes eigenständiges Arbeiten messen; ob das an der Diffusionsarchitektur liegt oder am Trainingsstand, lässt sich aus der Tabelle nicht ablesen.
- Mercury 3
- GPT-6 Luna
- Claude Haiku 5.5
Daten als Tabelle
| Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 | |
|---|---|---|---|
| IFBench | 76,84Punkte | 61,82Punkte | 54,65Punkte |
| SWE-Bench Atlas | 51,08Punkte | 33,33Punkte | 32,26Punkte |
| DeepSWE v1 | 46,31Punkte | 37,76Punkte | 51,62Punkte |
Drei repräsentative Tests: Mercury 3 dominiert Instruktionsbefolgung und kurzes agentisches Coding, verliert aber den langen Coding-Test. Quelle: Inceptions Vergleichstabelle [3].
Was 1.068 Token pro Sekunde praktisch bedeuten
Der Geschwindigkeitswert ist der eigentliche Produktkern. In derselben Tabelle gibt Inception die Ausgabegeschwindigkeit der Konkurrenz mit rund 240 Token pro Sekunde für Claude Haiku 5.5 und rund 130 für GPT-6 Luna an [3]. Die genannte Hardware ist „gängige NVIDIA-GPUs“ [2]; eine präzisere Konfiguration nennt Inception nicht, weshalb die Werte als Herstellerangabe zu lesen sind.
Weniger als eine halbe Sekunde Erzeugungszeit verändert drei Anwendungsklassen spürbar. Erstens Agenten: Jeder Schritt einer Agent-Loop wartet auf das Modell, und kleine Verzögerungen multiplizieren sich über Dutzende Schritte. In Inceptions eigenem Web-Agenten-Test auf 50 Live-Aufgaben aus Mind2Web löste Mercury 3 die Hälfte der Aufgaben, deutlich mehr als GPT-6.1-Sol, bei gleichem Token-Verbrauch und gleicher Schrittzahl [1]. Zweitens Stimme und Echtzeit: Der Suchanbieter Octen maß in seinen Sense-API-Tests eine mediane Erzeugungszeit von 0,9 Sekunden und 2,2 Sekunden Ende-zu-Ende; auf smarten Brillen fühle sich eine Antwort ab fünf Sekunden kaputt an, zitiert Inception den Geschäftsführer [1]. Drittens interaktive Lernsoftware, wo Feedback in etwa einer Sekunde kommen muss, damit Lernende im Fluss bleiben [1].
Zum Vergleich: Googles DiffusionGemma kommt auf einer einzelnen H100 auf etwa 1.500 Token pro Sekunde [4]. Die beiden Werte sind nicht direkt vergleichbar, weil Inception die Hardware nicht spezifiziert und die Modelle unterschiedlich stark sind; sie zeigen aber gemeinsam, wo die Diffusionsklasse aktuell liegt, nämlich oberhalb von 1.000 Token pro Sekunde. Google selbst beziffert den Vorsprung von DiffusionGemma gegenüber dem Standard-Gemma-4 mit bis zu Faktor vier, bei leicht schwächeren Ergebnissen [3][4].
Daten als Tabelle
| Token pro Sekunde | |
|---|---|
| GPT-6 Luna | 130Token/s |
| Claude Haiku 5.5 | 240Token/s |
| Mercury 3 | 1068Token/s |
| DiffusionGemma | 1500Token/s |
Hersteller- und Paperangaben ohne einheitliche Hardwarebasis: DiffusionGemma auf einer H100 [4], Mercury 3 auf nicht näher genannten NVIDIA-GPUs [2], Konkurrenzwerte aus Inceptions Tabelle [3].
Preis, Kontext und das Kleingedruckte
In Inceptions Vergleichstabelle steht Mercury 3 mit 0,10 beziehungsweise 0,35 US-Dollar pro Million Token und wirkt damit günstiger als beide Rivalen, die dort mit 0,10 und 0,50 Dollar stehen [3]. Das ist der Einführungspreis. Im eigenen Blog nennt Inception den Listenpreis: 0,20 und 0,70 Dollar [1][2]. Nach Ablauf des Rabatts ist die Ausgabe bei Mercury 3 also teurer als bei den beiden Vergleichsmodellen, nicht günstiger. Wer kalkuliert, sollte mit den Listenpreisen rechnen und den Rabatt als das behandeln, was er ist: ein Startangebot.
Das Kontextfenster von einer Million Token ist für die Schnell-Klasse ungewöhnlich groß. Allerdings verliert Mercury 3 ausgerechnet die beiden Langkontext-Tests der eigenen Tabelle: AA-LCR v1.1 geht an GPT-6 Luna (78,30 zu 77,67), MRCR v2 an Claude Haiku 5.5 (78,40 zu 75,50) [3]. Ein großes Kontextfenster zu haben und es zuverlässig auszuwerten, bleiben zwei verschiedene Dinge; wir hatten diesen Unterschied auch in der Analyse zu Hersteller-Benchmarks gesehen.
Was noch offen ist
- Unabhängige Messung fehlt. Alle Benchmark- und Geschwindigkeitswerte zu Mercury 3 stammen von Inception selbst; Dritte hatten bis Redaktionsschluss keine Replikation veröffentlicht [3].
- Keine offenen Gewichte. Mercury 3 ist nur per API verfügbar [1]. Wer ein offenes Diffusionsmodell sucht, findet mit DiffusionGemma eine experimentelle Alternative, die allerdings bewusst unterhalb der proprietären Spitze angesiedelt ist [4].
- Reasoning-Einstellung „medium“. Wie sich die Modelle bei maximaler Denktiefe verhalten, zeigt die Tabelle nicht; gerade Reasoning-Modi verändern Reihenfolgen erfahrungsgemäß stärker als Standard-Einstellungen.
- Langfristige Preisgestaltung. Der Startpreis ist halbiert; nach der Einführungsphase liegt die Ausgabe über der der genannten Konkurrenz [1][2].
Was Diffusion (noch) nicht ersetzt
Die autoregressive Bauweise ist mit dem Mercury-Release nicht obsolet. Sie dominiert weiterhin das offene Ökosystem, die Werkzeugkette und die Spitzenmodelle; Techniken wie spekulative Decodierung nähern deren Tempo zusätzlich an, auch wenn DiffusionGemma sie eigenen Angaben zufolge überholt [4]. Hinzu kommt die Hardwarefrage: Diffusionsdurchläufe berechnen immer den ganzen Block, die Rechenersparnis pro Token ist daher kleiner als das Schritt-Verhältnis suggeriert. Und die stärksten Reasoning-Modelle der Branche sind nach wie vor autoregressive Systeme mit sehr langem, sequentiellem Denkprozess; ein Verfahren, das Antworten als Ganzes verfeinert, muss für diese Art des schrittweisen Problemlösens erst noch seinen eigenen Weg finden. Inceptions Antwort darauf war Mercury 2 mit Reasoning-Zwischenschritten [2][3] — wie tief dieses Reasoning im Vergleich reicht, wird erst die unabhängige Evaluation zeigen.
Das Fazit fällt zweigeteilt aus. Als Produkt ist Mercury 3 eine ernst zu nehmende Option für latenzkritische Anwendungen: Agenten, Sprachassistenten und Echtzeit-Suche profitieren messbar von vierstelliger Token-Geschwindigkeit, und die OpenAI-kompatible API senkt die Wechselkosten auf nahezu null [1]. Als wissenschaftliches Signal ist das Release noch stärker: Nach LLaDA im akademischen Maßstab und DiffusionGemma als offenem Zwischenschritt zeigt Mercury 3 erstmals ein kommerzielles Diffusionsmodell auf Augenhöhe mit der autoregressiven Schnell-Klasse [4][5]. Die entscheidende Prüfung steht allerdings noch aus: unabhängige Benchmarks.
Methode
Grundlage sind Inceptions Ankündigung und Pressemitteilung, die Berichterstattung von The Decoder inklusive der abfotografierten Hersteller-Benchmark-Tabelle sowie vier Originalpapiere (DiffusionGemma, LLaDA, Diffusion-LM, SEDD), alle am 22. Oktober 2026 selbst geöffnet. Eigene Rechnungen: (1) Tempofaktoren 1.068/240 = 4,45 und 1.068/130 = 8,2; (2) Erzeugungszeit für 500 Token = 500 / Token-pro-Sekunde, also 0,47 s / 2,1 s / 3,8 s; (3) DiffusionGemma-Pässe pro Block = 256 / 20 = 12,8. Alle eigenen Rechnungen sind im Text als solche gekennzeichnet.
Grenzen
- Alle Benchmark-, Geschwindigkeits- und Preisvergleiche zu Mercury 3 stammen aus Inceptions eigenen Materialien; es liegt keine unabhängige Replikation vor.
- Die Hardware hinter den 1.068 Token pro Sekunde nennt Inception nur als „gängige NVIDIA-GPUs“; der DiffusionGemma-Wert von rund 1.500 Token pro Sekunde auf einer H100 ist damit nicht direkt vergleichbar.
- Die Tabelle nutzt die Reasoning-Einstellung „medium“; Aussagen über andere Einstellungen oder Aufgaben außerhalb der zwölf Tests wären Spekulation.
- Der günstige Tabellenpreis von Mercury 3 ist der zeitlich begrenzte Einführungspreis, nicht der Listenpreis.
Quellen
- Diffusion at Scale: Introducing Mercury 3 (Blog), Inception (abgerufen 2026-10-22) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Inception Launches Mercury 3, Setting a New Pareto Frontier in Speed and Intelligence (Pressemitteilung), Business Wire / Inception (abgerufen 2026-10-22) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Inception's Mercury 3 diffusion model claims to beat GPT-6 Luna and Claude Haiku 5.5 at a fraction of the wait, The Decoder (abgerufen 2026-10-22) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- DiffusionGemma Technical Report, arXiv:2608.00146 (abgerufen 2026-10-22) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Large Language Diffusion Models (LLaDA), arXiv:2502.09992 (abgerufen 2026-10-22) ↩1 ↩2
- Diffusion-LM Improves Controllable Text Generation, arXiv:2205.14217 (abgerufen 2026-10-22) ↩1 ↩2
- Discrete Diffusion Modeling by Estimating the Ratios of the Data Distribution (SEDD), arXiv:2310.16834 (abgerufen 2026-10-22) ↩1 ↩2