 KI
Fachüberblick am Morgen des 4. November 2026. Quellenstand: 06:38 Uhr MEZ. Drei Themen für Entwicklerinnen und Entwickler: kryptografische Inferenzbeweise, ein Fixture-basiertes Regressionstest-Verfahren und Tencents Hy4 mit neuen Fähigkeiten. Alle Messwerte bleiben den Anbietern zugeordnet.
FlashProve: zkSNARK-Beweise über Llama 4 Maverick
Anthropics Frontier Red Team hat FlashProve als Open-Source-Prototyp unter Apache 2.0 veröffentlicht. Der Ablauf: Im Offline-Schritt publiziert der Anbieter ein Commitment auf die Gewichte, einen kurzen Fingerabdruck, der die Gewichte selbst verborgen hält. Zu jeder Antwort erzeugt der Anbieter anschließend einen Beweis; wer Commitment, Prompt und Antwort kennt, prüft ihn ohne Gewichte und ohne GPU. Das Commitment gilt laut Blogbeitrag für etwa 16 Millionen Anfragen, die Offline-Phase dauert rund 39 Minuten pro Modell.
Gemessen an Llama 4 Maverick (400B MoE, etwa 17B aktiv pro Token, 4-Bit): Eine H100 mit 24 CPU-Kernen beweist einen Batch von 24 Anfragen in rund 223 Sekunden, also etwa 110 Token pro Sekunde; der Beweis ist 18,78 MB pro 1.024-Token-Fenster groß. Der Verifier läuft auf CPU: 6,5 MB Commitment-Download, etwa 17 Sekunden Prüfzeit auf 24 Threads, 21 Sekunden auf einem. Verglichen mit vLLM auf acht H100 (FP8) kostet das Beweisen laut Anthropic pro GPU das 66- bis 77-Fache, bei maximaler Last das 94-Fache. Es sind Anbietermessungen an einem einzigen Setup.
Die Sicherheitsaussagen - Vollständigkeit, Soundness, Nullwissen - sind in Lean 4 formalisiert; ein langsamer, beweisbar korrekter Lean-Verifier existiert neben dem schnellen C++-Verifier ohne formale Garantie. Einschränkungen: Der Beweis gilt für die Ganzzahl-Variante mit Greedy-Decoding, Kontexte bis 1.024 Token und nur MoE-Architekturen; Seitenkanäle sind ausdrücklich ausgenommen. Laut Blogbeitrag stammen Entwurf und Protokollspezifikation weitgehend von Claude. Das Repository ist als ungepflegtes Forschungsartefakt markiert.
Model Integration Contracts: Fixtures statt Vollmodelle
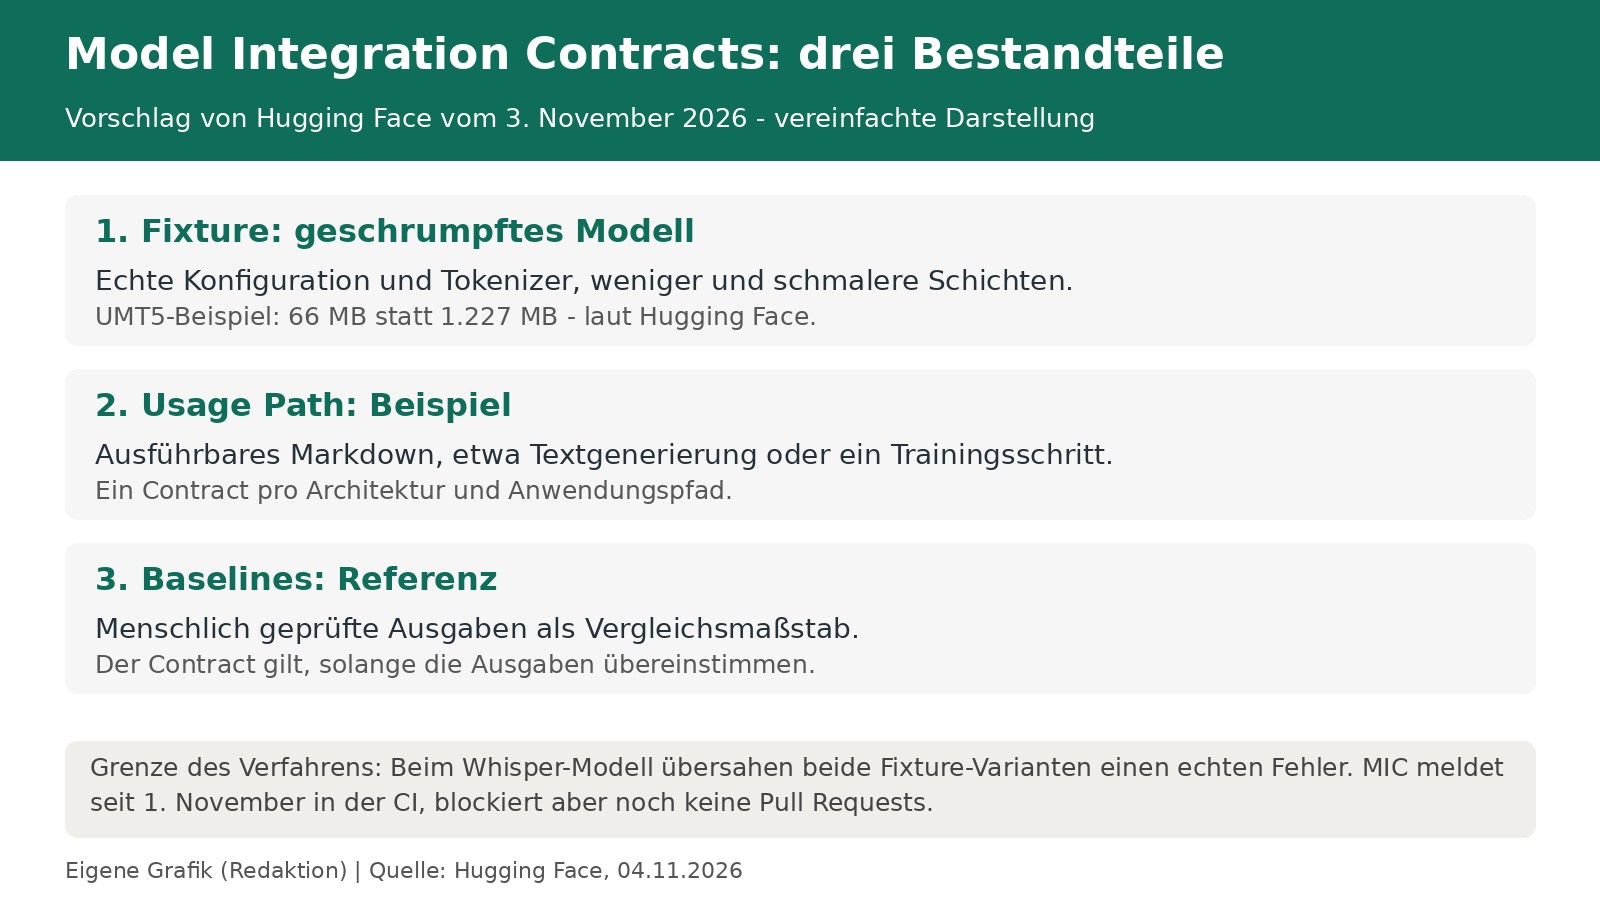
Hugging Face schlägt mit transformers-mic ein Paketformat für Integrationstests vor. Ein Contract besteht aus einem Fixture (einmalig publiziertes, verkleinertes Modell mit echter Konfiguration, unverändertem Tokenizer und allen Schichtarten), einem Usage Path (ausführbares Markdown-Beispiel) und Baselines (menschlich geprüfte Referenzausgaben). Ein Contract deckt eine Architektur und einen Anwendungspfad ab, keinen einzelnen Checkpoint. Die Verträge liegen im Hub-Bereich huggingface-mic; ein Fleet-Datensatz pinnt Revisionen und Paketversionen.
Auslöser war eine UMT5-Regression: Die SDPA-Aktivierung für T5 am 30. Juli 2026 ließ den Decoder auf zukünftige Token schauen; behoben wurde der Fehler erst am 28. September. Im Replay über fünf Monate Commits schlug das 66-MB-Fixture (Original: 1.227 MB) bei jedem betroffenen Commit an: Die Label-Log-Wahrscheinlichkeiten wichen um 1,22 ab, der Trainingsverlust um etwa 0,20. Entscheidend war der Standardpfad - nur mit SDPA, nicht mit der Eager-Variante, zeigte sich der Fehler. In der CI scheiterte der testweise rückgängig gemachte Fix mit denselben Abweichungen; der Runner-Schritt des ausgewählten T5-Vertrags lief dabei in 13,4 Sekunden auf CPU, ohne Einrichtung der Testumgebung.
Die Grenzen bleiben relevant: Beim Whisper-Fixture fanden Zufallsgewichte 18 von 24 injizierten Fehlern, überangepasste Gewichte alle 24 - doch beide Varianten übersahen einen Assisted-Decoding-Fehler, den nur der echte Whisper-Checkpoint zeigte. Seit 1. November meldet der MIC-Job in der Transformers-CI Fehler, blockiert aber noch keine Pull Requests; ob er blockieren soll, ist laut Blog offen. Das CLI tmic erzeugt Verträge halbautomatisch: Ein Sprachmodell entwirft Code und Manifest, geänderte Erwartungen erfordern menschliche Freigabe.
Hy4: verfügbar, aber Gewichte noch nicht offen
Tencent hat Hy4 vorgestellt, wie Ithome und Sina Tech unter Berufung auf den Konzern berichten. Gegenüber der Vorschau vom August (770B Parameter, 49B aktiv, 1M Kontext) seien Vor- und Nachtraining deutlich erweitert worden; neu sind Bildverstehen und Computer Use mit Kommandozeile und grafischer Oberfläche, mit Spezialtraining für Blender, CAD und die Spiele-Engines UE, Unity und Godot. Für Büroprozesse meldet Tencent in eigener Auswertung 83,18 Punkte im Mittel und 96,15 Prozent bestandene Aufgaben; in selbst gebauten Tests sank die Halluzinationsrate von 12,95 auf 7,2 Prozent, die Fehlerquote durch Raten von 23,1 auf 5,6 Prozent. Alle Werte stammen aus internen Tests des Herstellers.
Die Gewichte sind noch nicht verfügbar: Tencent kündigt die Open-Source-Freigabe samt System Card lediglich an; auf der offiziellen Modellseite steht bislang nur Hy4 preview (Stand: 06:38 Uhr MEZ). Nutzbar ist Hy4 über Tencent Cloud Tokenhub, WorkBuddy/CodeBuddy, Yuanbao und per API über OpenRouter, Hermes und OpenCode. Der Konzern räumt selbst Abstand zu führenden geschlossenen Modellen ein, besonders in schwierigen internen Testreihen. Hy4 flash, eine sparsamere Variante, soll in Kürze folgen.
Quellen
- Progress on provable inference for large language models, Anthropic (abgerufen 2026-11-04)
- FlashProve (Open-Source-Repository), Anthropic / GitHub (abgerufen 2026-11-04)
- Transformers Model Integration Contracts, Hugging Face Blog (abgerufen 2026-11-04)
- Tencent Hunyuan Hy4 full version released (chinesisch), Ithome (abgerufen 2026-11-04)
- Tencent Hunyuan veröffentlicht Hy4 (chinesisch), Sina Tech (abgerufen 2026-11-04)
- Open Source Model (offizielle Modellübersicht), Tencent Hy (abgerufen 2026-11-04)