 KI
Abendüberblick vom 8. November 2026. Quellenstand: 16:02 Uhr MEZ. Drei bisher nicht behandelte Originalberichte vom 5. November verbinden Agentenentwicklung mit präziseren Prüf- und Skalierungsfragen: PDD Kit, GitHub Rubicon und ein FLOP-basierter Vergleich von OPD mit GRPO. Forschungsprototyp, private Preview und Preprint sind nicht mit fertigen Produktgarantien gleichzusetzen.
PDD Kit: Verus-Beweis mit expliziter Vertrauensgrenze
Microsoft Research demonstriert Proof-Driven Development an der Loginlogik von Pet Store, einer etwa 5.000 Zeilen umfassenden Rust-App. PDD Kit arbeitet innerhalb der Planungsumgebung Chopin. Vor der Implementierung klärt es mehrdeutige Anforderungen und erstellt eine menschlich zu prüfende Spezifikation. Ein Coding-Agent erzeugt Code und Beweis; die formalen Eigenschaften werden mechanisch mit Verus geprüft, nicht durch das Urteil eines Sprachmodells.
Der Nachweis betrifft die spezifizierten Loginfunktionen unter akzeptierten Annahmen. SQL-Abfragen, bcrypt, Uhr, Tokensignierung und Teile des Request-Handlings liegen außerhalb und erhalten Tests. Terminierung, Antworttempo und Versuchslimits sind nicht zugesichert. Auch eine formal gültige, aber zu schwache Spezifikation kann am Nutzerziel vorbeigehen. Deshalb prüft pdd-prove laut Bericht gezielte Mutationen pro ensures-Klausel; ein nicht abgewehrter Fehler weist auf eine Lücke hin. Der Forschungsprototyp verifiziert derzeit Rust und belegt keine vollständige Sicherheit der gesamten Web-App.
Rubicon: Referenzkonsens ohne Objektkonsens
GitHubs Architekturbericht trennt bei Rubicon dauerhafte Packdaten in Azure Blob Storage von Referenzen und Packmanifest im replizierten Logdienst Ref-CAS. Virtuelle Replikate indexieren und speichern eingehende Packs, bevor eine Transaktion die Referenzen aktualisiert. Compare-and-Swap und ein Quorum sichern die Referenzänderung; nur betroffene Referenzen werden gesperrt. Gleichzeitige Pushes auf verschiedene Branches müssen dadurch nicht auf eine globale Repository-Sperre warten.
Separate Compaction-Knoten führen Packs zusammen und prüfen vor Veröffentlichung, ob dieselben Objekte enthalten sind. Lokale Platten der virtuellen Replikate sind wiederaufbaubare Caches. GitHub meldet intern 5.000 gleichzeitige Agenten und 7.200 Pushes pro Sekunde auf ein Repository bei weiterlaufenden Leseanfragen. Das sind Anbieterlasttests, kein nachgemessener Kundendurchsatz. Der Stand vom 5. November bleibt eine begrenzte private Preview; breiterer Rollout ist für Anfang 2027 angekündigt. Globale Replikate, Atomic-Commit-API und weitere Verbesserungen beschreibt der Text als nächste Schritte, nicht als allgemein verfügbare APIs.
OPD gegen GRPO: Gesamtpipeline statt einzelner Phase
Salesforce AI Research vergleicht im Preprint vom 5. November Standard-Reverse-KL-OPD mit GRPO bei gleichem Ausgangsmodell und kontrollierten Einstellungen. OPD bewertet schülereigene Rollouts mit einem eingefrorenen Lehrer; dieser zusätzliche Forward-Pass zählt in die FLOP-Bilanz. Externe nachtrainierte Lehrer machten OPD meist nicht effizienter. Die Aussage ist auf die untersuchten Ziele und Einstellungen begrenzt, kein Ausschluss anderer Divergenzen, hybrider Verluste oder asynchroner Verfahren. Eine wichtige Ausnahme: Mit nur einem Rollout pro Aufgabe (G=1) übertraf externe OPD im einzelnen Mathematikversuch GRPO bei gleichen FLOPs. Dieser Vorteil übertrug sich nicht auf Code oder den Mehrdomänenmix.
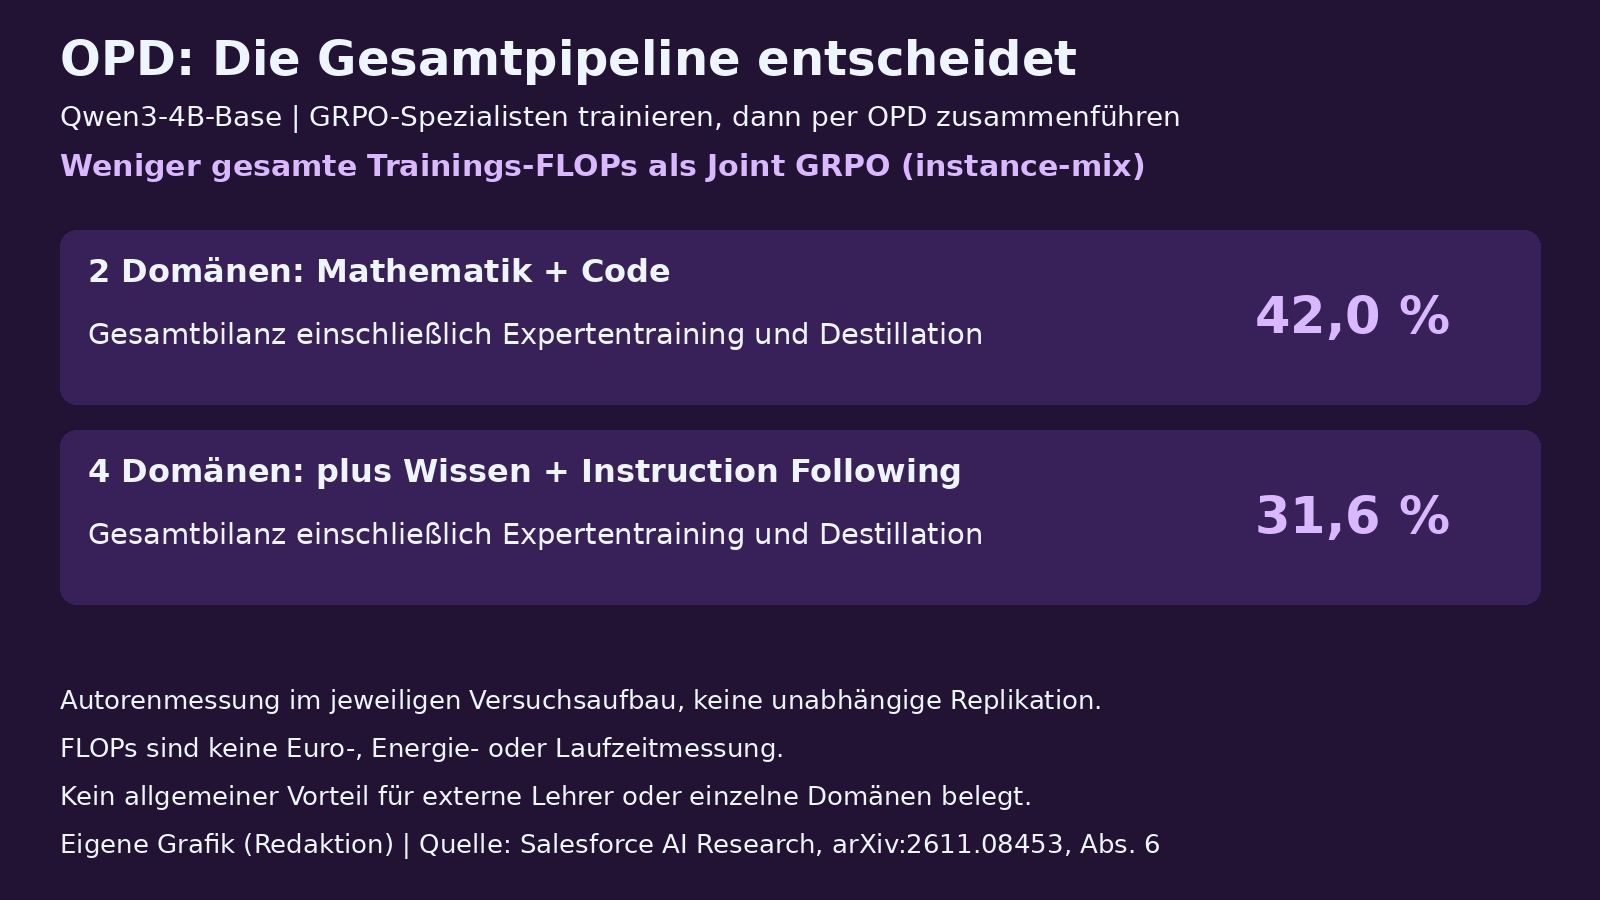
In Abschnitt 6 trainieren die Autoren aus Qwen3-4B-Base pro Domäne einen GRPO-Spezialisten und destillieren diese in einen frischen gemeinsamen Schüler. Gegenüber Joint GRPO mit instance-mix melden sie 42,0 Prozent weniger gesamte Trainings-FLOPs bei Mathematik plus Code und 31,6 Prozent bei vier Domänen einschließlich Wissen und Instruction Following. Beide Stufen sind eingerechnet. Die reine Destillationsphase addiert 5,2 beziehungsweise 8,0 Prozent zur jeweiligen Spezialisten-Rechenarbeit; das ist ein anderer Nenner als bei der Gesamtersparnis. Auf einer einzelnen Domäne liegt das trainierte Zielmodell schon vor, weshalb Destillation zusätzliche Gesamtarbeit wäre. Die Autorenmessung zählt generierte Tokens, nicht den geteilten Promptkontext, und ersetzt keine Geld-, Energie- oder Laufzeitmessung.
Quellen
- Formally verifying agent-written full-stack web apps with PDD Kit, Microsoft Research (abgerufen 2026-11-08)
- Inside GitHub's new Git storage architecture, GitHub Engineering (abgerufen 2026-11-08)
- Unpacking the Compute Efficiency of Strong-to-Weak OPD against GRPO, Salesforce AI Research / arXiv (abgerufen 2026-11-08)