 KI
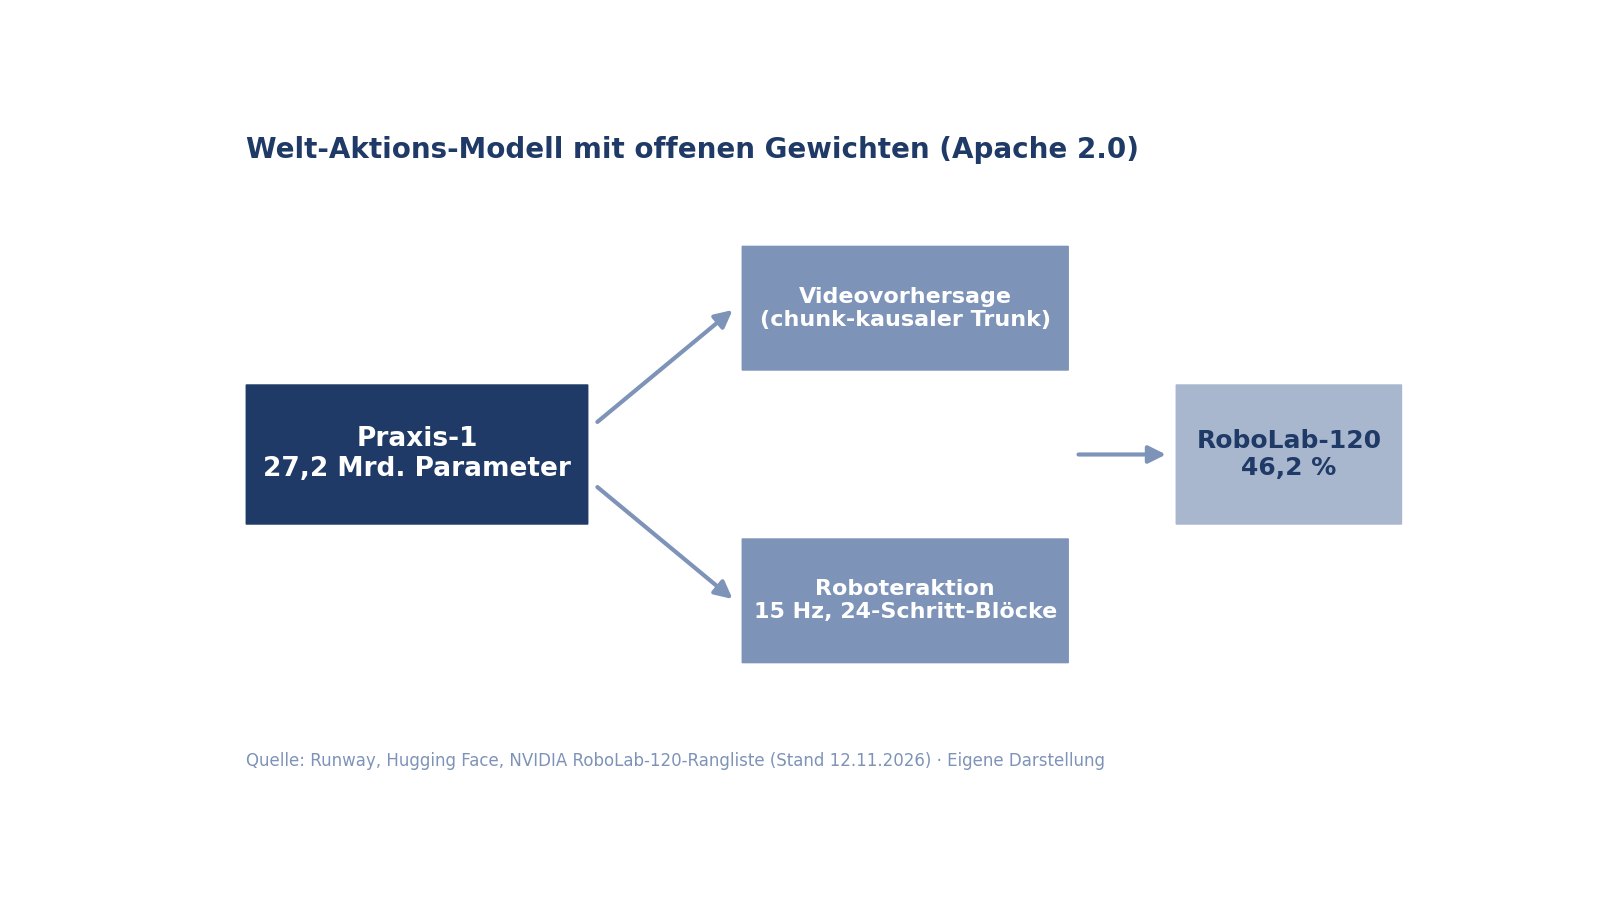
Runway, bislang vor allem für Video-KI bekannt, hat am 11. November 2026 Praxis-1 veröffentlicht: ein Welt-Aktions-Modell (World Action Model, WAM) für Roboter mit offenen Gewichten unter Apache 2.0 [1]. Die Gewichte stehen auf Hugging Face, der zugehörige Inferenz- und Fine-Tuning-Code auf GitHub [2][3]. Runway hatte das Modell erstmals im September angekündigt [1].
Was veröffentlicht wurde
Auf Hugging Face stehen mehrere Checkpoints bereit: praxis-1-base ohne Aktionsköpfe als Ausgangspunkt für eigenes Training, praxis-1-droid für einarmige DROID-Roboter und praxis-1-yam für den bimanuellen YAM-Aufbau, jeweils ergänzt um NVFP4-quantisierte Varianten und LeRobot-kompatible Layouts [1][2]. Die Repositories sind laut Plattform-API unter Apache 2.0 lizenziert und ohne Zugangsbeschränkung abrufbar (Stand 12.11.2026) [2][5]. Ein Checkpoint für den SO-101 ist laut Hersteller in Vorbereitung [1].
Eckdaten
Laut Modellkarte 27,2 Mrd. Parameter (Mixture-of-Experts, darunter ein Aktions-Experte mit 0,3 Mrd. Parametern) · Aktionsrate 15 Hz · Aktionsblöcke von 24 Schritten · 20-dimensionaler Aktionsraum (YAM-Variante) · bf16-Checkpoint 54,4 GB · Lizenz Apache 2.0 · Veröffentlichung 11.11.2026 [1][2]. Die Rangliste gibt abweichend 27,3B an; die Quellen zählen oder runden hier unterschiedlich [2][4].
Architektur: Videomodell trifft Aktions-Experten
Praxis-1 ist laut Modellkarte ein Mixture-of-Experts-Videodiffusions-Modell: Ein chunk-kausaler Trunk sagt den nächsten Videoabschnitt voraus, ein separater Aktions-Experte mit 0,3 Mrd. Parametern leitet daraus einen Block von 24 Aktionen ab, der mit 15 Hz auf dem Roboter ausgeführt wird [2]. Als eingefrorene Bausteine nutzt das Modell den VAE aus Wan2.2 und den Textencoder Qwen3.5-2B [2]. Fürs Vortraining wurden laut Runway Webvideos mit teleoperierten Robotervideos abgeglichen; das ist eine Herstellerangabe, die wir nicht nachgeprüft haben [1].
Benchmarks: Was die Zahlen aussagen
Runway nennt für Praxis-1 eine Erfolgsrate von 46,2 Prozent auf RoboLab-120, einem Roboter-Benchmark von NVIDIA mit 120 Aufgaben [1]. Unser Abgleich mit der Live-Rangliste am 12. November 2026 bestätigt den Wert: Verzeichnet sind 555 erfolgreiche von 1200 Episoden, also 10 Episoden pro Aufgabe [4]. Die Quote 555/1200 ergibt 46,25 Prozent; 46,2 Prozent ist der ausgewiesene Ranglistenwert, kein von uns neu gerundeter Wert.
Die Rangliste ordnet den Wert allerdings anders ein als der Hersteller: Praxis-1 belegt Platz 5 der Gesamtliste und ist der beste Eintrag vom Typ WAM. Vier Einträge anderer Policy-Typen liegen höher: AMP1 mit 86,0 Prozent, SenseNova-RoboRSI mit 57,1, Lakeside mit 51,0 und BiMind v0.5 mit 49,2 Prozent [4]. Runways Formulierung, Praxis-1 sei das leistungsstärkste Welt-Aktions-Modell der Rangliste, trifft damit innerhalb der WAM-Kategorie zu. Der Zusatz, das Modell übertreffe jedes VLA-Modell mit offenen Gewichten, lässt sich an der Rangliste nicht vollständig prüfen: Das als VLA geführte BiMind v0.5 liegt mit 49,2 Prozent vor Praxis-1; ob dessen Gewichte offen sind, geht aus der von uns gelesenen Seite nicht hervor [4].
Zudem variieren die Auswertungsbudgets: AMP1 und Lakeside wurden mit 25 Episoden pro Aufgabe (bis zu 3000 Episoden) getestet, Praxis-1 und die übrigen WAM-Einträge mit 10 Episoden pro Aufgabe (1200 Episoden) [4]. Für den SimplerEnv-Benchmark mit dem RT-1-Aufgabenset nennt Runway 80,0 Prozent Erfolgsrate gegenüber 52,4 Prozent der ursprünglichen RT-1-Policy; auch das ist eine Herstellerangabe ohne eigene Nachprüfung [1].
Daten als Tabelle
| Erfolgsrate | |
|---|---|
| Praxis-1 (Runway) | 46,2 |
| FLUX 3 Action (BFL) | 42,9 |
| Cosmos3-Nano (NVIDIA) | 36,8 |
| DreamZero (NVIDIA) | 25,7 |
| Cosmos3-Edge (NVIDIA) | 22,9 |
Erfolgsrate auf NVIDIAs RoboLab-120 (120 Aufgaben, 10 Episoden pro Aufgabe), Live-Rangliste vom 12.11.2026, Einträge vom Typ WAM. Einträge anderer Policy-Typen liegen teils höher (Spitze 86,0 Prozent), zum Teil mit 25 Episoden pro Aufgabe [4].
Fine-Tuning und Betrieb
Das GitHub-Repository (Apache 2.0; angelegt am 26.10.2026 laut Plattform-API) enthält Inferenzcode, eine Fine-Tuning-Anleitung mit durchgearbeitetem DROID-Beispiel und LoRA-Training auf einer GPU mit 80 GB Speicher sowie eine Auswertungsanleitung für die Simulation [3]. Für den Schnelleinstieg nennt die README Python 3.12, eine CUDA-GPU mit mindestens 80 GB und einen CUDA-13.0-Treiber [3]. Runway listet zudem H100-, B200-, RTX-5090- und RTX-PRO-6000-Karten sowie Jetson Thor als unterstützt [1]; ob dafür die NVFP4-Varianten nötig sind, geht aus den Quellen nicht hervor. Eigene Hardwaretests haben wir nicht durchgeführt.
Einordnung
Praxis-1 reiht sich in eine wachsende Zahl offener Weltmodelle für die Robotik ein. Bemerkenswert ist der Schritt, weil die Gewichte unter einer freizügigen Lizenz ohne Zugangshürde stehen und der Hersteller Fine-Tuning auf einer einzelnen 80-GB-GPU dokumentiert [2][3]. Praktisch bleibt der Speicherbedarf die Hürde: Der bf16-Checkpoint belegt 54,4 GB, die Rangliste weist rund 70 GB VRAM für den Einsatz aus [2][4]. Ob die quantisierten Varianten die Leistung halten, ist aus den Quellen nicht ersichtlich. Partner wie Noble Machines, Standard Bots und Ultra testen das Modell laut Runway bereits in ihren Robotern [1]. Die eingefrorenen Abhängigkeiten Wan2.2-VAE und Qwen3.5-2B werden separat unter ihren eigenen Lizenzen verteilt [2][5].
Methode
Recherche am 12. November 2026 gegen 6 Uhr UTC (7 Uhr MEZ): Herstellerbeitrag auf runway.com, Modellkarten und Lizenzangaben auf Hugging Face (Plattform-API), README und Dokumentationsdateien des GitHub-Repositorys sowie die Live-Rangliste von RoboLab-120 auf research.nvidia.com, alle selbst geöffnet und gelesen. Benchmark-Werte stammen aus Herstellerangaben und der von NVIDIA geführten Rangliste; eigene Modell- oder Hardwaretests haben wir nicht durchgeführt. Ergänzender Quellenabgleich: 12.11.2026, 07:15 MEZ. Keine Modellläufe oder Käufe ausgeführt.
Grenzen
Die Erfolgsraten stammen aus Herstellerangaben und einer vom Benchmark-Betreiber (NVIDIA) geführten Rangliste, nicht aus unabhängiger Überprüfung. Ob die Gewichte des höher platzierten VLA-Eintrags BiMind v0.5 offen sind, konnten wir nicht klären. Die Auswertungsbudgets der Rangliste sind uneinheitlich (10 beziehungsweise 25 Episoden pro Aufgabe). Zur Leistung der NVFP4-Varianten und zum angekündigten SO-101-Checkpoint liegen keine Daten vor.
Quellen
- Praxis-1 is now available (Ankündigung, 11.11.2026), Runway (abgerufen 2026-11-12) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- runwayml/praxis-1-yam (Modellkarte), Hugging Face (abgerufen 2026-11-12) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- runwayml/praxis-1-oss (Repository mit README und Anleitungen), GitHub (abgerufen 2026-11-12) ↩1 ↩2 ↩3 ↩4 ↩5
- RoboLab-120 Leaderboard (Live-Rangliste), NVIDIA Research (abgerufen 2026-11-12) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- runwayml/praxis-1-base (Modellkarte und Lizenzangabe), Hugging Face (abgerufen 2026-11-12) ↩1 ↩2