 KI
Quellenabgleich: 11. November 2026, 07:16 Uhr MEZ. Das Institute of Foundation Models (IFM), eine Forschungseinrichtung der Mohamed bin Zayed University of Artificial Intelligence (MBZUAI), hat am 10. November 2026 PAN 2 veröffentlicht: ein allgemeines Weltmodell, das zu einer Ausgangsszene (optionales Bild plus Text) und einer in Worten beschriebenen Aktion ein Video der Folgen simuliert. Die eigenen Gewichte sowie Code für Pretraining, SFT und Inferenz stehen unter Apache 2.0. Das Repository stellt aber ausdrücklich klar: Reward-Learning und Model-Soup, die zu den veröffentlichten Gewichten beitragen, sind nur im Bericht beschrieben und nicht im Trainingscode enthalten. Wir haben Modellkarte und GitHub-Repository eingesehen [1][3][4]. IFM nennt das dahinterstehende Konzept "simulative reasoning": Ein Agent stellt sich die Ergebnisse seiner Handlungsoptionen vor, bevor er handelt [1][2].
Eckdaten
Architektur: Zwei Backbones, ein Zwischenzustand aus Text
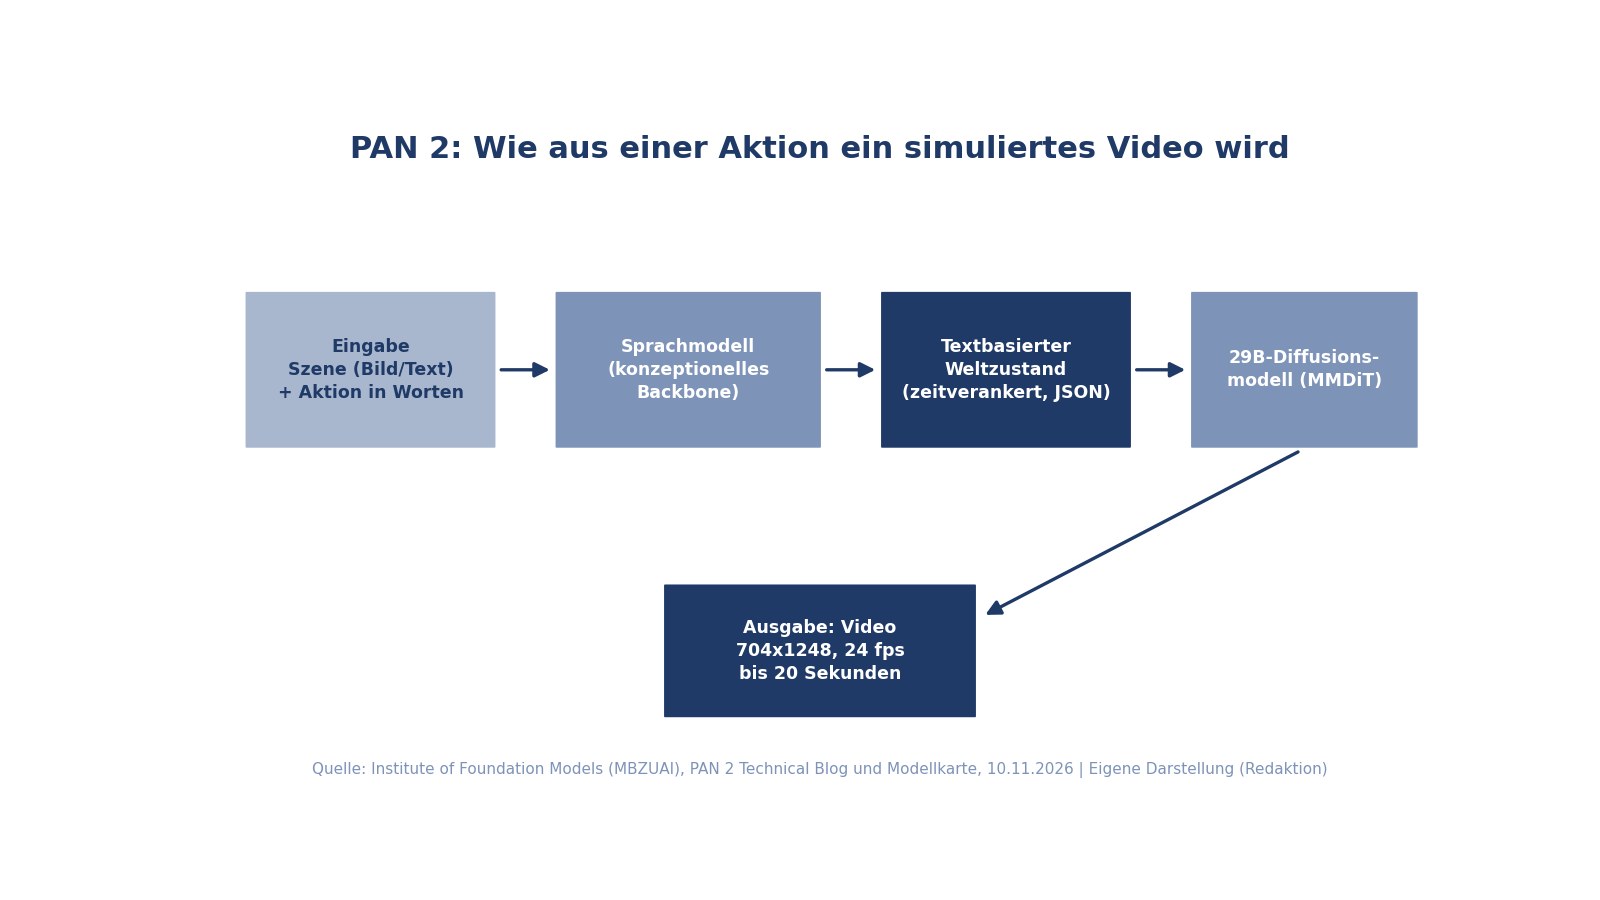
PAN 2 folgt der Generative-Latent-Prediction-Architektur (GLP) und teilt die Arbeit in zwei Backbones. Das konzeptionelle Backbone ist ein großes Sprachmodell: Es liest Beobachtung und Aktionsanweisung und schreibt den nächsten Weltzustand als strukturierte, zeitverankerte Textbeschreibung - mit Subjekten, getakteten Aktionen und Kamerabewegungen im JSON-Format. Das perzeptuelle Backbone ist ein latentes Diffusionsmodell (MMDiT) mit 29 Milliarden Parametern, das IFM von Grund auf mit realen Videos trainiert hat; es ergänzt die wahrnehmbaren Details, die der Text offenlässt. Als eingefrorener Textkodierer dient Qwen3.5-9B, als Video-Dekoder die VAE von Wan 2.2 [2][3].
Die Ausgabe sind Videos mit 704x1248 Pixeln bei 24 Bildern pro Sekunde und bis zu 20 Sekunden Länge (481 Frames), in BF16-Präzision. Veröffentlicht ist ein einzelner Checkpoint, der Text-zu-Video und Bild-zu-Video abdeckt; die Inferenzanleitung nennt 50 Sampling-Schritte und einen Guidance-Scale von 2,5. Neben dem eigenen generate.py-Skript werden Diffusers und vLLM unterstützt [3].
Verfügbarkeit und Lizenz
Die Gewichte liegen ungeschützt (kein Gating) auf Hugging Face unter Apache 2.0, der Code im GitHub-Repository ifm-ai/PAN2 ebenfalls unter Apache 2.0. Die Pressemitteilung spricht von vollständigem Trainingscode. Das Repository grenzt dies enger ein: Pretraining und SFT sind enthalten, Reward-Learning und Model-Soup nicht. Trainingskonfigurationen, Inferenzskripte und Dokumentation sind öffentlich [1][3][4]. IFM empfiehlt ausdrücklich, das Modell hinter dem separat veröffentlichten Guardrail-Paket zu betreiben [3].
Messwerte aus IFMs eigenen Tests
Für die Bewertung hat IFM eigene Testfälle entlang sechs Dimensionen physischer Intelligenz gebaut (unter anderem physikalische Konsistenz, Kausalkohärenz, Entitätenpersistenz, Kamerainvarianz). Ein VLM-Bewerter (Qwen3.8-27B) beantwortet Ja/Nein-Fragen zu jeder Simulation; Kamerabewegungen prüft zusätzlich ein Geometrie-Modul (VGGT-Ω). Der Mehrschritt-Test umfasst 100 Alltagsaufgaben als 200 Prompts mit 456 Einzelschritten; gemeldet wird der Mittelwert über drei Seeds, geschlossene Modelle liefen nur einmal. Als konzeptionelles Backbone dient im technischen Bericht standardmäßig Kimi K3 [2][3].
Ergebnis: 75,1 Prozent der Einzelschritte und 34,0 Prozent der vollständigen Pläne gelingen - Letzteres der höchste Wert unter den sechs untersuchten Modellen. Alle sechs Modelle liegen laut IFM auf einer gemeinsamen Kompoundierungskurve (R² = 0,986): Fehler akkumulieren über die Schritte, deshalb liegt die Full-Plan-Completion überall deutlich unter der Schritt-Completion. In einer Ablation mit festgehaltenem Diffusionsmodell sinkt die Full-Plan-Completion ohne konzeptionelles Reasoning auf 0,0 Prozent, mit reiner Umformatierung auf 27,8 und mit vollem Reasoning auf 34,0 Prozent - IFMs Beleg dafür, dass die Reasoning-Tiefe und nicht nur das Eingabeformat die Plansimulation trägt [2].
Daten als Tabelle
| Full-Plan-Completion | |
|---|---|
| PAN 2 | 34 |
| MiniMax-H3 | 32,5 |
| FLUX 3* | 26,8 |
| Seedance 2.5* | 24,5 |
| Cosmos 3 Super | 9,5 |
| LTX-2.5 | 4 |
Anteil der Simulationen, in denen alle Schritte eines Plans gelangen. IFM-eigener Test: 100 Alltagsaufgaben, 200 Prompts, 456 Schritte, Mittelwert über 3 Seeds; FLUX 3 und Seedance 2.5 sind geschlossen und liefen nur mit einem Seed. Herstellerwerte, von uns nicht nachgeprüft [2].
Öffentliche Benchmarks und die Leaderboard-Frage
Zur Physics-IQ-Verified-Leaderboard schreibt IFM, PAN 2 läge dort "im Leaderboard-Setting" auf Rang drei insgesamt und Rang eins unter offenen Modellen - gemeint ist die im Herstellerbericht verwendete Leaderboard-Konfiguration, bei der Claude Opus 5.5 als konzeptionelles Backbone dient. Wir haben die öffentlich abrufbare Ranglistenansicht am 11. November um 07:16 Uhr MEZ gelesen: Darin fanden wir keinen PAN-2-Eintrag. Die Aussage ist damit ein Vergleich des Herstellers aus eigenen Läufen, kein von der Rangliste ausgewiesener Stand [2][5]. Zum Robotik-Benchmark RBench nennt der Blog Konfigurationen (unter anderem GPT-6 Astra als Backbone für PAN 2), berichtet die Ergebnisse aber in Grafiken, aus denen wir keine exakten Einzelwerte übernehmen konnten [2].
Menschliche Bewertung und Guardrails
In verblindeten Paarvergleichen (140 Prompts, 13 Bewertende, 1.400 Vergleiche, Elo per Bradley-Terry-Modell) landet PAN 2 nach IFM-Angabe auf Rang zwei unter vier offenen Modellen; bewertet wurden Aktionsbefolgung, physikalische Plausibilität und Weltkonsistenz [2]. Das empfohlene Guardrail-Paket kombiniert Qwen3Guard-Gen-4B vor der Generierung mit dem Frame-Klassifikator Q16 danach: In IFM-internen Tests sank der Anteil schädlicher Text-zu-Video-Anfragen mit unsicherem Ergebnis von 33,9 auf 1,5 Prozent; zugleich wurden 11,5 Prozent harmloser Text-zu-Video- und 3,3 Prozent harmloser Bild-zu-Video-Anfragen blockiert. Bei Bild-zu-Video wurden keine unsicheren Ausgaben beobachtet. Die Modellkarte betont, dass die Filter das Risiko senken, aber nicht beseitigen [3].
Was im Training steckt
Der technische Blog dokumentiert ungewöhnlich viel Trainingsdetail. Drei Beispiele: Erstens trainierte IFM Vergleichsmodelle (je 9B, 40.000 Schritte) mit und ohne synthetische Inhalte; das Modell ohne Gameplay-, Animations- und Render-Videos gewann 58 Prozent der verblindeten Stimmen - woraufhin synthetische Inhalte nach der frühesten Trainingsphase ausgeschlossen wurden. Zweitens schnitten strukturierte JSON-Beschreibungen der Trainingsclips besser ab als zwei Klartext-Varianten: Sie trugen mehr unterscheidbare Aussagen pro Video (49,43) und erzielten den niedrigsten Verlust auf zurückgehaltenen Videos. Drittens verfeinerte IFM das Modell mit belohnungsbasiertem Lernen (ReFL über das eingefrorene VisionReward-Modell, 600 Schritte): Kausalkohärenz stieg um 8,5 Punkte, Full-Plan-Completion um 3,7 Punkte, während Kamerainvarianz und physikalische Konsistenz leicht fielen; das finale Modell ist ein gewichteter Mittelwert der Checkpoints vor und nach dieser Phase, um Reward-Hacking abzufedern [2].
Agenten lernen in der Simulation
IFM zeigt zwei Agenten-Experimente: Beim Papierflieger-Falten trägt PAN 2 laut IFM den Weltzustand schrittweise weiter, indem das letzte Frame jedes Clips das Startbild des nächsten wird. Im zweiten Experiment muss ein auf Kimi K3 aufbauender Agent eine Kugel aus einer Röhre holen; dass der rote Deckel festgeklebt ist, steht nur im Text für PAN 2, nicht für den Agenten. Nach fünf Fehlversuchen am roten Deckel - darunter eine Fehlinterpretation einer Simulation - öffnet der Agent im sechsten Versuch den blauen Deckel und die Kugel kommt heraus. Als offene Schritte nennt IFM eine Welt, die während der Exploration konsistent weiterwächst; langfristige Weltkonsistenz bezeichnet auch die Pressemitteilung als ungelöst [1][2]. Die Beschreibung der Demonstrationen stammt aus dem Blog; schwierige Faltanweisungen wurden laut IFM von Hand verfeinert und verschlechterte Startbilder wiederhergestellt. Das ist kein unabhängiger Robustheitstest.
Einordnung
PAN 2 veröffentlicht eigene Gewichte, Code für Pretraining und SFT sowie Inferenz, Datenrezepte und Ablationsstudien. Die Sechs-Modelle-Tabelle samt Kompoundierungskurve ist im Bericht dokumentiert. Nicht im Code enthalten sind Reward-Learning und die Zusammenführung der Checkpoints (Model-Soup). Zugleich sind fast alle Leistungsdaten Hersteller-Messungen mit herstellereigenen Testfällen und herstellergewählten Bewertungsmodellen; die prominenteste Vergleichsaussage - Rang drei auf Physics-IQ Verified - ist zum Recherchezeitpunkt nicht auf der öffentlichen Rangliste abgebildet. Der praktische Einstieg ist anspruchsvoll: Das 29B-Diffusionsmodell in BF16 hat hohen Speicherbedarf, und für gute Ergebnisse soll ein Reasoning-LLM die Prompts in das strukturierte Zustandsformat umschreiben [2][3].
Grenzen dieser Analyse
- Keine eigenen Tests: Wir haben PAN 2 nicht selbst ausgeführt; alle Leistungs- und Sicherheitswerte sind Herstellerangaben [1][2][3].
- Herstellereigene Bewertung: Testfälle, VLM-Bewerter und Geometrie-Prüfer stammen von IFM; geschlossene Vergleichsmodelle liefen nur mit einem Seed [2][3].
- Leaderboard-Aussage unbestätigt: Der behauptete dritte Gesamtrang auf Physics-IQ Verified war auf der öffentlichen Rangliste am 11.11.2026 (morgens) nicht abgebildet [2][5].
- Prüfumfang: Wir haben die Textabschnitte und Texttabellen des Blogs abgeglichen. Interaktive Demo-Videos, reine Grafikwerte und die Trainingsvideos haben wir nicht eigenständig ausgewertet; daraus übernehmen wir keine exakten Werte [2].
Methode
Analyse auf Basis der gelesenen PAN-2-Pressemitteilung und des gelesenen technischen Blogs des IFM (jeweils 10.11.2026), der Hugging-Face-Modellkarte IFM/PAN2 und des GitHub-Repositorys ifm-ai/PAN2 (alle abgerufen am 11.11.2026). Die Platzierungsaussage zur Physics-IQ-Verified-Leaderboard haben wir am 11.11.2026 um 07:16 Uhr MEZ durch Abruf der öffentlichen Rangliste gegengeprüft. Sämtliche Messwerte sind Herstellerangaben. Keine eigenen Tests.
Grenzen
Keine eigenen Tests; wir haben das Modell nicht ausgeführt. Nahezu alle Leistungsdaten stammen aus IFM-eigenen Testfällen mit IFM-gewählten Bewertungsmodellen (VLM-Bewerter Qwen3.8-27B, Geometrie-Prüfer VGGT-Ω); geschlossene Vergleichsmodelle liefen nur mit einem Seed. Die Leaderboard-Platzierung ist ein eigener Herstellervergleich und war auf der öffentlichen Rangliste zum Recherchezeitpunkt nicht abgebildet. Grafik-only-Ergebnisse (Physics-IQ-, RBench- und Elo-Diagramme) haben wir nicht als Zahlen übernommen. Ob es unabhängige Fremdmessungen gibt, können wir nicht ausschließen. Reward-Learning und Model-Soup der finalen Gewichte sind im öffentlichen Trainingscode nicht enthalten.
Quellen
- PAN 2 Press Release (10.11.2026), Institute of Foundation Models (MBZUAI) (abgerufen 2026-11-11) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- PAN 2: A foundation world model for physical intelligence (Technical Blog, November 2026), Institute of Foundation Models (MBZUAI) (abgerufen 2026-11-11) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- IFM/PAN2 (Modellkarte), Hugging Face (abgerufen 2026-11-11) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- ifm-ai/PAN2 (Trainings- und Inferenzcode), GitHub (abgerufen 2026-11-11) ↩1 ↩2 ↩3
- Physics-IQ Verified (öffentliche Leaderboard, Abgleich der Platzierungsaussage), physics-iq-verified.anates.ai (abgerufen 2026-11-11) ↩1 ↩2 ↩3