 KI
Mittagsüberblick vom 2. November 2026. Quellenstand: 09:57 Uhr MEZ. Drei Entwicklungen mit Praxisbezug: eine Kennzeichnungspflicht mit implementierungsbedingter Lücke, ein quelloffener Computer-Use-Agent in der 4B-Klasse und ein Forschungsansatz, der Bewertungsmodelle durch Messdaten ersetzt. Alle Primärquellen vollständig gelesen.
1. Wasserzeichen-Ausweitung ab morgen - die Sampling-Lücke ist der relevante Teil
Anthropic erweitert ab dem 3. November sein Text-Wasserzeichen auf Claude Mythos 5, Opus 4.7, Opus 4.6 und Sonnet 4.6. Das berichten The Decoder und Mashable übereinstimmend aus einer E-Mail an API-Kunden; die Modelle nach dem 2. August 2026 tragen die Markierung laut Anthropics Hilfeseite bereits seit Launch. Technisch handelt es sich um eine SynthID-Text-Variante: ein statistisches Muster in der Token-Auswahl, ohne Zusatzzeichen und laut Anbieter ohne Einfluss auf Sinn, Qualität oder Lesbarkeit.
Der operativ wichtige Punkt steht bei The Decoder: Auf Opus 4.6 und Sonnet 4.6 greift das Wasserzeichen nur, wenn temperature, top_p und top_k auf ihren Defaultwerten bleiben. Jede Abweichung bei einem der drei Sampling-Parameter reicht demnach, die Markierung zu vermeiden. Anthropic selbst warnt in der Mail: "If you rely on the watermark for your own compliance, keep these settings at their defaults." Für Mythos 5 und Opus 4.7 wird diese Einschränkung in der Mail nicht genannt - ob das Wasserzeichen dort parametrisch robuster ist, ist unbelegt. Auf Amazon Bedrock kann der Rollout wenige Tage länger dauern.
Als Begründung für die Nachrüstung älterer Modelle nennt Anthropic die Dezember-Frist der EU-KI-Verordnung; das Unternehmen hat den Verhaltenskodex zu Artikel 50(2) unterzeichnet. Die Detection-API läuft als Private Preview für Regulierer, Medien, Forschende und Compliance-verpflichtete Unternehmen - ein öffentlicher Nachweis ist nicht möglich. The Decoder ordnet ein: OpenAIs Vergleichssystem textGrain ist nur in der EU default-aktiv, Googles SynthID-Text ist quelloffen. Kritik kommt von John Gruber (Wortwahl-Eingriffe seien nie qualitätsneutral) und von Artificial Lawyer (Kanzlei-Szenarien mit KI-Verboten). Beides sind Meinungsbeiträge, keine Messungen.
2. Mage-VL-Cowork: Microsofts 4B-Agent fusioniert GUI- und Terminal-Kontrolle
Microsoft hat Mage-VL-Cowork heute auf Hugging Face unter Apache 2.0 veröffentlicht. Das Besondere laut Modellkarte: Ein einzelnes 4B-Vision-Language-Modell entscheidet selbst, wann es per Screenshot und Mausaktionen (computer_use) und wann es per Code und Terminal (bash) arbeitet - ohne externen Orchestrator. Basis ist Qwen3-4B-Instruct-2507 mit einem eigenen Vision-Backbone (Mage-ViT); Speicherbedarf rund 9,5 Gigabyte in bfloat16.
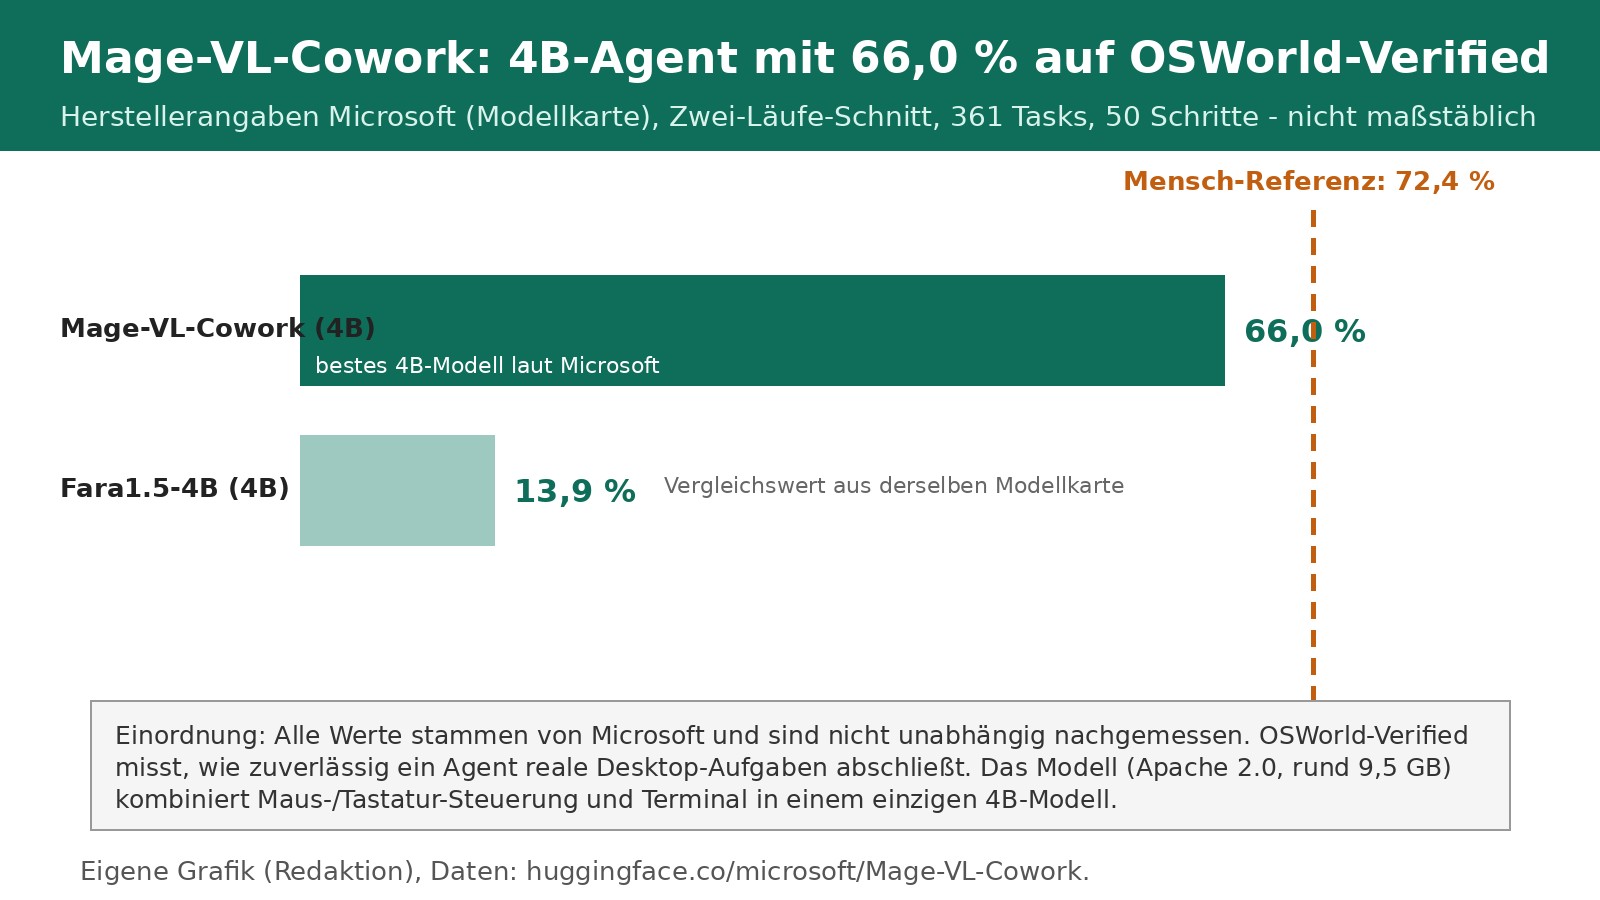
Die Kernzahl: 66,0 Prozent auf OSWorld-Verified (361 gehaltene Tasks, 50-Schritte-Budget), ermittelt als Schnitt zweier kompletter Benchmark-Durchläufe (65,33% und 66,75%). Das ist laut Microsoft der beste Wert in der 4B-Klasse - zum Vergleich nennt die Modellkarte Fara1.5-4B mit 13,9 Prozent - und liegt unter der menschlichen Referenz von 72,4 Prozent. Alle Werte sind Herstellerangaben; unabhängige Replikationen stehen aus.
Für das Training nennt Microsoft bemerkenswerte Details: eine fünfstufige Pipeline (+20,44 Prozentpunkte von GUI-SFT bis Online-RL), Online-Verstärkungslernen mit +10,16 Punkten gegenüber reinem SFT bei gleichzeitig 13,0 Prozent weniger Modellaufrufen und 25,4 Prozent weniger Ausgabetokens, sowie Mage-CUA-Forge, eine Synthese-Engine, die 293.806 Aufgaben über 6.915 atomare Fähigkeiten erzeugte. Auch der Teacher (GPT-5.4 in einem bereinigten Harness, 92,0%) ist dokumentiert. Wer eigene Computer-Use-Agenten baut, bekommt hier ein vollständiges Rezept statt nur Gewichte.
3. EditAgent: Verifikationsdaten schlagen trainierte Bewertungsmodelle
Adobe Research und UC San Diego legen mit EditAgent (arXiv 2610.39664) eine Antwort auf ein bekanntes Problem vor: Agentische Bildbearbeitung scheitert oft an der Selbstbewertung. In ihrem 600-Edits-Benchmark (blind bewertet von fünf Profis) lieferte der General-Editor Flux-2-Klein-9B in 42,7 Prozent der Fälle kein brauchbares Ergebnis; spezialisierte Werkzeuge lösten rund zwei Drittel dieser Versager, weitere Wiederholungen mit demselben Editor fast nichts. Parallele Varianten aus dem Original schlugen iterative Verfeinerung in 78,5 Prozent der Vergleiche - bei halbiertem Evaluationsaufwand.
Der zentrale Befund betrifft den Judge: Sieben unveränderte VLMs, die statt des Gesamtbilds einen Verifikationsdatensatz sehen (Ausschnitt des editierten Bereichs, Änderungskarte, gemessene Helligkeits- und Farbstatistik), übertrafen allesamt jedes feingetunte Bewertungsmodell. Bestwert: Qwen3.8-27B mit 81,3 Prozent usable picks gegenüber EditScore-72B mit 74,8 Prozent. Eine History-Prüfung fängt zudem Fälle ab, in denen spätere Schritte frühere Edits still rückgängig machen.
Die Kehrseite: EditAgent braucht laut Paper rund zehnmal so viel Rechenleistung wie ein Einzeleditor, und die Qualität hängt vom angeschlossenen Werkzeugpool ab. Als Datengenerator ist der Ansatz dagegen validiert: Aus 25.700 verifizierten Ergebnissen feingetunte Editoren verbesserten sich auf allen drei Benchmarks, während direkt von FLUX erzeugte Trainingsdaten das eigene Modell verschlechterten. Einordnung: eigener Benchmark der Forscher, Prototyp ohne Produktzusage - aber methodisch relevant für alle, die Agenten-Output automatisiert bewerten.
Quellen
- How Claude marks AI-generated content (Hilfeseite), Anthropic (abgerufen 2026-11-02)
- Anthropic's watermark rollout leaves a loophole on two older Claude models, The Decoder (abgerufen 2026-11-02)
- Anthropic expands text watermarking to older Claude versions beginning November 3, Mashable (abgerufen 2026-11-02)
- microsoft/Mage-VL-Cowork (Modellkarte, Apache 2.0), Hugging Face / Microsoft (abgerufen 2026-11-02)
- Mage-VL-Cowork: 4B Hybrid GUI + Code Computer-Use Agent (Projektseite), Microsoft (abgerufen 2026-11-02)
- EditAgent: Rethinking Agentic Image Editing (Paper), arXiv (Adobe Research / UC San Diego) (abgerufen 2026-11-02)
- Adobe is testing how well AI agents can use editing tools like a Photoshop professional would, The Decoder (abgerufen 2026-11-02)