 KI
Mistral hat am 29. Oktober 2026 die Gewichte von Mistral Large 4 veröffentlicht - auch genannt 'Le Chonk'. Nach der Public Preview Anfang des Monats ist das Modell jetzt auf Hugging Face verfügbar, in zwei offiziellen Varianten (FP8 sowie NVFP4, Letzteres für Blackwell-GPUs) sowie als GGUF-Quantisierungen von Unsloth und dem llama.cpp-Team [1][3]. Was wir in unserer Analyse der Ankündigung noch als Zusage notiert hatten, ist damit eingelöst.
Die Eckdaten
| Eigenschaft | Wert |
|---|---|
| Parameter gesamt / aktiv pro Token | ~1 Billion / 49 Mrd. (52 Mrd. inkl. Einbettungen und Ausgabeschicht) |
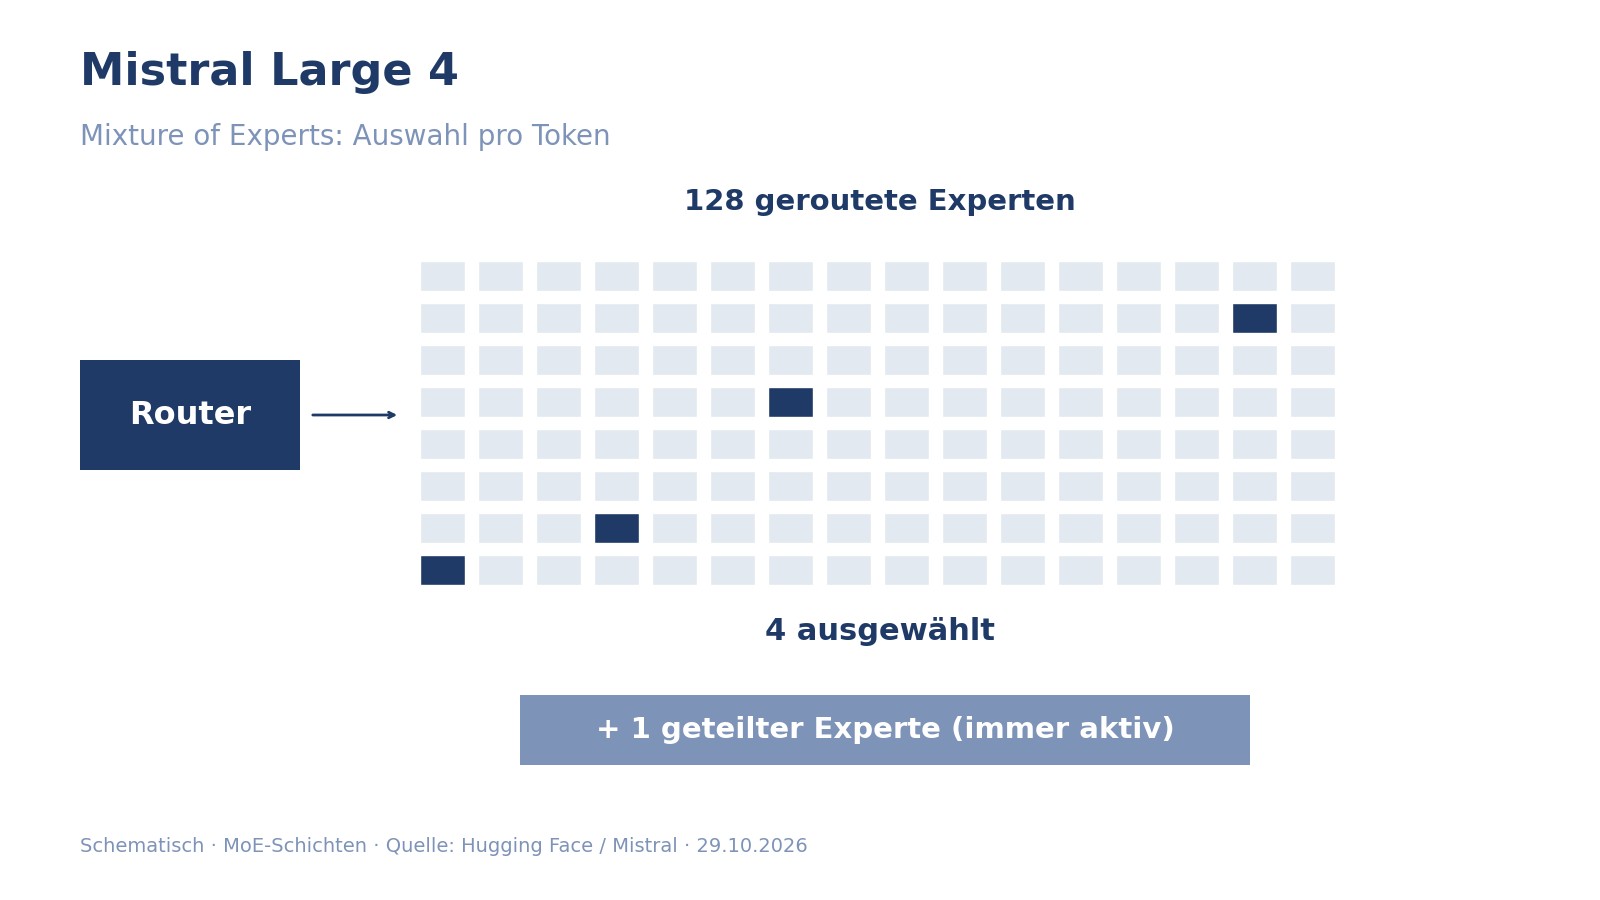
| Expertenarchitektur | 128 geroutete Experten, 4 aktiv pro Token + 1 geteilter Experte |
| Kontextfenster | 1 Million Tokens |
| Modalitäten / Sprachen | Text + Bild rein, Text raus; 160+ Sprachen, darunter alle Amtssprachen der EU |
| Training | Von Grund auf trainiert auf 3.800 NVIDIA Grace Blackwell GPUs in Mistrals eigenen EU-Rechenzentren |
| Lizenz | Mistral Ecosystem Open-Weight License (MIT-Derivat; MaaS-Betrieb nur mit separater Lizenz) |
| Varianten | FP8 und NVFP4 offiziell; GGUF-Quants von Unsloth/llama.cpp; eingebetteter DSpark-Speculative-Decoding-Kopf |
Architektur: zweifache Sparsity
Der Text-Decoder hat 72 Schichten, eine Hidden-Dimension von 6.144 und 64 Attention-Köpfe. Zwei Sparsity-Ideen greifen ineinander: Der MoE-Router wählt pro Token vier von 128 Experten (plus einen immer laufenden geteilten), und die Attention wählt Kontextpositionen aus - Multi-head Latent Attention hält eine komprimierte KV-Repräsentation, während ein DeepSeek-Sparse-Attention-Indexer (DSA) pro Query bis zu 2.048 Schlüsselpositionen bestimmt [1]. Dazu ein 3:1-Muster aus RoPE- und NoPE-Schichten, über Schichten geteilter KV-Zustand und 'LeRope', ein YaRN-skaliertes RoPE mit einem gelernten Multiplikator pro Frequenz [1]. Die erste Schicht nutzt ein dichtes Feed-Forward-Netz [1]. Der Pixtral-Vision-Encoder (1,6 Mrd. Parameter, 30 Schichten, 14x14-Patches) verarbeitet variable Bildgrößen [1][2].
Benchmarks und der Cyber-Fokus
Mistral positioniert Large 4 für Cybersicherheit, Coding-Agenten und Multimodalität [1]. Die gemeldeten Werte stammen aus dem Hugging-Face-Blog zum Release (Anbieter- und Release-Begleitwerte ohne unabhängige Nachmessung): DeepSWE v1.1 61,7 Prozent, SWE-Atlas-QnA 59,4, Terminal-Bench 4 28,3, AutomationBench 59,9; Cybench löst das Modell 93 Prozent von 40 Wettbewerbs-Challenges, und auf Lakeras B3-Benchmark wehrt es 93,3 Prozent der Prompt-Injection-Angriffe ab [1]. Mistrals eigene Release-Seite nennt für Terminal-Bench 4.0 41 Prozent; ob beide Angaben unter vergleichbaren Bedingungen (Modellversion, Test-Harness, Setup) erhoben wurden, ist den Quellen nicht zu entnehmen - die Vergleichbarkeit der beiden Zahlen ist damit nicht gesichert [4].
Daten als Tabelle
| Mistral Large 4 | |
|---|---|
| DeepSWE | 61,7 |
| SWE-Atl. | 59,4 |
| Autom.B. | 59,9 |
| TB 4 | 28,3 |
| Cybench | 93 |
Ergebnisse aus dem Hugging-Face-Launch-Beitrag - Herstellerangaben, nicht unabhängig verifiziert [1]. Jeder Balken ist der Score des jeweiligen Tests; die Werte sind testübergreifend nicht vergleichbar und bilden keine allgemeine Leistungsrangfolge.
Bei Sicherheitsaufgaben argumentiert Mistral mit dem Defensiv-Profil: Schwachstellen reproduzieren und patchen, Malware-Analyse, Erstellung von Detection Rules - Aufgaben, bei denen geschlossene Modelle mit API-Filtern blockieren können. Gleichzeitig soll Large 4 schädliche Cyber-Anfragen häufiger ablehnen als jedes andere offene Modell (Mistral-Angabe zu JailbreakBench, StrongREJECT und AgentHarm) [1]. Die Veröffentlichung macht unabhängige Nachmessungen dieser Behauptungen möglich. Offene Gewichte sind dabei kein Nachweis für sichere Anwendung: Ein Betreiber muss sein konkretes System selbst prüfen.
Betrieb und Feinabstimmung
Day-0-Support gibt es für transformers, vLLM (empfohlen, fertiges Docker-Image), SGLang und llama.cpp; Fine-Tuning über Axolotl, Unsloth oder TRL [1][2]. Bemerkenswert: Das Reasoning lässt sich nicht abschalten [1] - die Stufen low, medium und high (Standard: high) steuern den Aufwand; empfohlen werden Temperatur 1,0 und top_p 0,95 [1][2]. Der NVFP4-Checkpoint zielt auf Blackwell-Hardware und verspricht gleiche Qualität bei kleinerem Speicherfußabdruck [2]. Wer nicht selbst hosten will: Das Modell läuft auch als 'mistral-large-4' in Mistrals API [2].
Methode
Analyse auf Basis des Hugging-Face-Launch-Beitrags, der offiziellen Modellkarte und der Verge-Meldung; alle drei Quellen wurden vollständig gelesen. Sämtliche Benchmark-Angaben sind Herstellerangaben; das Modell wurde von der Redaktion nicht selbst ausgeführt.
Grenzen
Keine eigenen Modelltests oder unabhängige Verifikation der Benchmarks. Der Ablehnungs-Vergleich bei Cyber-Anfragen ist eine Herstellerangabe. Die Verge-Meldung ist knapp und enthält keine eigenen Messungen. Hardwarebedarf, Durchsatz und Kosten eines konkreten Deployments wurden nicht gemessen.
Quellen
- Welcome Le Chonk: Mistral Large 4 on Hugging Face, Hugging Face Blog (abgerufen 2026-10-30) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- mistralai/Mistral-Large-4-1T-A52B - Modellkarte, Hugging Face / Mistral AI (abgerufen 2026-10-30) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Mistral AI has officially released its Large 4 (Le Chonk) model, The Verge (abgerufen 2026-10-30) ↩
- Mistral AI: Announcing Mistral Large 4, Mistral AI (abgerufen 2026-10-30) ↩