 KI
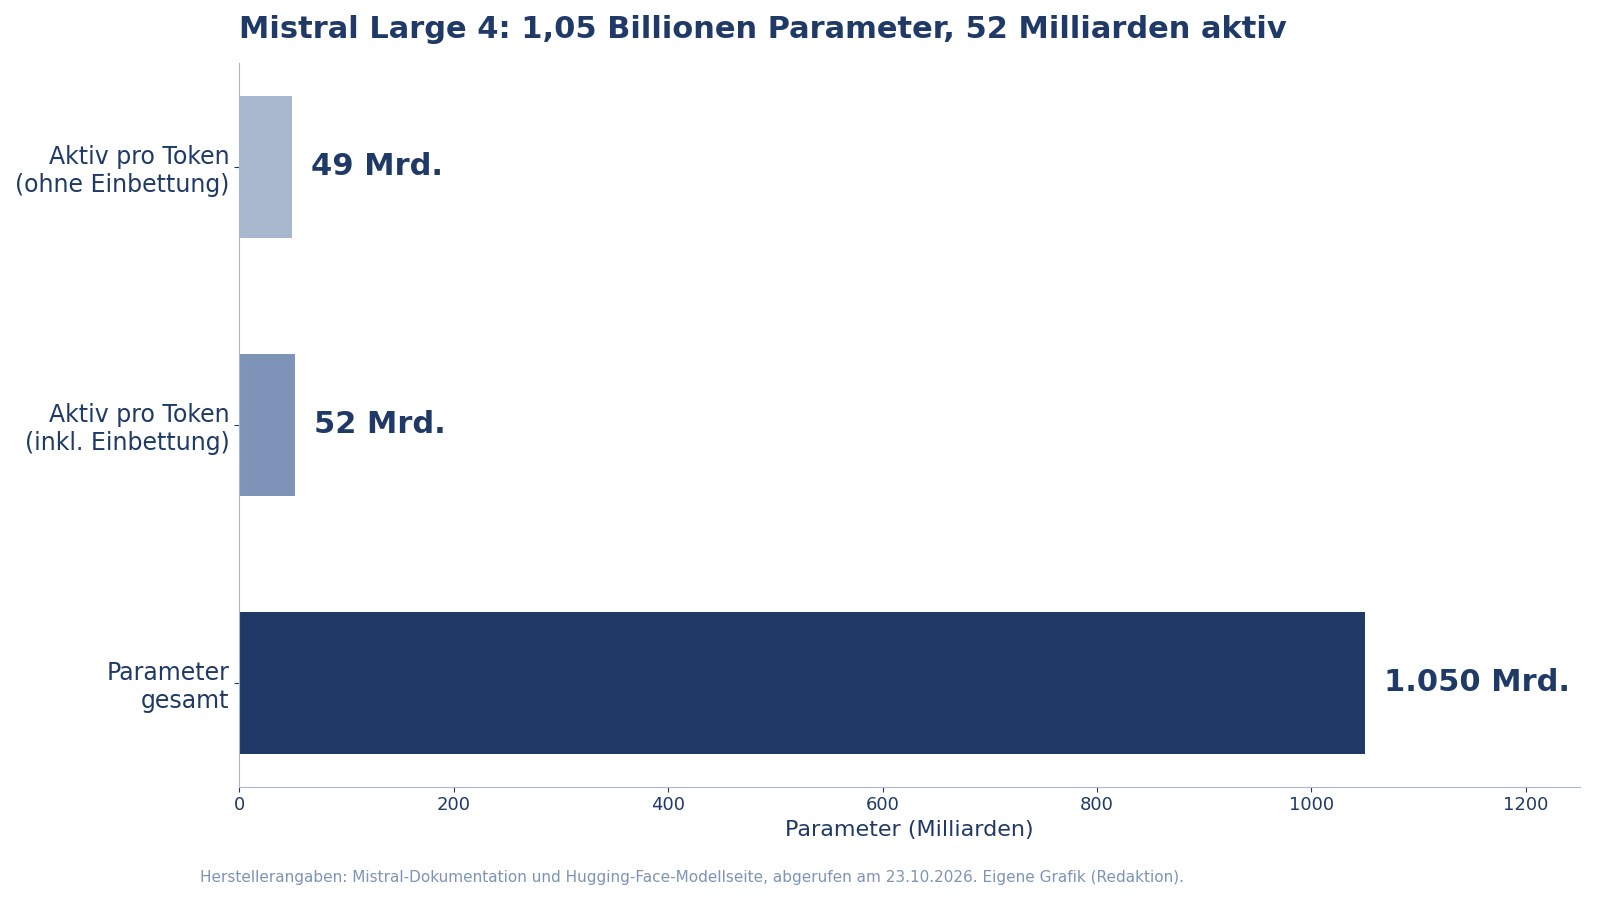
Mistral hat am 6. Oktober 2026 mit Mistral Large 4 - intern „le Chonk“ - sein bislang größtes Modell als öffentliche Vorschau freigeschaltet [1]. 1,05 Billionen Parameter gesamt, 52 Milliarden davon aktiv, ein Kontextfenster von einer Million Token: Das sind die Eckwerte, mit denen das Pariser Unternehmen in die Liga der Frontier-Modelle aufsteigen will. Die offenen Gewichte gibt es noch nicht. Auf der Hugging-Face-Seite des Modells steht als erwarteter Termin der 31. Oktober 2026, eingetragen waren zuletzt rund 925 Wartende [3]. Dieser Artikel ordnet ein, was bereits belegt ist und was bis dahin Herstellerangabe bleibt.
Architektur: granulares MoE mit Vision-Encoder
Mistral Large 4 ist nach den Dokumentationsseiten ein nativ multimodales Modell mit granularer Mixture-of-Experts-Architektur: 1,05 Billionen Parameter insgesamt, 52 Milliarden aktive Parameter und ein Vision-Encoder mit 1,6 Milliarden Parametern [2]. Die Hugging-Face-Seite präzisiert die Aktivparameter: 49 Milliarden pro Token, 52 Milliarden nur, wenn man Einbettungs- und Ausgabeschichten mitzählt [3]. Das Kontextfenster liegt laut Dokumentation bei einer Million Token [2].
„Granular“ bedeutet bei Mixture of Experts, dass die Experten kleiner und zahlreicher sind als in groben MoE-Designs; pro Token wird nur ein Bruchteil des Netzes aktiviert. Genau dieser Aufbau macht ein Billionen-Parameter-Modell überhaupt betreibbar: Der Speicher muss alle Gewichte vorhalten, die Rechenarbeit pro Token richtet sich aber nach den 49 bis 52 Milliarden aktiven Parametern. Zum Vergleich: Mistrals bisheriges Spitzenmodell Large 3 kommt auf 675 Milliarden Parameter insgesamt (Herstellerangabe, siehe Modell-Atlas).
Trainiert wurde ML4 nach Unternehmensangaben von Grund auf auf 3.800 NVIDIA-Grace-Blackwell-Beschleunigern in Mistrals eigenen Rechenzentren in Europa; die Vorschau werde auf derselben Infrastruktur ausgeliefert [1]. Ein nennenswerter Teil der Trainingsdaten sei mehrsprachig und umfasse mehr als 160 Sprachen, darunter alle Amtssprachen der Europäischen Union [1]. Training, Anpassung und RL-Umgebung entsprächen dem, was Mistral Kunden über Mistral Forge anbietet [1] - Unternehmen könnten also mit denselben Werkzeugen am selben Basismodell weiterarbeiten.
Preise und Verfügbarkeit
In der öffentlichen Vorschau kostet Mistral Large 4 laut Dokumentation 1,36 US-Dollar pro Million Eingabe-Token, 0,14 US-Dollar bei Cache-Treffern und 4,18 US-Dollar pro Million Ausgabe-Token [2]. Unterstützt werden unter anderem strukturierte Ausgaben, Function Calling, Dokumentenfragen, Batch-Verarbeitung und die Agents-API [2]. Die Gewichte sollen wie angekündigt bis Monatsende folgen [1][3]; bis dahin lässt sich das Modell nur über Mistrals API nutzen.
- Eingabe
- Ausgabe
Daten als Tabelle
| Eingabe | Ausgabe | |
|---|---|---|
| Mistral Large 3 | 0,5 | 1,5 |
| Mistral Large 4 | 1,36 | 4,18 |
| DeepSeek V4-Pro | 1,32 | 3,96 |
| Claude Sonnet 5 | 2 | 10 |
| Claude Opus 5 | 5 | 25 |
| GPT-6 Astra | 10 | 50 |
Hersteller-Listenpreise im Standardtarif, keine Angebote des KI Fachblatts. Werte für die Vergleichsmodelle aus dem KIFB-Modell-Atlas (Stand 20. Oktober 2026), ML4-Werte aus der Mistral-Dokumentation [2].
Damit liegt ML4 preislich über Mistrals Large 3 (0,50/1,50 US-Dollar) und fast exakt auf dem Niveau von DeepSeek V4-Pro (1,32/3,96), aber weit unter den geschlossenen Frontier-Modellen: Claude Opus 5 kostet im Standardtarif 5/25, GPT-6 Astra 10/50 US-Dollar pro Million Token (Listenpreise der Anbieter, Stand 22. Oktober 2026, siehe Modell-Atlas). Wer heute eine Million Eingabe- und eine Million Ausgabe-Token verarbeitet, zahlt bei ML4 rechnerisch 5,54 US-Dollar, bei GPT-6 Astra 60 US-Dollar (eigene Rechnung aus Listenpreisen, ohne Rabatte und Sonderkonditionen).
Was Mistral an Leistungsdaten meldet
Alle bislang verfügbaren Leistungswerte stammen von Mistral selbst oder von von Mistral beauftragten Dritten - eine unabhängige Replikation gibt es noch nicht. Wir berichten sie deshalb durchgängig als Herstellerangaben; zur grundsätzlichen Problematik solcher Zahlen siehe unsere Analyse zur Vergleichbarkeit von Hersteller-Benchmarks.
- Agentisches Programmieren: 61,7 Prozent auf DeepSWE v1.1, 59,4 Prozent auf SWE-Atlas-QnA und 28,3 Prozent auf Terminal-Bench 4.0; der kombinierte „Coding Agent Index“ von 49,8 Prozent liege laut Mistral vor DeepSeek V4 Pro 0813 und Qwen3.8 Max [1].
- Agenten-Workflows: 59,9 Prozent auf AutomationBench (657 Geschäftsprozesse in Apps wie Gmail, Google Sheets, Slack und Salesforce), vor Kimi K3, MiMo-V2.6-Pro und DeepSeek V4 Pro; auf AA-Briefcase, einer Bewertung langfristiger Wissensarbeit, erreicht ML4 nach Herstellerangabe 1.393 Elo, ebenfalls vor DeepSeek V4 Pro [1].
- Multimodal: Beim visuellen Grounding auf Dense 200 meldet Mistral 42 Prozent - knapp vor GPT-6-Astra mit 41 Prozent [1].
- Wissensarbeit: Von Mistral beauftragte Drittbewertungen (vals.ai) zu juristischen und finanzbezogenen Aufgaben sehen ML4 jeweils vor GPT-6-Astra; auf HarveyAIs Legal-Agent-Benchmark übertreffe das Modell alle quelloffenen Modelle [1].
- Menschliche Blindbewertung: In einer von Mistral bei Surge AI beauftragten Blindstudie bewerteten Annotierende die Programmierqualität auf einer Skala von 1 bis 5. ML4 Preview landete mit 3,74 auf Platz zwei von fünf - hinter Claude Opus 5 (4,22), vor Kimi K3 (3,59), GLM-5.3 (3,60) und GLM-5.2 (3,40) [1].
- Wissenschaft: Auf SciCode-Verified sei ML4 laut Mistral das beste quelloffene Modell; in einer internen Bewertung gegen GLM-5.3 wurde ML4 in CAD- und MINT-Aufgaben bevorzugt, bei Finanzen und Programmieren lag es gleichauf oder knapp zurück [1].
Cybersecurity als zentrales Verkaufsargument
Am ausführlichsten begründet Mistral die Cybersecurity-Fähigkeiten. Auf CyberGym-E2E, einem Test, bei dem ein Modell eine echte Schwachstelle in quelloffener Software reproduzieren und patchen soll, erreicht ML4 nach Herstellerangabe 82 Prozent - der höchste Wert aller Modelle. Zugleich betont Mistral, dass führende geschlossene Modelle wie Claude Opus 5.5 und GPT-6 Astra auf demselben Test nahe null lägen, weil sie die Aufgabe verweigerten [1]. Auf Cybench, 40 Aufgaben aus Sicherheitswettbewerben, löse ML4 93 Prozent [1].
Dahinter steht ein souveränitätsbezogenes Argument: Wer Sicherheitsarbeit mit fremder Infrastruktur betreibt, könne durch Refusals des Anbieters blockiert werden oder mitten in einem Vorfall den Zugang verlieren; offene Gewichte und Selbsthosting gäben Organisationen die Kontrolle zurück [1]. Bis zur Gewichtsveröffentlichung lässt Mistral das Modell nach eigenen Angaben von Cybersicherheitsunternehmen, geprüften Partnern und staatlichen Stellen mit reduzierter Moderation und erweiterten Cyber-Fähigkeiten testen [1].
Gleichzeitig weist Mistral eigene Sicherheitsmessungen aus: Auf Lakeras öffentlichem B3-Benchmark widerstehe ML4 93,3 Prozent der Angriffe; auf dem KORA-Benchmark erreiche es 1,691 von 2 möglichen Punkten; und die Verweigerungsrate bei schädlichen Cyber-Anfragen aus JailbreakBench, StrongREJECT und AgentHarm liege höher als bei allen anderen untersuchten offenen Modellen [1]. Beides kann stimmen: Ein Modell kann defensive Aufgaben gut lösen und offensive Anfragen trotzdem ablehnen. Beobachter werden prüfen, wie sich das nach der Gewichtsveröffentlichung verhält, wenn die Moderation entfällt.
Post-Training: RL mit austauschbaren Umgebungen
Zum Vortraining anschließenden Post-Training beschreibt Mistral eine eigene Reinforcement-Learning-Bibliothek, in der sich neue Trainingsumgebungen leicht ergänzen und skalieren lassen: Eine gemeinsame, kombinierbare Schnittstelle erlaube es, in einem einzigen Trainingslauf Aufgaben von einfachen Chat-Antworten über wissenschaftliche Probleme bis zu Sicherheitsausrichtung, Faktentreue und langfristigem Werkzeuggebrauch zu mischen. Diese Umgebungen teilten sich Gerüste und Ressourcen wie Code-Sandboxes, Websuche und externe APIs; zur Bewertung kämen Belohnungsmodelle, Unit-Tests, LLM-Juroren und statische Prüfungen zum Einsatz [1]. Mistral begründet den RL-Ansatz damit, dass ein auf das Vorgängermodell abgestimmtes Rezept an einem stärkeren Basismodell Fähigkeiten liegen lasse - das Training auf den eigenen Versuchen des Modells könne mit dessen Niveau mitwachsen [1].
Einordnung: Was das für Nutzer bedeutet
Drei Punkte sind heute belastbar. Erstens ist Mistral Large 4 das erste europäische Modell, das parameter- und kontextseitig in der Frontier-Klasse mitspielt - mit einer Infrastruktur, die Mistral nach eigenen Angaben vollständig in Europa betreibt, einschließlich eines europäischen Deployments unter europäischem Recht [1]. Zweitens liegt der Listenpreis im Segment der chinesischen Frontier-Modelle und weit unter dem der amerikanischen. Drittens ist das Wichtigste noch nicht passiert: Erst mit den Gewichten - erwartet am 31. Oktober - lassen sich die Herstellerangaben unabhängig prüfen, und erst dann wird klar, ob die angekündigte Selbsthosting-Option für Sicherheits- und Behördenumgebungen trägt [3].
| Merkmal | Angabe | Stand |
|---|---|---|
| Gesamtparameter | 1,05 Billionen (granulares MoE) | Hersteller [2] |
| Aktive Parameter pro Token | 49 Mrd. (52 Mrd. inkl. Einbettungs-/Ausgabeschichten) | Hersteller [3] |
| Vision-Encoder | 1,6 Mrd. Parameter, nativ multimodal | Hersteller [2] |
| Kontextfenster | 1 Mio. Token | Hersteller [2] |
| Preis (Ein-/Ausgabe pro Mio. Token) | 1,36 $ / 4,18 $ (Cache-Treffer 0,14 $) | Hersteller [2] |
| Verfügbarkeit | Öffentliche API-Vorschau seit 6. Oktober 2026 | Hersteller [1] |
| Offene Gewichte | Erwartet am 31. Oktober 2026 | Hersteller [3] |
| Training | 3.800 NVIDIA Grace Blackwell, eigene Rechenzentren in Europa | Hersteller [1] |
Methode
Grundlage sind Mistrals Ankündigung vom 6. Oktober 2026, die Modell-Dokumentation von Mistral (Preise, Kontext, API-Merkmale) und die Hugging-Face-Seite des Modells (Release-Status, Aktivparameter), alle am 23. Oktober 2026 abgerufen. Preisvergleiche nutzen die Hersteller-Listenpreise aus dem KIFB-Modell-Atlas (Quellenstand 22. Oktober 2026). Als eigene Rechnungen gekennzeichnet: der Kostenvergleich pro Million Token sowie die grobe Speicherabschätzung für den Selbstbetrieb.
Grenzen
Alle Leistungs- und Benchmark-Angaben sind Herstellerangaben oder stammen von von Mistral beauftragten Dritten; sie sind nicht unabhängig repliziert. Der erwartete Gewichts-Termin (31. Oktober 2026) ist ein Hersteller-Ziel, keine Zusage. Preise können sich ändern; Rabatte, regionale Tarife und Sonderkonditionen sind nicht berücksichtigt. Keine Rechts- oder Anlageberatung.