 KI
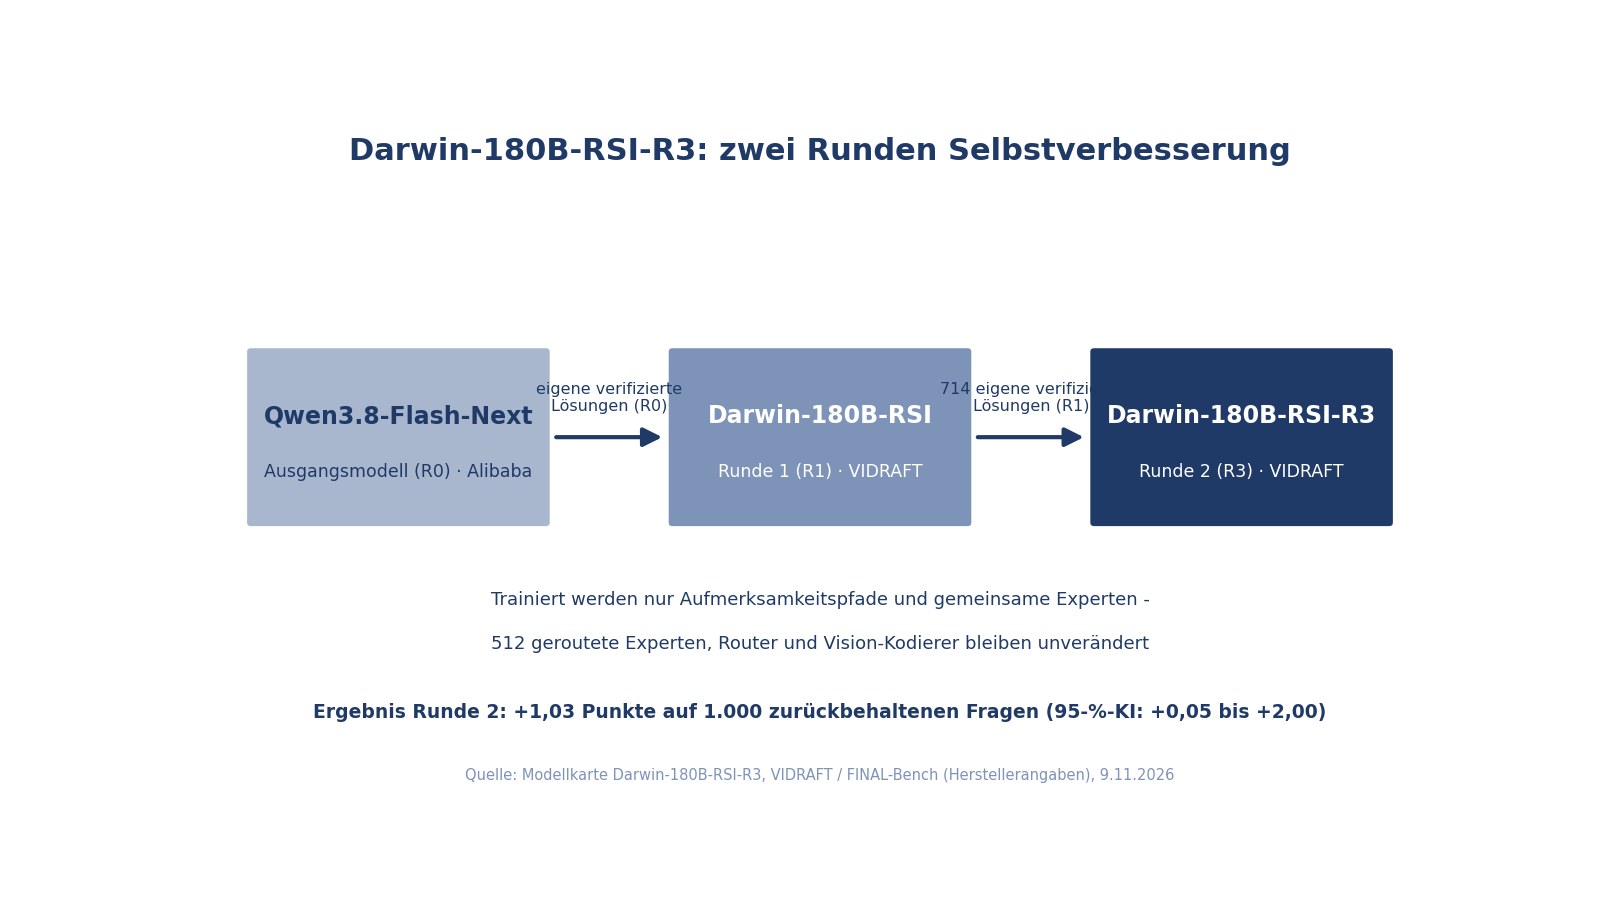
Das koreanische Team von VIDRAFT hat mit Darwin-180B-RSI-R3 die zweite Runde eines ungewöhnlichen Experiments veröffentlicht: Ein Sprachmodell, das nicht von menschlichen Musterlösungen oder einem größeren Lehrermodell lernt, sondern von seinen eigenen überprüften Antworten. Die Gewichte sind offen, das Auswertungsprotokoll liegt im Repositorium, und die Lizenz stammt vom Ausgangsmodell Qwen3.8-Flash-Next - mit zwei Bedingungen, die man kennen sollte [1][2]. Das Repositorium wurde am 1. Oktober 2026 angelegt und zuletzt am 7. November 2026 aktualisiert (Plattform-API) [4].
Eckdaten
Architektur und Kontext
Darwin-180B-RSI-R3 ist ein Mixture-of-Experts-Modell mit 180 Milliarden Parametern: 512 geroutete Experten, von denen pro Token zehn aktiv sind, dazu ein gemeinsamer Experte. Das Netz hat 48 Schichten bei einer versteckten Größe von 2.560 und nutzt hybride Aufmerksamkeit - 36 Linear-Attention- und 12 Full-Attention-Schichten. Der Kontext umfasst 262.144 Token, das Vokabular 248.320 Einträge [1].
Modalitäten und Sprachen
Das Modell verarbeitet Bilder und Text und gibt Text aus; ein eigener Vision-Kodierer ist Teil der Architektur. Die Modellkarte nennt als Schwerpunkt Koreanisch und Englisch, im Kopf der Karte sind außerdem Chinesisch, Japanisch und mehrsprachige Tags vermerkt. Es ist nach Angaben des Anbieters das einzige koreanische Modell im zitierten SuperCLUE-Ranking [1].
Gewichte, Betrieb und Verfügbarkeit
Die Gewichte liegen in bf16 vor (rund 336 GB) und sind nicht hinter einer Zugangssperre [4]. Der Anbieter betreibt das Modell mit vLLM auf acht B200-Beschleunigern oder vergleichbarer Hardware. Zusätzlich gibt es POCKET-Darwin-180B-GGUF, eine 4-Bit-Fassung von R3 mit 111 GB, die laut Anbieter auf einem Laptop mit 8 GB GPU und 32 GB RAM läuft - rein auf dem Prozessor mit 18 bis 21 Token pro Sekunde. Der MMLU-Pro-Wert dieser Fassung soll mit 87,65 Prozent identisch zur bf16-Version sein. Das sind Herstellerangaben; wir haben keine dieser Konfigurationen ausprobiert [1].
Wie die Selbstverbesserung funktioniert
VIDRAFT nennt das Verfahren rekursive Selbstverbesserung auf Modellebene: Das Modell löst prüfbare Übungsaufgaben, behält nur die Lösungen, die eine automatische Kontrolle als richtig bestätigt, und wird anschließend genau auf diesen eigenen Lösungen weitertrainiert. Menschliche Musterlösungen oder Denkschritte kommen nicht zum Einsatz. R1 war die erste Runde auf dem Ausgangsmodell Qwen3.8-Flash-Next, R3 setzt auf R1 auf - die Gewichte des Ausgangsmodells wurden für R3 nicht erneut verwendet [1].
Konkret für diese Runde: R1 bearbeitete 3.000 SuperGPQA-Übungsfragen mittleren und hohen Schwierigkeitsgrads, jede achtmal. Trainiert wurde nur auf den 462 Grenzfragen, bei denen R1 in zwei bis sechs von acht Versuchen richtig lag - Aufgaben, die das Modell also noch nicht sicher beherrschte, aber grundsätzlich lösen konnte. Daraus entstanden 714 eigene, vollständige und verifizierte Lösungen als Trainingsmaterial. Angepasst wurden wie in R1 nur die Aufmerksamkeitspfade und die gemeinsamen Experten (per LoRA, danach zusammengeführt); alle 512 gerouteten Experten, der Router und der Vision-Kodierer blieben unverändert. Die Übungsaufgaben wurden per 8-Gramm-Filter gegen alle ausgewiesenen Testmengen abgeglichen [1].
Zur Abgrenzung: Auf Modellebene verändern sich die Gewichte selbst. Verfahren auf Werkzeugebene verbessern dagegen Prompts, Werkzeuge und Abläufe um ein festes Modell herum. Beide Ansätze schließen sich nicht aus [1].
Messwerte und was sie aussagen
Die sauberste Zahl der Veröffentlichung betrifft 1.000 SuperGPQA-Fragen, die weder im Training noch in der Auswahl vorkamen: Vier Antworten pro Frage, 16.000 Token Denkbudget. R3 erreicht im Mittel 66,70 Punkte gegenüber 65,67 bei R1. Die gepaarte Differenz beträgt +1,03 Punkte mit einem 95-%-Konfidenzintervall von +0,05 bis +2,00 - ein kleiner, aber in dieser Konfiguration messbarer Zugewinn der zweiten Runde [1].
Auf GPQA Diamond (198 Fragen, acht Antworten pro Frage, 32.000 Token Denkbudget) liegt R3 bei einer Einzelantwort mit 85,86 knapp über R1 (84,85) und dem Ausgangsmodell (84,85); im Mittel der acht Antworten führt R3 mit 86,05. Im Mehrheitsverfahren liegt allerdings das Ausgangsmodell Qwen3.8-Flash-Next mit 90,91 vor R1 (89,90) und R3 (90,40) - der Zugewinn hängt also davon ab, wie man misst [1].
Zwei Bestenlisten-Einträge führt der Anbieter für R3 selbst: Auf ExtractBench (370 Dokumente) erreicht das Modell 90,29 Punkte und damit laut Anbieter Platz 1 - gemessen mit der offiziellen Auswertungsumgebung, Temperatur 0, abgeschaltetem Denkmodus und 32.768 Token Antwortlänge. Auf EvasionBench (16.726 Fragen) liegt R3 mit 77,83 auf Platz 3. Die vollständigen Einstellungen liegen im Repositorium unter .eval_results/ [1].
Hinzu kommt ein Fremdranking: Die Modellkarte zitiert SuperCLUE, ein chinesisches Benchmark-Projekt, mit 73,68 Punkten in mathematischem und naturwissenschaftlichem Reasoning für den November 2026 - laut Karte Platz 1 unter den Modellen mit offenen Gewichten und Platz 2 insgesamt hinter GPT-6.1-Sol (76,32). Die Karte verweist auf Screenshots vom 5. November 2026; die SuperCLUE-Webseite konnten wir nicht selbst abrufen, die Werte geben wir daher als Zitat der Modellkarte wieder [1].
| Test (eigene Metrik) | Gemeldeter Wert |
|---|---|
| ExtractBench (370 Dokumente) | 90,29 |
| GPQA Diamond (Mittel aus 8) | 86,05 |
| EvasionBench (16.726 Fragen) | 77,83 |
| SuperCLUE Mathe/Wissenschaft (Zitat) | 73,68 |
| SuperGPQA held-out (Mittel aus 4) | 66,7 |
Wichtig für die Einordnung: Mehrheitsentscheide und Mittelwerte aus mehreren Antworten sind Systemergebnisse, keine Einzelantworten. Der Anbieter kennzeichnet das ausdrücklich und nennt je Test die Stichprobenzahl - etwa 16 Antworten pro Frage bei den R1-Bestenlisten-Einträgen zu AIME 2026 (Mehrheit 100,0; Mittel 98,75) [1][3].
Lizenz: Qwen Community License 1.0 im Detail
Darwin-180B-RSI-R3 ist ein Abkömmling von Qwen3.8-Flash-Next und steht unter der Qwen Community License 1.0, deren vollständiger Text im Repositorium liegt. Wir haben ihn gelesen: Die Grundrechte sind weit gefasst - Nutzen, Kopieren, Ändern, Zusammenführen, Veröffentlichen, Vertreiben, Unterlizenzieren, Verkaufen, Bereitstellen, Hosten, Feintuning und abgeleitete Werke sind erlaubt [2].
Bedingung 1: Der Copyright-Vermerk und der Lizenztext müssen in allen Kopien enthalten sein. Zusätzlich gilt: Wird das Modell in einem kommerziellen Produkt oder Dienst mit mehr als 100 Millionen monatlich aktiven Nutzern oder mehr als 20 Millionen US-Dollar Monatsumsatz eingesetzt, muss der Modellname prominent auf der Benutzeroberfläche erscheinen [2].
Bedingung 2 betrifft das Geschäftsmodell: Wer selbst oder über verbundene Unternehmen ein Modell-as-a-Service- oder AI-Work-Assistant-Geschäft betreibt, benötigt für die kommerzielle Nutzung eine separate Lizenz von Qwen. Ausgenommen ist die interne Nutzung, solange Dritte keinen Zugriff auf das Modell, seine Ausgaben oder seine Fähigkeiten erhalten. Der Text definiert Modell-as-a-Service als den Fall, dass Dritte Inferenz oder Feintuning mit maßgeblicher Kontrolle über Eingaben, Parameter oder Trainingsdaten nutzen können - das bloße Weiterleiten von Anfragen an fremd gehostete Modelle zählt nicht dazu. Als AI Work Assistant gilt ein eigenständiges Produkt, das primär auf KI-gestütztes Programmieren oder Büroarbeit ausgelegt ist; Einzweckwerkzeuge, domänenspezifische Assistenten und bloße Produkt-Features sind ausgenommen [2].
Territoriale Ausschlüsse enthält der Lizenztext nicht. Die Gewährleistung ist ausgeschlossen, und die Nutzung muss geltendem Recht entsprechen. Für deutsche Anwender heißt das praktisch: Interne Nutzung und die meisten Produktintegrationen sind frei; wer dagegen Dritten kommerziell Modellzugriff mit eigener Kontrolle über Eingaben oder Training anbietet, braucht unabhängig vom Umsatz eine Vereinbarung mit Qwen. Das ersetzt keine Rechtsberatung [2].
Einordnung und Prüfgrenzen
Alle Werte sind Selbstmessungen des Anbieters mit offengelegten Einstellungen; die Rohdaten liegen im Repositorium. Eine unabhängige Nachmessung ist grundsätzlich möglich, weil die Gewichte offen sind - sie erfordert aber Server-Hardware: Rund 336 GB in bf16 laufen nicht auf Consumer-Geräten. Wir haben das Modell nicht ausgeführt. Ob es bereits Fremdmessungen gibt, können wir nicht ausschließen [1].
Zwei Details verdienen Aufmerksamkeit: Der mit R1 veröffentlichte ZTC-Sonden-Mechanismus, der vor der Antwort eine Konfidenzschätzung ausgibt, wurde auf den Zwischenzuständen von R1 kalibriert; eine auf R3 angepasste Sonde ist angekündigt, lag aber noch nicht im Repositorium. Und der Fortschritt der zweiten Runde ist klein: +1,03 Punkte auf der zurückbehaltenen Menge, während das Ausgangsmodell bei GPQA Diamond im Mehrheitsverfahren weiter vorn liegt. Wer das Modell einsetzt, sollte die eigenen Aufgaben selbst messen, statt Bestenlisten-Plätze zu übernehmen [1].
Methode
Analyse auf Basis der vollständig gelesenen Modellkarte von Darwin-180B-RSI-R3 (inklusive Trainingsrezept und Auswertungsprotokoll), des vollständig gelesenen Lizenztexts im Repositorium, der R1-Modellkarte sowie der Repositorium-Metadaten der Plattform-API (jeweils abgerufen am 9.11.2026). Sämtliche Messwerte sind Herstellerangaben mit den dort genannten Einstellungen. Keine eigenen Tests.
Grenzen
Keine eigenen Tests; wir haben das Modell nicht ausgeführt (rund 336 GB in bf16 erfordern Server-Hardware). Alle Benchmark-Werte stammen vom Anbieter; Mittelwerte und Mehrheitsentscheide aus mehreren Antworten sind Systemergebnisse. Die SuperCLUE-Werte zitiert die Modellkarte aus einem Fremdranking - die SuperCLUE-Webseite konnten wir nicht selbst abrufen. Ob es unabhängige Fremdmessungen gibt, können wir nicht ausschließen. Die Angaben zur Laptop-Fähigkeit der 4-Bit-Fassung sind ungeprüfte Herstellerangaben. Die Lizenzeinordnung ersetzt keine Rechtsberatung.
Quellen
- Darwin-180B-RSI-R3 - Modellkarte und Repositorium (inklusive Auswertungsprotokoll), VIDRAFT / FINAL-Bench (Hugging Face) (abgerufen 2026-11-09) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- LICENSE - Qwen Community License 1.0 (Volltext im Repositorium), Qwen, bereitgestellt im Repositorium von FINAL-Bench (Hugging Face) (abgerufen 2026-11-09) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Darwin-180B-RSI (R1) - Modellkarte, VIDRAFT / FINAL-Bench (Hugging Face) (abgerufen 2026-11-09) ↩
- Repositorium-Metadaten (Anlagedatum, letzte Aktualisierung, Downloads), Hugging-Face-API (abgerufen 2026-11-09) ↩1 ↩2