 KI
NVIDIA hat am 14. und 15. Oktober 2026 zwei offene Modelle veröffentlicht: Nemotron 3.5 Super (120 Milliarden Parameter, 12 Milliarden aktiv, Text, Bild und Video als Eingabe) und Nemotron 3.5 Lightning (30 Milliarden, 3 Milliarden aktiv, nur Text) [1][2]. Beide sind hybride Mixture-of-Experts-Modelle mit Mamba-2-Schichten, bis zu einer Million Token Kontext, mit eingebauten Mehr-Token-Vorhersageköpfen für spekulatives Dekodieren und mit Checkpoints in BF16 und NVFP4 [1]. Dieser Beitrag nimmt sich drei Aussagen vor, die NVIDIA hervorhebt: den Trainingsweg über Destillation, die Quantisierung („99,62 Prozent Genauigkeitserhalt“) und die Geschwindigkeit durch spekulatives Dekodieren. Wir haben den Technical Report selbst nicht gefunden; die Grundlage sind die Zusammenfassung von NVIDIA Research, die Modellkarten und ein Forumsthread. Wir haben kein Modell ausgeführt.
Das Ergebnis vorab: Die Quantisierung hält im Median, was sie verspricht. Hinter dem Median stehen aber einzelne Aufgaben, bei denen NVFP4 deutlich schlechter abschneidet als BF16, und mehrere davon sind agentische Aufgaben, für die das Modell beworben wird. Das ist ein Befund aus den Tabellen der Modellkarte, kein Beweis für ein Problem des Modells: Die Karte nennt weder Wiederholungszahlen noch Streuung.
Was veröffentlicht wurde
| Merkmal | Nemotron 3.5 Super VL | Nemotron 3.5 Lightning |
|---|---|---|
| Parameter gesamt / aktiv | 120 Mrd. / 12 Mrd. | 30 Mrd. / 3 Mrd. |
| Aktiver Anteil (eigene Rechnung) | 10 % | 10 % |
| Modalitäten | Text, Bild, Video rein; Text raus | Text |
| Architektur | Mamba-2, MoE (512 geroutete Experten) und Attention verschränkt; C-RADIO-Bildencoder | hybrides MoE aus Mamba und Transformer |
| Kontext | bis 1 Mio. Token | bis 1 Mio. Token |
| Formate | Base BF16, BF16, NVFP4, Entwurfsmodell LiLiCorr | Base BF16, BF16, NVFP4, Entwurfsmodelle DFlash und DSpark |
| Lizenz | OpenMDW-1.1 | laut Zusammenfassung offen; Lizenztext nicht geprüft |
NVIDIA veröffentlicht nach eigenen Angaben nicht nur Gewichte, sondern auch Datensätze, Rezepte zum Training und zur Auswertung und Kochbücher [1]. Das Angebot ist damit offener als eine reine Gewichtsfreigabe. Der Umfang der Datensätze ist in der Zusammenfassung teils beziffert: Das Indische Vortrainingsset umfasst etwa 2,83 Billionen synthetische Ausgabe-Token über 22 Sprachen [1].
Der Trainingsweg: Destillation vor allem
Beide Modelle durchlaufen zuerst eine Aufwärmphase für die Mehr-Token-Vorhersage mit 100 Milliarden Token und dann 1 Billion Token Destillation aus dem jeweils nächstgrößeren Nemotron-3-Modell: Super aus Nemotron 3 Ultra Base, Lightning aus Nemotron 3 Super Base [1]. Bei der Destillation lernt ein kleineres Modell, die Ausgaben eines größeren nachzuahmen [7]. Ob und wie viel Rohtext-Vortraining dem vorausging, steht in den gelesenen Quellen nicht; die Karte nennt als Ausgangspunkt, das Rückgrat sei von Nemotron 3 Super Base initialisiert [2].
Danach folgen für Super mehrere gezielte Stufen. Die Zahlen aus der Zusammenfassung [1] und der Modellkarte [2] stimmen nicht ganz überein:
| Stufe | Zusammenfassung [1] | Modellkarte [2] |
|---|---|---|
| Indisches Weitertraining | 100 Mrd. Token | 100 Mrd. Token |
| Kontextverlängerung auf 1 Mio. | 35 Mrd. Token | 35 Mrd. Token |
| Mid-Training Software-Engineering (256K Kontext) | 65,4 Mrd. Token | 67 Mrd. Token |
| Langkontext-Erholung (1 Mio.) | 9 Mrd. Token | 9 Mrd. Token |
| Summe (eigene Rechnung) | 209,4 Mrd. | 211 Mrd. |
Der Unterschied bei der Software-Engineering-Stufe (65,4 gegen 67 Milliarden) ist klein, aber er zeigt, dass beide Dokumente nicht aus derselben Tabelle gespeist sind. Wir verwenden in diesem Beitrag keine der beiden Zahlen als Grundlage einer Berechnung.
Wichtiger ist ein Detail der Langkontext-Stufen: Nach dem Mid-Training bei 256K Kontext fiel der RULER-1M-Wert von Super ab, und eine abschließende Erholungsstufe mit nur 9 Milliarden Token brachte ihn von 33,5 auf 81,0 zurück [1]. Das ist eine Steigerung um den Faktor 2,4 (eigene Rechnung) und zeigt, wie empfindlich Langkontext-Fähigkeit gegenüber späterem Spezialtraining sein kann. NVIDIA nennt das selbst als Grund für die Erholungsstufe. Wir können nicht beurteilen, ob 81,0 ein gutes Ergebnis ist, weil die Quellen keine Vergleichswerte für RULER-1M nennen.
Daten als Tabelle
| Zeitpunkt | RULER-1M |
|---|---|
| Nach 256K-Mid-Training | 33,5 |
| Nach Erholungsstufe | 81 |
Quelle: NVIDIA Research [1]
Angaben von NVIDIA [1]; Mid-Training bei 256K, Erholung mit 9 Mrd. Token bei 1 Mio. Kontext.
Aktive Parameter und Rechenaufwand
Mit 12 Milliarden aktiven von 120 Milliarden Parametern rechnet Super pro Token mit 10 Prozent seiner Gewichte (eigene Rechnung). NVIDIA hebt hervor, Super erreiche 51,78 Prozent auf SWE-bench Pro und übertreffe damit Nemotron 3 Ultra bei „etwa 4,6-mal weniger aktiven Parametern“ [1]. Daraus folgt umgekehrt, dass Ultra etwa 55 Milliarden aktive Parameter haben müsste (12 × 4,6 = 55,2; eigene Rückrechnung, Ultras Größe haben wir nicht aus einer Primärquelle). Die Karte nennt für Super 51,78 Prozent auf SWE-bench Pro in BF16 und 51,30 in NVFP4 [2]; das gelesene Material enthält keinen Wert für Ultra auf derselben Zeile, den wir nachrechnen könnten.
Die Quantisierung: 99,62 Prozent im Median
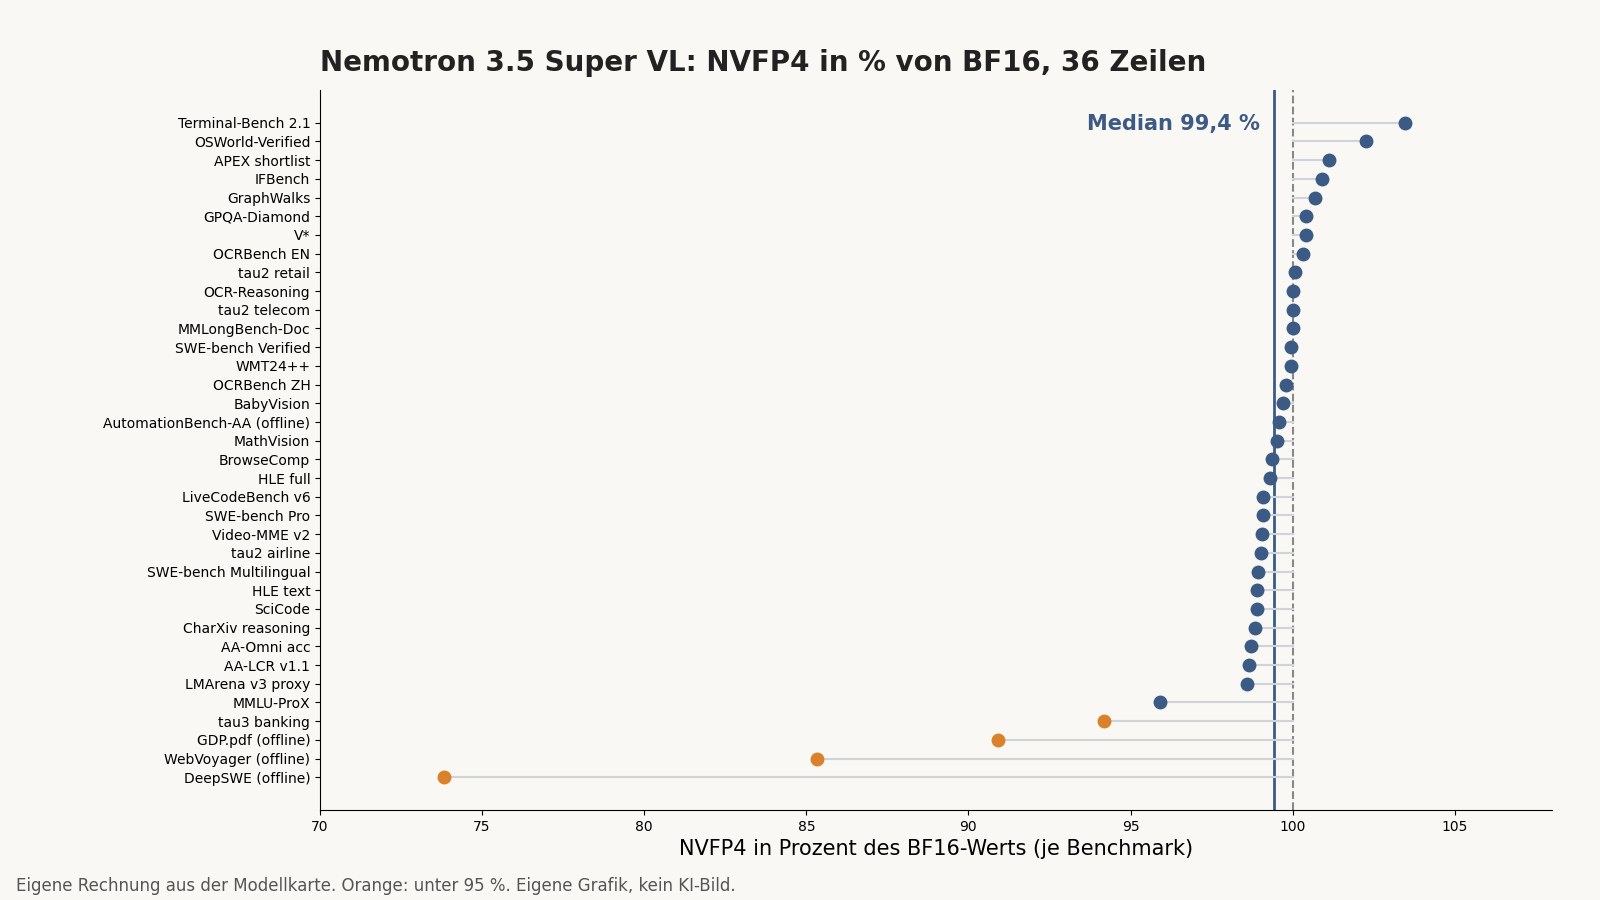
NVIDIA schreibt, der NVFP4-Checkpoint erreiche einen „median accuracy recovery“ von 99,62 Prozent gegenüber BF16 über 36 Benchmarks [1]. Die Modellkarte gibt für beide Formate die Rohwerte aus [2]; die Karte versichert ausdrücklich, dass beide mit identischen Konfigurationen und Harnesses ausgewertet wurden, um die Wirkung des Checkpoints zu isolieren [2]. Wir haben 36 Zeilen der Tabelle ausgewählt, deren Werte als einfache Punktzahl vergleichbar sind, und den NVFP4-Wert durch den BF16-Wert geteilt (eigene Rechnung). Nicht aufgenommen haben wir Zeilen mit Elo-Werten (GDPval-AA, AA-Briefcase-Lite), eine unleserlich formatierte Zeile, die Halluzinationsrate und den Omniscience-Index sowie Doppelungen.
- Median des Verhältnisses: 99,44 Prozent (NVIDIA: 99,62 Prozent über 36 Benchmarks). Die Auswahl der Zeilen ist verschieden, die Größenordnung stimmt überein.
- Mittelwert: 98,19 Prozent; der Mittelwert liegt unter dem Median, weil einzelne Zeilen weit unten liegen.
- In 30 von 36 Zeilen weicht NVFP4 um höchstens einen Punkt von BF16 ab; 10 Zeilen liegen höher, 24 niedriger.
- Vier Zeilen liegen unter 95 Prozent: DeepSWE (offline) bei 73,8 Prozent (24,65 → 18,2), WebVoyager (offline) bei 85,3 Prozent (77,72 → 66,31), GDP.pdf (offline) bei 90,9 Prozent (6,6 → 6,0) und tau3-bench banking bei 94,2 Prozent (18,88 → 17,78). MMLU-ProX folgt bei 95,9 Prozent (76,91 → 73,76).
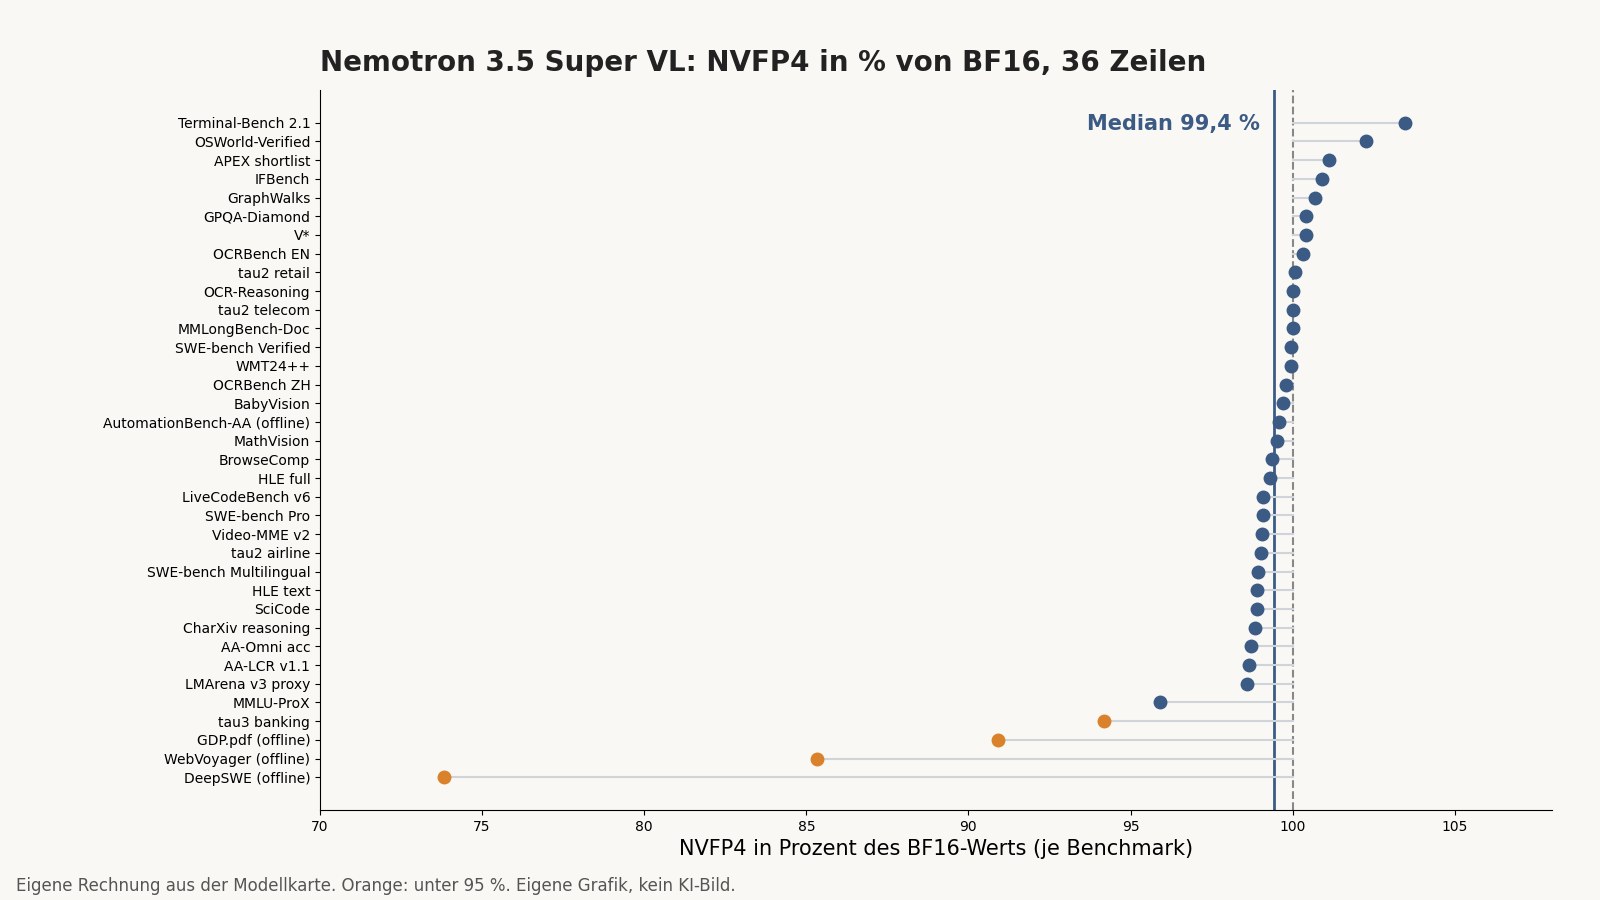
Wichtig für die Einordnung: Drei der vier schwächsten Zeilen tragen das Etikett „offline“, und DeepSWE, WebVoyager und tau3 banking sind agentische Aufgaben. Die Karte gibt weder die Zahl der Aufgaben noch die Zahl der Läufe pro Aufgabe an. Ein Rückgang von 24,65 auf 18,2 bei DeepSWE könnte bei wenigen Dutzend Aufgaben mit einzelnen Läufen im Rauschen liegen. Es kann ebenso sein, dass Quantisierung bei langen, mehrstufigen Aufgaben Fehler summiert. Aus den Daten lässt sich das nicht entscheiden. Die gleiche Tabelle zeigt aber auch das Gegenteil: Terminal-Bench 2.1 steigt von 60,67 auf 62,78 Prozent, OSWorld-Verified von 51,14 auf 52,3 [2].
Daten als Tabelle
| Benchmark | Differenz |
|---|---|
| WebVoyager (offline) | -11,41 Pkt. |
| DeepSWE (offline) | -6,45 Pkt. |
| MMLU-ProX | -3,15 Pkt. |
| SWE-bench Multilingual | -0,72 Pkt. |
| tau2 airline | -0,75 Pkt. |
| SWE-bench Pro | -0,48 Pkt. |
| LiveCodeBench v6 | -0,81 Pkt. |
| AA-LCR v1.1 | -0,93 Pkt. |
| SWE-bench Verified | -0,03 Pkt. |
| tau2 retail | 0,06 Pkt. |
| BrowseComp | -0,5 Pkt. |
| OSWorld-Verified | 1,16 Pkt. |
| Terminal-Bench 2.1 | 2,11 Pkt. |
Quelle: Eigene Rechnung nach [2]
Eigene Rechnung aus der Modellkarte [2]; Differenz in Prozentpunkten (NVFP4 minus BF16).
Eine Ergänzung aus der Tabelle: Die Halluzinationsrate in AA-Omniscience sinkt in NVFP4 von 30,0 auf 27,7 Prozent, der Index steigt von 4,03 auf 5,3 [2]. Eine Quantisierung, die das Fehlverhalten verbessert, ist ein Hinweis darauf, dass kleine Unterschiede in einzelnen Zeilen eher Streuung sind als Systematik. Es ist kein Beleg dafür.
Speicherbedarf
120 Milliarden Parameter in BF16 benötigen 240 GB (2 Byte pro Parameter, eigene Rechnung). Ein Forumsnutzer nennt für den BF16-Checkpoint 249 GB und für NVFP4 75,1 GB [4]; das sind Nutzerangaben in einem Forum, keine Herstellerangabe, aber sie passen zur Rechnung: 4-Bit-Gewichte mit blockweiser Skalierung kommen auf etwa 0,5625 Byte pro Parameter, das wären 67,5 GB. Die Differenz zu 75,1 GB erklären die Teile, die laut Karte in BF16 beziehungsweise FP32 bleiben: Bildencoder, Verbinder, Mamba-Faltungen, Einbettungen und der MoE-Router [2]. Die Karte nennt als Einsatzumgebung einen einzelnen DGX Spark, eine H200, zwei H100 oder eine GB200 [2].
Spekulatives Dekodieren: Mehr-Token-Vorhersage und Entwurfsmodelle
Beim spekulativen Dekodieren schlägt ein schnelles Entwurfsmodell mehrere Token vor, die das große Modell in einem Schritt prüft; akzeptierte Token sparen Schritte, und die Verteilung der Ausgabe soll sich laut den Autoren des Verfahrens nicht ändern [5]. Nemotron nutzt eigene MTP-Köpfe (Mehr-Token-Vorhersage) im Modell selbst, ein Ansatz, den die Forschung als Hilfsziel im Training beschrieben hat [6], und dazu für Spezialfälle getrennte Entwurfsmodelle: LiLiCorr für Super, DFlash und DSpark für Lightning [1][3].
| Dekodierung | Vor MTP-Boosting | Nach MTP-Boosting | Änderung (eigene Rechnung) |
|---|---|---|---|
| Greedy | 4,287 | 4,718 | +10,1 % |
| Probabilistisches Sampling | 3,787 | 4,612 | +21,8 % |
- Vor Boosting
- Nach Boosting
Daten als Tabelle
| Dekodierung | Vor Boosting | Nach Boosting |
|---|---|---|
| Greedy | 4,29 | 4,72 |
| Sampling | 3,79 | 4,61 |
Quelle: NVIDIA Research [1]
Angaben von NVIDIA [1]; mittlere Zahl akzeptierter Token pro Schritt.
Die Akzeptanzlänge ist nicht die Beschleunigung. Sie gibt an, wie viele Token ein Schritt im Mittel liefert. Die reale Beschleunigung hängt davon ab, wie teuer der Entwurf und die Prüfung sind und wie gut die Hardware ausgelastet ist. Entsprechend betont NVIDIA, dass die separaten Entwurfsmodelle für „niedrige Parallelität, speicherbegrenzte Einsätze“ gedacht sind [1]. Bei vielen gleichzeitigen Nutzern ist die GPU ohnehin rechenbegrenzt, und der Gewinn durch Entwürfe schrumpft. Die Karte des LiLiCorr-Modells nennt als Ziel DGX Spark und Rechenzentrums-GPUs und beschreibt den Entwurf als dichtes Netz mit Gruppen-Query-Attention (32 Query-, 8 Key/Value-Köpfe) und Gleitfenster-Attention über 8.192 Positionen [3].
Der Durchsatz
NVIDIA nennt für eine einzelne GB200 bis zu 4.856 Ausgabe-Token pro Sekunde und GPU bei mindestens 50 Token pro Sekunde und Nutzer in einem agentischen 20-Runden-Szenario [1]. Teilt man, ergeben sich rechnerisch etwa 97 gleichzeitige Nutzer (4.856 / 50; eigene Rechnung, Obergrenze, weil „mindestens“ 50 gilt). Im Vergleich: NVFP4 liefert 2,43-mal den Durchsatz von BF16, Super 2,34-mal den von Qwen3.5 122B-A10B und 1,90-mal den von Qwen3.8 Flash-Next [1]. Aus 2,43 und 4.856 folgt für BF16 ein Wert von etwa 2.000 Token pro Sekunde (eigene Rückrechnung, nur sinnvoll, wenn dieselbe Konfiguration gemeint ist). Welche Eingabelängen, welche Batchgrößen und welche Konfigurationen der Vergleichsmodelle verwendet wurden, nennt die Zusammenfassung nicht; wir lesen die Zahlen deshalb als Herstellermessung unter einer bestimmten Last, nicht als allgemeine Eigenschaft.
Agenten: Selbstverifikation und Mid-Training
Zwei Befunde zu Agentenaufgaben nennt NVIDIA [1]. Erstens verbessert das Mid-Training auf Repositories, Issue-Pull-Request-Paaren, Commit-Historien, Build- und CI-Logs und Agenten-Trajektorien DeepSWE pass@1 von 6,4 auf 10,4 Prozent. Zweitens steigern parallele Agentenläufe mit anschließender Selbstverifikation die Ergebnisse deutlich:
| Benchmark | Vorher | Nachher | Absolut (eigene Rechnung) | Relativ |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 62,7 % | 71,9 % | +9,2 Pkt. | +14,7 % |
| DeepSWE | 24,6 % | 34,5 % | +9,9 Pkt. | +40,2 % |
| BrowseComp | 71,5 % | 79,8 % | +8,3 Pkt. | +11,6 % |
- Einzelner Lauf
- Parallel + Selbstverifikation
Daten als Tabelle
| Benchmark | Einzelner Lauf | Parallel + Selbstverifikation |
|---|---|---|
| Terminal-Bench 2.1 | 62,7 % | 71,9 % |
| DeepSWE | 24,6 % | 34,5 % |
| BrowseComp | 71,5 % | 79,8 % |
Quelle: NVIDIA Research [1]
Angaben von NVIDIA [1] für „die ausgewerteten Setups“.
Zwei Einschränkungen: Parallele Läufe kosten ein Vielfaches an Rechenzeit und Token, die Zusammenfassung nennt aber weder die Zahl der Läufe noch die Kosten. Zweitens bedeuten „die ausgewerteten Setups“, dass die Werte nicht mit denen der Modellkarte vergleichbar sind: Dort steht Terminal-Bench 2.1 bei 60,67 Prozent (BF16), im Setup der Selbstverifikation bei 62,7 Prozent als Ausgangswert [1][2]. Der Zuwachs von 9,2 Punkten ist deshalb ein Befund für diese Konfiguration.
Was belegt ist, was offen bleibt
Belegt (aus den Herstellerdokumenten, nachgerechnet)
- Aktiver Anteil 10 Prozent bei Super (12/120) und Lightning (3/30).
- Median NVFP4 gegen BF16: 99,44 Prozent in 36 ausgewählten Zeilen der Karte; in 30 von 36 Zeilen innerhalb von einem Punkt.
- Akzeptanzlängen und deren relative Änderung (+10,1 und +21,8 Prozent).
- Zwei Trainingsdokumente weichen bei der Zahl der Token der Software-Engineering-Stufe voneinander ab (65,4 und 67 Mrd.).
Herstellerangabe, nicht unabhängig geprüft
- 99,62 Prozent Median-Erhalt über 36 Benchmarks; wir haben die Auswahl nicht reproduziert.
- Durchsatz: 4.856 Token pro Sekunde und GPU, 2,43-, 2,34- und 1,90-fach.
- Ergebnisse zu Selbstverifikation und Mid-Training.
- Alle Benchmark-Werte der Modellkarte.
Offen
- Ob die großen NVFP4-Abfälle bei DeepSWE (offline) und WebVoyager (offline) echt sind oder Rauschen.
- Der Inhalt des Technical Reports; wir konnten ihn nicht finden.
- Lizenzumfang von OpenMDW-1.1 im Wortlaut.
- Das Verhalten bei einer Million Token außer RULER-1M.
Selbst prüfen: ein Testplan
- Streuung messen: DeepSWE und WebVoyager mit BF16 und NVFP4 jeweils mindestens fünfmal laufen lassen und Mittelwert und Spannweite nennen.
- Gleiche Last: Durchsatz bei 1, 8, 32 und 96 gleichzeitigen Nutzern messen, mit und ohne Entwurfsmodell.
- Kosten: Pro gelöster Aufgabe die erzeugten Token und GPU-Sekunden erfassen; bei Selbstverifikation die Zahl der parallelen Läufe mitführen.
- Langkontext: Fundstellenaufgaben bei 128K, 512K und 1 Mio. Token mit Fundstelle am Anfang, in der Mitte, am Ende.
- Speicher: Tatsächlichen GPU-Speicher für NVFP4 mit und ohne Bild-Encoder und Entwurf messen.
Glossar
- Hybrides Modell: Netz, das verschiedene Schichttypen mischt, hier Mamba-2 (Zustandsraum-Modell mit linearem Aufwand in der Sequenzlänge [8]), Attention und MoE.
- MTP (Multi-Token Prediction): Zusatzköpfe, die mehrere künftige Token auf einmal vorhersagen [6].
- Akzeptanzlänge: Mittlere Zahl der pro Schritt akzeptierten Entwurfs-Token.
- NVFP4: 4-Bit-Gleitkommaformat von NVIDIA mit blockweiser Skalierung.
- Quantization-Aware Distillation: Nachtraining eines quantisierten Modells gegen das ursprüngliche als Lehrer [2][7].
- MOPD: Multi-Teacher On-Policy Distillation, Zusammenführung mehrerer Fachlehrer in ein Modell [1].
Methode und Grenzen dieser Analyse
Gelesen und am 19. Oktober 2026 abgerufen wurden die Zusammenfassung von NVIDIA Research, die Modellkarten für NVFP4 und LiLiCorr und ein Forumsthread [1][2][3][4]. Die arXiv-Verweise [5][6][7][8] haben wir nur als Titelseiten geöffnet; sie dienen als Definition der Begriffe, nicht als Beleg für Nemotron-Aussagen. Der Technical Report selbst war nicht erreichbar. Eigene Rechnungen: aktiver Anteil = aktiv/gesamt; Erhalt je Benchmark = NVFP4-Wert / BF16-Wert; Median und Mittelwert über 36 ausgewählte Zeilen; relative Änderungen = Nachher/Vorher − 1; Speicher = Parameter × Bytes pro Parameter. Die Auswahl der 36 Zeilen ist unsere und entspricht nicht notwendig der von NVIDIA.
Methode
Grundlage sind die Herstellerseiten, zwei Modellkarten und ein Forumsthread, die wir am 19. Oktober 2026 abgerufen haben, sowie vier arXiv-Titelseiten für Begriffe. Alle Rechenschritte sind eigene Überschlagsrechnungen und im Text gekennzeichnet. Wir haben kein Modell ausgeführt. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Technical Report nicht gelesen. Alle Benchmark-, Durchsatz- und Trainingsangaben sind Herstellerangaben. Die Auswahl der 36 Zeilen ist unsere. Die Karte nennt weder Aufgabenzahl noch Wiederholungen. Forumsangaben zum Speicher sind Nutzerangaben. Lizenz nicht im Wortlaut gelesen. Keine eigenen Tests.
Quellen
- NVIDIA Nemotron 3.5 Super and Lightning (Zusammenfassung des Technical Reports), NVIDIA Research (abgerufen 2026-10-19)
- NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 (Modellkarte), Hugging Face / NVIDIA (abgerufen 2026-10-19)
- NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4-LiLiCorr (Modellkarte), Hugging Face / NVIDIA (abgerufen 2026-10-19)
- NVIDIA-Nemotron-3.5-Super-VL-120B-A12B released, with Spark-dedicated vLLM config + LiLiCorr speculative decoding model (Forumsthread, Nutzerbeiträge), NVIDIA Developer Forums (abgerufen 2026-10-19)
- Fast Inference from Transformers via Speculative Decoding, arXiv 2211.17192 (abgerufen 2026-10-19)
- Better & Faster Large Language Models via Multi-token Prediction, arXiv 2404.19737 (abgerufen 2026-10-19)
- Distilling the Knowledge in a Neural Network, arXiv 1503.02531 (abgerufen 2026-10-19)
- Mamba: Linear-Time Sequence Modeling with Selective State Spaces, arXiv 2312.00752 (abgerufen 2026-10-19)