 KI
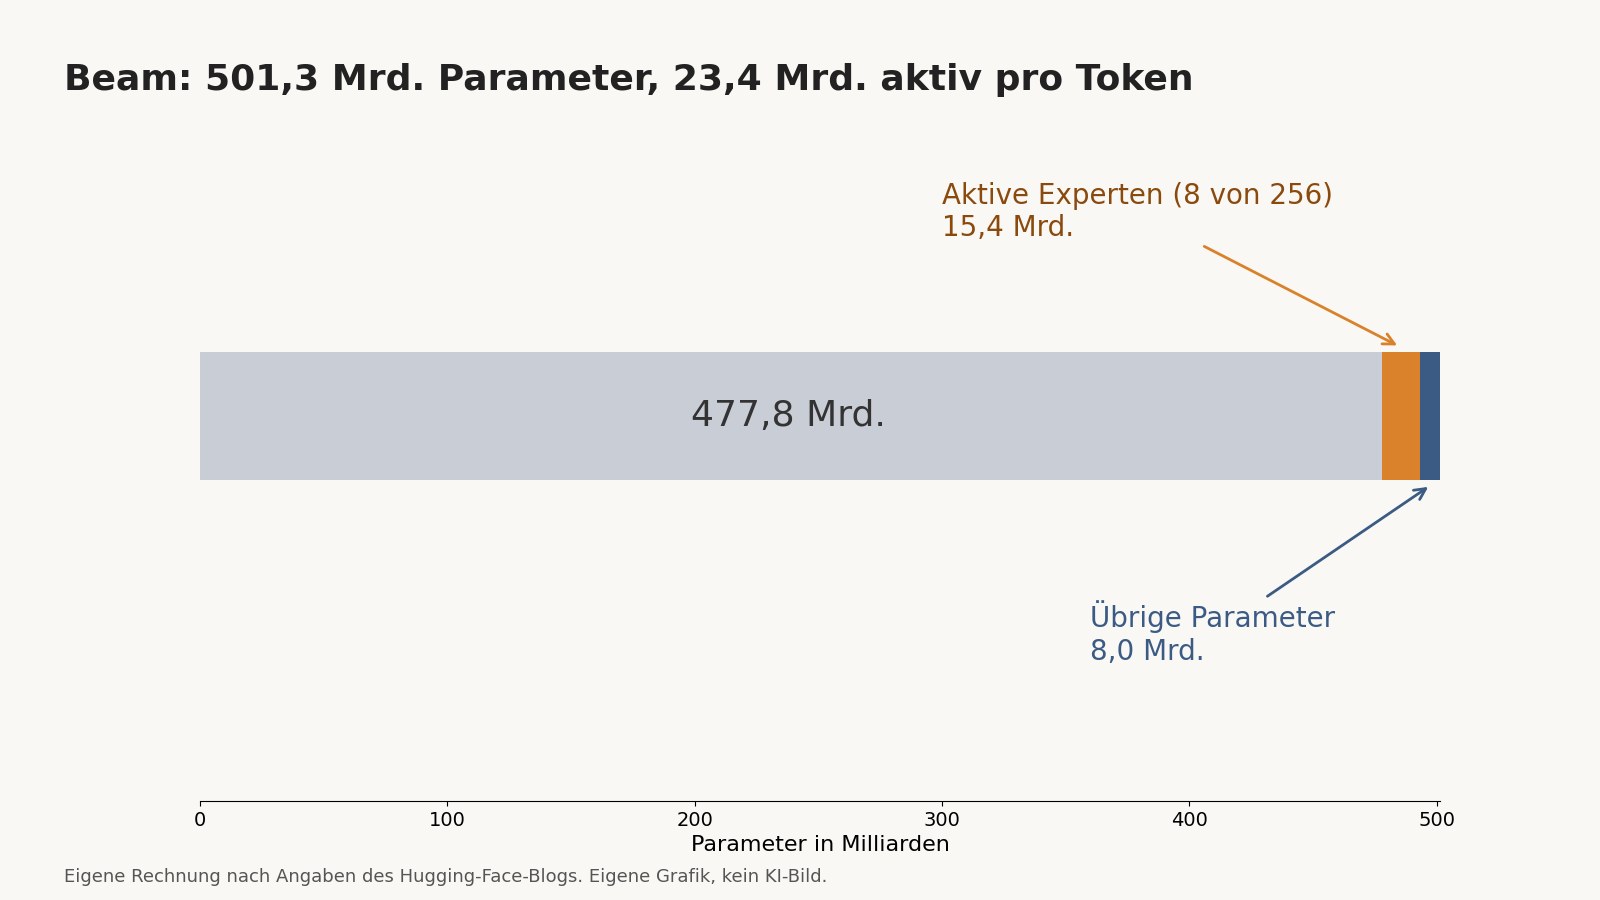
Reflection hat am 16. Oktober 2026 die Gewichte von Beam veröffentlicht: ein Mixture-of-Experts-Modell mit 501 Milliarden Parametern, 23 Milliarden aktiv pro Token, einer Million Token Kontext und Apache-2.0-Lizenz [2][3][4]. Es ist das erste Modell des US-Labors Reflection und nur für Text ausgelegt. Dieser Beitrag liest die vier Primärdokumente des Herstellers gegeneinander (zwei Blogbeiträge, die Modellkarte, den Safety-Bericht), rechnet die Architekturangaben nach und trennt, was belegt ist, von dem, was Herstellerbehauptung bleibt. Wir haben das Modell nicht ausgeführt.
Kurz vorweg: Die Zahlen zur Architektur sind in sich schlüssig, und das lässt sich nachrechnen. Die Benchmark-Tabellen sind dagegen Herstellerangaben, die sich zwischen Vorabversion und Modellkarte in mehreren Zeilen um bis zu 2,8 Punkte verschoben haben. Und das Hauptversprechen, Effizienz bei der Inferenz, lässt sich aus den veröffentlichten Daten nur teilweise überprüfen.
Was veröffentlicht wurde
| Merkmal | Angabe |
|---|---|
| Parameter gesamt / aktiv | 501,3 Mrd. / 23,4 Mrd. |
| Schichten | 52: 3 dichte plus 49 MoE-Schichten, Hidden-Größe 5.120 |
| Experten | 256 pro MoE-Schicht, 8 pro Token (Router nach DeepSeek-V3-Schema, kein geteilter Experte) |
| Attention | Gated Grouped-Query: 48 Query-, 8 Key/Value-Köpfe; 43 Schichten mit Sliding Window (512 Token), 9 mit globaler Attention |
| Kontext / Vokabular | 1 Mio. Token / 152.000 Token |
| Formate | BF16 (etwa 1 TB), FP8, NVFP4 (etwa 280 GB), dazu ein Entwurfsmodell für spekulatives Dekodieren |
| Modalität | nur Text; Wissensstand 30. Juni 2026 |
| Lizenz | Apache 2.0 |
Dazu kommt ein Rust-basiertes Agenten-Werkzeug namens Mirror CLI, mit dem Beam trainiert wurde, und eine Reihe von Partnern (laut Reflection über 40), die Inferenz, Quantisierung und Feintuning anbieten [2]. Das Modell läuft nach Angaben des Hugging-Face-Blogs vom ersten Tag an in Transformers, vLLM und SGLang [3].
Die Architektur im Nachrechnen
Der Hugging-Face-Blog nennt genug Details, um die Parameterzahl selbst zu bilanzieren. Ein Experte ist ein SwiGLU-Netz mit drei Gewichtsmatrizen der Größe 5.120 × 2.560. Das ergibt 3 × 5.120 × 2.560 = 39,3 Millionen Parameter pro Experte (eigene Rechnung), der Blog nennt „etwa 39 Mio.“ [3].
- Alle Experten: 49 Schichten × 256 Experten × 39,32 Mio. = 493,25 Mrd. Das sind 98,4 Prozent von 501,3 Mrd. und stimmt mit der Angabe des Blogs („98,4 %“) überein.
- Aktive Experten: 49 × 8 × 39,32 Mio. = 15,41 Mrd. Dazu kommen die Parameter außerhalb der Experten: 501,3 − 493,25 = 8,05 Mrd. Zusammen sind das 23,46 Mrd. aktive Parameter, die Modellkarte nennt 23,4 Mrd. [4].
- Die „etwa 8 Mrd. replizierten Parameter“ (16 GB in BF16) im Abschnitt zu Multi-GPU-Betrieb passen zu den 8,05 Mrd. [3].
Was die 8 Milliarden außerhalb der Experten enthalten, lässt sich aus den gelesenen Quellen nur zum Teil aufschlüsseln. Die Attention-Projektionen kommen nach unserer Rechnung auf etwa 3,8 Mrd. (Query 48 × 128, Key/Value je 8 × 128, Ausgabe, mal 52 Schichten; Gate-Parameter nicht eingerechnet). Eine Embedding-Matrix mit 152.000 × 5.120 Einträgen hat 0,78 Mrd. Parameter, bei getrennter Ausgabematrix doppelt so viele. Die Router haben zusammen 0,06 Mrd. Der Rest, grob 3 bis 3,5 Mrd., müsste auf die drei dichten MLP-Schichten und Kleinteile entfallen. Deren Breite nennen die gelesenen Quellen nicht. Das ist eine offene Stelle, kein Widerspruch.
Daten als Tabelle
| Gruppe | Parameter in Mrd. |
|---|---|
| Inaktive Experten (pro Token) | 477,8 Mrd. |
| Aktive Experten (8 von 256) | 15,4 Mrd. |
| Übrige Parameter | 8 Mrd. |
Quelle: Eigene Rechnung nach [3]
Eigene Rechnung aus Angaben des Hugging-Face-Blogs [3]; Experten je 3 × 5.120 × 2.560 Parameter.
Die Folge für den Betrieb: Speicher braucht man für alle 501 Milliarden, gerechnet wird pro Token nur mit 23. Die Rechenarbeit pro Token liegt nach der üblichen Näherung 2 × aktive Parameter bei etwa 47 GFLOP (eigene Rechnung, ohne Attention über den Kontext). Das Speicherverhältnis ist dagegen das eines 501B-Modells.
Der Speicher: Gewichte und KV-Cache
BF16 speichert 2 Byte pro Parameter, also 501,3 Mrd. × 2 = etwa 1.003 GB. Das passt zu „about 1 TB“ im Blog [3]. Für NVFP4 nennt der Blog etwa 280 GB. Wenn alle Gewichte in 4 Bit liegen, wären es 250,7 GB. Rechnet man pro 16 Werte einen 8-Bit-Skalierungsfaktor dazu (0,5625 Byte pro Parameter), kommt man auf 282 GB. Das ist eine Plausibilitätsprüfung, keine Bestätigung: Der Blog sagt selbst, dass einzelne Parameter in BF16 bleiben, und wie die Skalierung genau aussieht, steht in den gelesenen Quellen nicht [3].
Beim KV-Cache bringt die Mischung aus 43 lokalen und 9 globalen Schichten den größten Vorteil. Jede Schicht speichert pro Token 2 × 8 Köpfe × 128 Werte = 2.048 Werte, in BF16 also 4 KiB. Nur die 9 globalen Schichten wachsen mit dem Kontext; die 43 lokalen halten fest 512 Token.
| Kontext | Alle 52 Schichten global | Beam laut Blog | Beam, eigene Rechnung |
|---|---|---|---|
| 32K Token | 6,5 GiB | 1,2 GiB | 1,21 GiB |
| 128K Token | 26 GiB | 4,6 GiB | 4,58 GiB |
| 1 Mio. Token (1.048.576) | 208 GiB | 36,08 GiB | 36,08 GiB |
- Beam (9 globale Schichten)
- Alle 52 global
Daten als Tabelle
| Kontextlänge | Beam (9 globale Schichten) | Alle 52 global |
|---|---|---|
| 32K | 1,21 GiB | 6,5 GiB |
| 128K | 4,58 GiB | 26 GiB |
| 1 Mio. | 36,08 GiB | 208 GiB |
Quelle: Eigene Rechnung nach [3]
Eigene Nachrechnung der Tabelle aus [3]; BF16, pro Sequenz.
Die Rechnung bestätigt die Tabelle des Blogs auf die Stelle genau. Sie bestätigt aber nur das Speicherverhalten, nicht die Qualität: Wie gut ein Modell mit lokalen Schichten Information aus der Mitte eines Millionen-Token-Kontexts wiederfindet, sagt der Cache nicht. Dafür gibt es Langkontext-Benchmarks (unten: AA-LCR, LongBench v2), die jedoch weit unter einer Million Token liegen können. Zur Einordnung: In unserer Analyse von Meta Muse Spark Open kam eine eigene Überschlagsrechnung bei einer Million Token auf etwa 266 GB KV-Cache pro Sequenz (eigene Rechnung, siehe unsere Analyse von Muse Spark Open). Das Verhältnis zu Beams 36 GiB (etwa 38,7 GB) liegt bei rund sieben. Die Architekturen sind verschieden gebaut; der Vergleich zeigt eine Größenordnung, keine Bewertung.
Ein weiteres Detail: skalierte Softmax-Temperatur
Die globalen Schichten verwenden keine Positionskodierung. Stattdessen wird jede Query mit einem Faktor (1 + (Position + 1) / 2048)^0,1 skaliert, den der Blog als „scalable-softmax query scaling“ bezeichnet [3]. Bei 8K Token ist der Faktor 1,17, bei 128K 1,52 und bei einer Million 1,87 (eigene Rechnung). Die Idee, die Softmax-Schärfe an die Kontextlänge zu koppeln, ist in der Literatur beschrieben [7]; ob und wie Beam genau dem dort beschriebenen Verfahren folgt, haben wir nicht geprüft.
Die Residual-Verbindung
Eine Besonderheit ist die Gewichtung des Residual-Stroms: Beim Schritt k wird die Ausgabe der Teilschicht mit 1/√k addiert, der bisherige Strom mit √((k−1)/k) behalten [3]. Die Quadrate beider Gewichte ergeben eins, der Strom bleibt also gleich skaliert. Rechnet man die Kette aus, so trägt nach N Schritten jeder Beitrag das Gewicht 1/√N. Mit dem Embedding als Schritt 1 und 104 Additionen (52 Schichten mal zwei Teilschichten) wären das N = 105 und ein Gewicht von etwa 0,098 je Beitrag (eigene Rechnung). Das ist, was der Blog mit „every sublayer output and the input embedding carry the same weight“ beschreibt. Reflection nennt das Verfahren stabil über Vortraining, RL und Alignment hinweg, belegt es aber nur mit eigenen Abbildungen [1].
Training: was die Zahlen bedeuten
Reflection nennt für das Vortraining 23,8 Billionen Token auf 6.144 NVIDIA-GB300-GPUs in unter vier Wochen, neun halbautomatische Rücksetzungen und einen Goodput von 92,3 Prozent gegen Ende [1]. Daraus lassen sich Untergrenzen ableiten (eigene Rechnung, weil „unter vier Wochen“ eine Obergrenze der Zeit ist):
- GPU-Zeit: 6.144 × 28 Tage × 24 Stunden sind etwa 4,13 Mio. GPU-Stunden, höchstens.
- Durchsatz: mindestens 1.600 Token pro GPU und Sekunde (23,8 Bio. / (6.144 × 28 × 86.400 s)).
- Rechenaufwand: Nach der Faustregel 6 × aktive Parameter × Token sind es etwa 3,3 × 10^24 FLOP; pro GPU mindestens etwa 225 TFLOP/s im Mittel. Ob das viel oder wenig ist, hängt von der Spitzenleistung der GPU ab, die in den gelesenen Quellen nicht genannt wird. Wir bewerten es deshalb nicht.
Der Reinforcement-Learning-Lauf lief nach Angabe auf 10.500 GB300-GPUs über vier Wochen und erzeugte über 100 Millionen Rollouts mit bis zu 256K Token Kontext [1]. Hochgerechnet sind das höchstens rund 7 Mio. GPU-Stunden und mindestens etwa 14 Rollouts pro GPU-Stunde, anders gesagt etwa vier GPU-Minuten pro Rollout (eigene Rechnung; die Zeit enthält auch das Training, nicht nur die Rollout-Erzeugung). Etwa 1,3 Milliarden Sandboxes entsprechen 13 Sandboxes pro Rollout, wenn man die Zahlen direkt teilt. Dabei ist ein Hinweis nötig: Im ersten Blog steht, Training und Bewertung hätten etwa 1,3 Mrd. Sandboxes verwendet [1]. Im zweiten Blog steht, es seien etwa 1,3 Mrd. Sandboxes über Training, Evaluation und Ablationen gewesen [2]. Die Zahl gilt also für unterschiedlich weit gefasste Läufe. Die Division ist nur eine grobe Größenordnung.
Methodisch interessant, weil es sich in dieser Form selten in Herstellerdokumenten findet: Reflection beschreibt eine „controllable length penalty“, die erfolgreiche Lösungen belohnt und unnötige Token bestraft, sowie ein Pareto-Verhalten, bei dem die Kurve aus Leistung gegen Tokenverbrauch zuerst nach innen wandert (effizienter) und dann bei hohem Denkaufwand nach außen (leistungsfähiger) [1]. Der Nutzer wählt über den Parameter reasoning effort zwischen den Stufen low, medium (Standard), high, xhigh und max [3]. Alle Kurven dazu liegen als Abbildungen beim Hersteller vor; die Rohdaten haben wir nicht.
Benchmarks: Vorabversion, Modellkarte, Vergleichsmodelle
Reflection hat die Tabelle am 8. Oktober nach der ersten Ankündigung aktualisiert („Update 10/8/26“) [1]. Die Modellkarte vom 16. Oktober enthält die finalen Zahlen [4]. Wir haben die 20 Zeilen verglichen, die in beiden Quellen vorkommen (eigene Rechnung):
Daten als Tabelle
| Benchmark | Differenz |
|---|---|
| AutomationBench | 2,3 Pkt. |
| MCP Atlas | 2,1 Pkt. |
| LongBench v2 | 2 Pkt. |
| SWE-Bench Verified | 0,7 Pkt. |
| SWE Pro v1 | 0,6 Pkt. |
| DeepSearchQA | 0,4 Pkt. |
| SWE-Bench Multiling. | 0,3 Pkt. |
| GPQA Diamond | 0,1 Pkt. |
| Terminal-Bench 2.1 | 0 Pkt. |
| CriPT AA | 0 Pkt. |
| AIME 2026 | -0,1 Pkt. |
| IFBench | -0,1 Pkt. |
| HLE ohne Tools | -0,2 Pkt. |
| SciCode | -0,5 Pkt. |
| SWE Pro v2-Hard | -0,7 Pkt. |
| BrowseComp | -0,6 Pkt. |
| DeepSWE v1.1 | -1,1 Pkt. |
| AA-LCR | -1,1 Pkt. |
| Tau3 Banking | -1,9 Pkt. |
| SWE Atlas QnA | -2,8 Pkt. |
Quelle: Eigene Rechnung nach [1][4]
Eigene Rechnung: Modellkarte [4] minus Tabelle der Ankündigung [1]; BF16-Werte.
Acht Werte stiegen, zehn sanken, zwei blieben gleich; die mittlere absolute Änderung beträgt 0,9 Punkte (eigene Rechnung). Das ist keine Auffälligkeit, die Zweifel an den Daten begründet. Es zeigt aber, dass eine Rangfolge, die sich auf Abstände von ein bis zwei Punkten stützt, auf Zahlen steht, die der Hersteller selbst noch korrigiert hat. Außerdem legt die Modellkarte fest, dass alle Auswertungen mit Temperatur 0,7 und top_p 0,99 liefen [4]. Bei solchen Einstellungen schwanken einzelne Läufe, und die Karte nennt keine Zahl von Wiederholungen.
Der Vergleich mit anderen Modellen stützt sich auf die Tabelle aus der Ankündigung, in der der Hersteller selbst nur einen Teil der Felder gefüllt hat („NR“ steht für nicht berichtet) [1]. Wir haben pro Vergleichsmodell die Zeilen gezählt, in denen beide Werte vorliegen (eigene Rechnung; Zahlen in der Tabelle von Reflection, Stand 8. Oktober):
| Vergleichsmodell | Gemeinsame Zeilen | Beam vorn | Mittlere Differenz (Beam minus Modell) |
|---|---|---|---|
| Kimi K3 | 14 | 1 | -11,2 Pkt. |
| GLM 5.3 | 11 | 0 | -8,6 Pkt. |
| DeepSeek V4.1 Flash | 8 | 1 | -8,3 Pkt. |
| Qwen 3.8 Max | 13 | 0 | -4,7 Pkt. |
| GLM 5.2 | 12 | 8 | +1,2 Pkt. |
| Inkling | 12 | 11 | +7,5 Pkt. |
| Nemotron 3 Ultra | 12 | 10 (1 Gleichstand) | +11,6 Pkt. |
Daten als Tabelle
| Vergleichsmodell | Beam minus Modell |
|---|---|
| Kimi K3 | -11,2 Pkt. |
| GLM 5.3 | -8,6 Pkt. |
| DeepSeek V4.1 Flash | -8,3 Pkt. |
| Qwen 3.8 Max | -4,7 Pkt. |
| GLM 5.2 | 1,2 Pkt. |
| Inkling | 7,5 Pkt. |
| Nemotron 3 Ultra | 11,6 Pkt. |
Quelle: Eigene Rechnung nach [1]
Eigene Rechnung; Mittel über gemeinsame, vom Hersteller berichtete Zeilen; Tabelle der Ankündigung [1].
Das passt zur Einordnung, die Reflection selbst vornimmt: „competitive with larger open models like GLM 5.2 and approaching Qwen 3.8-Max“, während Kimi K3 bei roher Leistungsfähigkeit vorne liege [1]. Zu beachten ist, dass die Mittelwerte nur auf Zeilen beruhen, die der Hersteller für beide Modelle berichtet hat, und die Zeilen für verschiedene Modelle verschieden sind. In keiner der 17 Zeilen der Tabelle liegt Beam vor allen berichteten Vergleichsmodellen (eigene Zählung). Das ist für ein Modell dieser Größenklasse nicht ungewöhnlich, und die Stärke, die der Hersteller beansprucht, liegt auch in der Effizienz, nicht im Spitzenwert.
Effizienz: der Anspruch und was sich prüfen lässt
Die Modellkarte spricht von vergleichbarer Lösungsqualität mit etwa dreimal weniger Denk-Token als führende offene Modelle [4]. Die Ankündigung nennt bei Denkbenchmarks Werte ähnlich GLM 5.2 mit drei- bis viermal weniger Inferenz-Rechenaufwand [1]. Die Methode ist angegeben: FLOPs ≈ 2 × aktive Parameter × mittlere erzeugte Token pro Versuch, Daten von Artificial Analysis und DataCurve; Prefill, kontextabhängige Attention und Serving-Overhead sind ausgenommen [1].
Diese Formel ist nachvollziehbar, aber zwei Dinge bleiben offen. Erstens liefert sie ein Verhältnis aus zwei Faktoren, die beide eingehen: Parameterzahl und Tokenzahl. Ein MoE-Modell mit wenig aktiven Parametern gewinnt schon durch die Architektur einen Vorteil, der nichts mit der Denkeffizienz zu tun hat. Zweitens stammen die Token-Daten für Vergleichsmodelle aus Dritt-Messungen, die wir nicht eingesehen haben. Die Zahl „3 bis 4 mal“ ist darum hier ein Herstellerergebnis mit offener Methode, aber ohne eigene Überprüfung. Für Anwender zählt am Ende der Preis pro gelöster Aufgabe, und dazu enthalten die gelesenen Quellen keine Preisangaben.
Quantisierung: wie viel kostet sie?
Die Karte weist alle Werte für BF16, FP8 und NVFP4 aus [4]. Wir haben die 22 Benchmarks verglichen (eigene Rechnung). FP8 weicht im Mittel um +0,03 Punkte ab (Median -0,05; Spanne -1,4 bis +1,9). NVFP4 liegt im Mittel 0,50 Punkte unter BF16 (Median -0,55; Spanne -2,3 bis +2,1), in 17 von 22 Zeilen niedriger. Im Verhältnis sind das für FP8 99,9 Prozent und für NVFP4 98,9 Prozent des BF16-Werts (Median). Das spricht dafür, dass NVFP4 meist wenig kostet, mit größeren Ausreißern bei SciCode (-2,3) und Terminal-Bench (-1,7).
- FP8
- NVFP4
Daten als Tabelle
| Benchmark | FP8 | NVFP4 |
|---|---|---|
| DeepSWE v1.1 | -0,3 Pkt. | -0,6 Pkt. |
| SWE Pro v2-Hard | 1,9 Pkt. | 2,1 Pkt. |
| SWE Pro v1 | -0,2 Pkt. | -0,5 Pkt. |
| Terminal-Bench 2.1 | -1,2 Pkt. | -1,7 Pkt. |
| SWE Atlas QnA | 0,4 Pkt. | -0,4 Pkt. |
| SWE-Bench Multiling. | -0,2 Pkt. | -0,8 Pkt. |
| SWE-Bench Verified | -1,4 Pkt. | -0,9 Pkt. |
| AIME 2026 | 0,3 Pkt. | -0,2 Pkt. |
| HLE ohne Tools | 0 Pkt. | -1,2 Pkt. |
| HLE mit Tools | 0 Pkt. | 0 Pkt. |
| SciCode | -0,9 Pkt. | -2,3 Pkt. |
| CriPT AA | 1,1 Pkt. | -0,9 Pkt. |
| GPQA Diamond | -0,3 Pkt. | -1,3 Pkt. |
| LiveCodeBench | -0,2 Pkt. | -0,9 Pkt. |
| AutomationBench | -1,1 Pkt. | 0,5 Pkt. |
| MCP Atlas | 0,7 Pkt. | -0,3 Pkt. |
| Tau3 Banking | 0,7 Pkt. | -0,7 Pkt. |
| BrowseComp | -0,1 Pkt. | -1,2 Pkt. |
| DeepSearchQA | -0,9 Pkt. | 0,6 Pkt. |
| AA-LCR | 1,2 Pkt. | 0,5 Pkt. |
| LongBench v2 | 0,1 Pkt. | -0,3 Pkt. |
| IFBench | 1,1 Pkt. | -0,4 Pkt. |
Quelle: Eigene Rechnung nach [4]
Eigene Rechnung aus den Werten der Modellkarte [4]; Punkte gegenüber BF16.
Ein Detail zur Sorgfalt der Dokumente: Der Hugging-Face-Blog nennt für NVFP4 bei Terminal-Bench 2.1 78,2 Prozent, die Modellkarte 78,4 Prozent [3][4]. Der Unterschied ist klein, zeigt aber, dass auch zwischen Blog und Karte Zahlen nicht völlig deckungsgleich sind. Wir verwenden die Werte der Karte. Die Streuung dieser Auswertungen bei Temperatur 0,7 ist nicht angegeben; Differenzen von ein bis zwei Punkten würden wir deshalb nicht als Qualitätsunterschiede der Formate lesen.
Sicherheit: was der Bericht belegt
Reflection hat einen eigenen Sicherheitsbericht veröffentlicht [5]. Wir haben dessen Einleitung und den Teil zum Sicherheitstraining gelesen und die späteren Teile zu biologischen, chemischen und Kontrollverlust-Risiken nur überflogen; eine Bewertung dieser Abschnitte können wir nicht leisten. Kernaussagen laut Bericht:
- Nach dem Open Safety Framework stuft Reflection Beam in allen vier Kategorien (biologische Waffen, chemische Waffen, Kontrollverlust, Cyber-Offensive) als „Limited“ ein, definiert als keine wesentliche Verschiebung des Gleichgewichts zwischen Angriff und Verteidigung gegenüber vergleichbaren offenen Modellen [5].
- In den eigenen Iris Safety Evaluations lehnt Beam 88,9 Prozent schädlicher Anfragen ab oder lenkt um und erfüllt 81,5 Prozent harmloser Anfragen [4][5]. Der Bericht nennt das „auf der beobachteten Pareto-Front“ [5]. Die Auswertung ist intern; die Suite soll erst später offen erscheinen.
- Das Sicherheitstraining nutzt ein zweites Lehrermodell mit eigenem SFT- und RL-Ablauf und führt es mit dem Fähigkeits-Lehrer per Multi-Teacher On-Policy Distillation zusammen; die SFT-Daten folgen dem Verfahren der Deliberative Alignment [1][5][9]. Sicherheitsdaten machen laut Bericht 1,6 Prozent des SFT-Datensatzes des Sicherheitslehrers aus; das RL-Gemisch aus schädlichen und harmlosen Aufgaben hat ein Verhältnis 5 zu 1 [5].
Bei offenen Gewichten ist die Frage nach dem Verhalten nach dem Fine-Tuning zentral, weil Nutzer Schutzmechanismen entfernen können. Der Bericht verfolgt dafür ein „marginal risk“-Argument: Beam führe kein zusätzliches Risiko über das hinaus ein, was im Ökosystem ohnehin verfügbar ist [5]. Das ist eine Position, keine Messung; wir wenden sie hier nicht an.
Betrieb: Hardware und Einsatz
Der Blog empfiehlt NVFP4 auf Blackwell-GPUs. Zwei B200 mit je 180 GB halten die Gewichte (360 GB) mit wenig Platz für Aktivierungen und Cache; vier B200 (720 GB) lassen laut Blog Raum für lange Kontexte und parallele Anfragen. Auch zwei B300 mit je 288 GB oder acht RTX Pro 6000 seien möglich [3]. Pre-Blackwell-GPUs wie die H200 können NVFP4 nicht nativ rechnen; dort sind die FP8-Checkpoints vorgesehen [3].
Eine Überschlagsrechnung für die Geschwindigkeit eines einzelnen Nutzers: Pro Token müssen bei Batchgröße 1 die aktiven Gewichte gelesen werden, bei BF16 etwa 46,8 GB, bei NVFP4 (0,5625 Byte pro Parameter) etwa 13,2 GB. Pro Terabyte Speicherbandbreite ergibt das höchstens etwa 21 beziehungsweise 76 Token pro Sekunde (eigene Rechnung, idealisiert, ohne KV-Cache und Kommunikation; die Experten-Verteilung über mehrere GPUs lässt die reale Zahl darunter liegen). Bei parallelen Anfragen ändert sich das Bild, da verschiedene Token verschiedene Experten wählen und mehr Gewichte gelesen werden. Wer Beam selbst betreiben will, sollte also Durchsatz und Latenz messen und nicht aus der Parameterzahl schließen.
Lizenz und Nutzungsfreiheit
Beam steht unter Apache 2.0 [2][3]. Die Modellkarte erklärt ausdrücklich, dass Destillation, die Nutzung der Ausgaben zum Training anderer Modelle, Feintuning, Quantisierung und Zusammenführung nicht untersagt sind [4]. Die Karte hält fest, sie sei „informational only“ und ändere die Lizenz nicht. Den Lizenztext selbst haben wir hier nicht gesondert geprüft; für die rechtliche Nutzung ist der Originaltext maßgeblich. Im Unterschied zu Modellen mit eigener Nutzungslizenz (siehe unsere Analyse von Muse Spark Open) wäre das bei Apache 2.0 ein Punkt weniger, den man vor dem Einsatz abwägen muss, falls sich der Hinweis aus der Modellkarte im Lizenztext bestätigt.
Was belegt ist, was offen bleibt
Belegt (aus den Herstellerdokumenten, nachgerechnet)
- Parameterbilanz: 493,25 Mrd. Expertenparameter (98,4 %), 15,4 Mrd. aktive Experten, 8,05 Mrd. übrige; 23,46 Mrd. aktiv gegen 23,4 Mrd. auf der Karte.
- KV-Cache: 36,08 GiB bei einer Million Token statt 208 GiB bei rein globaler Attention, exakt wie im Blog.
- Gewichtsspeicher: etwa 1 TB in BF16; etwa 280 GB in NVFP4 sind mit 0,5625 Byte pro Parameter vereinbar.
- Quantisierung: Median-Abweichung gegenüber BF16 -0,05 Punkte (FP8) und -0,55 Punkte (NVFP4) über 22 Benchmarks.
Herstellerangabe, nicht unabhängig geprüft
- Alle Benchmark-Zahlen; die Zahlen haben sich zwischen Ankündigung und Karte in 18 von 20 Zeilen bewegt.
- Die Effizienzbehauptung (etwa dreimal weniger Denk-Token, drei- bis viermal weniger Rechenaufwand).
- Skala und Stabilität des RL-Laufs (100 Mio. Rollouts, 10.500 GPUs).
- Die Sicherheitsbewertung „Limited“ und die internen Safety-Evaluationen.
Offen
- Die genaue Zusammensetzung der 8 Mrd. Parameter außerhalb der Experten.
- Die Qualität bei sehr langen Kontexten bis eine Million Token.
- Kosten pro gelöster Aufgabe im Vergleich zu GLM 5.2 oder Kimi K3.
- Unabhängige Reproduktionen der Benchmarks.
Selbst prüfen: ein Testplan
- Parameterzahl: Mit der config.json und der Safetensors-Indexdatei die Tensoren aufsummieren und gegen die 501,3 Mrd. halten.
- Gleiches Harness: Terminal-Bench 2.1 und SWE-Bench Verified für Beam und die Vergleichsmodelle mit demselben Agentenaufbau (nicht Mirror gegen verschiedene Harnesses) laufen lassen und mehrere Läufe mitteln.
- Tokenverbrauch: Pro Aufgabe und Stufe (low bis max) die erzeugten Token zählen, dann Kosten pro gelöster Aufgabe bilden.
- Quantisierung: NVFP4 und BF16 mit identischen Einstellungen, mindestens fünf Läufe je Benchmark, Streuung ausweisen.
- Langkontext: Aufgaben mit Fundstelle bei 128K, 512K und einer Million Token, Fundstelle am Anfang, in der Mitte und am Ende platzieren.
Glossar
- Mixture of Experts (MoE): Architektur, in der pro Token nur ein Teil der Teilnetze (Experten) rechnet.
- Aktive Parameter: Parameter, die für ein Token tatsächlich verwendet werden.
- KV-Cache: Zwischenspeicher der Keys und Values bisheriger Token.
- Sliding-Window-Attention: Attention nur über die letzten n Token.
- NVFP4: 4-Bit-Gleitkommaformat von NVIDIA mit blockweiser Skalierung.
- Rollout: Ein vollständiger Durchlauf eines Agenten in einer Aufgabenumgebung während des RL-Trainings.
- Goodput: Anteil der Zeit, in der Trainingsschritte laufen, die im fertigen Modell erhalten bleiben.
Methode und Grenzen dieser Analyse
Gelesen und am 19. Oktober 2026 abgerufen wurden: die Ankündigung vom 5. Oktober (mit Update vom 8. Oktober), der Blog zur Verfügbarkeit vom 16. Oktober, der Hugging-Face-Blog, die Modellkarte und der Safety-Bericht [1][2][3][4][5]. Die arXiv-Verweise [6][7][8][9] haben wir nur als Seiten mit Titel geöffnet; sie stützen nur die Aussage, dass diese Arbeiten existieren und von Reflection oder Hugging Face als Referenz genannt werden. Die Formeln der eigenen Rechnungen: Parameter pro Experte = 3 × Hidden × Zwischenbreite; KV-Cache pro Token = Schichten × 2 × KV-Köpfe × Kopfdimension × Bytes; Rechenaufwand pro Token ≈ 2 × aktive Parameter; Trainingsaufwand ≈ 6 × aktive Parameter × Token; Bandbreitengrenze = Bandbreite / gelesene Bytes pro Token.
Methode
Grundlage sind die fünf Herstellerdokumente und vier arXiv-Seiten, die wir am 19. Oktober 2026 abgerufen haben. Alle Rechenschritte (Parameterbilanz, KV-Cache, Trainingsaufwand, Bandbreitengrenze, Zählung der Benchmark-Zeilen) sind eigene Überschlagsrechnungen und im Text gekennzeichnet. Wir haben das Modell nicht ausgeführt. Der Text entstand mit KI-Unterstützung und wurde von der Redaktion verantwortet.
Grenzen
Alle Benchmark-, Effizienz- und Sicherheitswerte sind Herstellerangaben. Der Safety-Bericht wurde nur in Teilen gelesen. Die arXiv-Verweise wurden nur als Titelseiten geöffnet. Die 8 Mrd. Parameter außerhalb der Experten lassen sich nur teilweise aufschlüsseln. Lizenztext nicht gesondert gelesen. Keine eigenen Tests.
Quellen
- Introducing Beam: Reflection's 501B open-weight model, Reflection (abgerufen 2026-10-19)
- Beam is now available, Reflection (abgerufen 2026-10-19)
- Welcome Beam: a 501B open model you can own, customize, and scale, Hugging Face (Ben Burtenshaw, Pedro Cuenca) (abgerufen 2026-10-19)
- reflection/Beam-1.0-501B-A23B (Modellkarte), Hugging Face (abgerufen 2026-10-19)
- Beam Safety Technical Report, Reflection (abgerufen 2026-10-19)
- DeepSeek-V3 Technical Report, arXiv 2412.19437 (abgerufen 2026-10-19)
- Scalable-Softmax Is Superior for Attention, arXiv 2501.19399 (abgerufen 2026-10-19)
- Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts, arXiv 2408.15664 (abgerufen 2026-10-19)
- Deliberative Alignment: Reasoning Enables Safer Language Models, arXiv 2412.16339 (abgerufen 2026-10-19)