 KI
Fachüberblick am Morgen, 1. November 2026. Quellenstand: 06:42 Uhr MEZ. Drei Meldungen mit direktem Praxisbezug: Anthropic weitet sein Text-Wasserzeichen auf ältere Modelle aus - begründet mit der Kennzeichnungspflicht des EU-AI-Act, und mit einer Lücke, die Integrationsverantwortliche kennen sollten. OpenAI ändert die Trainingsregeln für seine Cyber-Sessions. Und Vercel veröffentlicht eine Desktop-Steuerung für Agenten, deren Architektur zeigt, wie Computer-Use ohne Koordinatenraten aussehen kann. Jede der drei Meldungen berührt dieselbe Leitfrage aus einem anderen Winkel: Wie lassen sich KI-Systeme nachprüfbar machen - ihre Inhalte, ihre Datennutzung, ihre Aktionen.
1. Anthropic: Wasserzeichen mit Sampling-Lücke
Das Verfahren ist eine Variante von DeepMinds SynthID-Text: Bei jedem Token, für das mehrere Kandidaten gleichwertig sind, ersetzt ein Schlüssel die Zufallsquelle der Auswahl. Das Muster ist statistisch nachweisbar, ohne Zeichen hinzuzufügen, und laut Anthropic ohne messbaren Qualitätsverlust - Beleglage: interne Tests des Anbieters plus ein DeepMind-A/B-Test aus dem SynthID-Paper, keine unabhängige Nachmessung. Die Grenzen benennt Anthropic selbst präzise: kurze Passagen, faktendichte Texte und Code tragen wenig bis kein Signal; Korrekturlesen menschlicher Texte markiert kaum; eine vollständige Umschreibung entfernt das Muster. Der Nachweis beantwortet nur die Frage 'war Claude wahrscheinlich beteiligt' - nicht Urheberschaft, nicht Mensch-Text, nicht Fremdmodelle. Die Markierung gilt weltweit und auf allen Partnerplattformen (AWS, Google Cloud, Microsoft Foundry), weil Anthropic sie auf Modellebene einbaut; abschalten lässt sie sich nicht.
Neu ist die Ausweitung auf vier Altmodelle: Mythos 5, Opus 4.7, Opus 4.6 und Sonnet 4.6, laut Kunden-E-Mail, über die am 31. Oktober berichtet wurde. Der operative Punkt: Auf Opus 4.6 und Sonnet 4.6 gilt das Wasserzeichen nur bei unveränderten Standardwerten von temperature, top_p und top_k - jede Abweichung umgeht es. Anthropic warnt in der E-Mail selbst, die Defaults beizubehalten, wenn man sich auf die Markierung verlässt. Wer Claude in eigenen Produkten einsetzt und Artikel-50-Nachweise braucht, sollte diese Einschränkung in der eigenen Compliance-Bewertung berücksichtigen. Die Erkennungs-API bleibt eine private Preview für berechtigte Stellen nach EU-Recht (Regulierer, Medien, Faktenchecker, Forschende, Bildung, Zivilgesellschaft) plus Unternehmen mit eigener Prüfpflicht. Dateien erhalten separat C2PA-Content-Credentials; Anthropic begründet die Nachrüstung der Altmodelle laut dem Bericht vom 31. Oktober mit einer Dezember-Frist im Zusammenhang des EU-AI-Act. Die Pflicht selbst steht in Artikel 50 Absatz 2: Anbieter generativer KI-Systeme müssen KI-erzeugte Inhalte maschinell lesbar kennzeichnen; Ausnahmen gelten laut Artikel 50 Absatz 2, soweit Systeme eine unterstützende Funktion für die Standardbearbeitung ausführen oder die Eingabedaten oder deren Semantik nicht wesentlich verändern; die Leitlinien der Kommission präzisieren den Anwendungsbereich.
2. OpenAI: Daybreak-Sessions werden trainierbar
Die aktualisierte Hilfeseite zu den Datenkontrollen (Stand 31. Oktober) formuliert unmissverständlich: Während Daybreak-Sessions auf einem privaten Konto darf OpenAI Inhalte zur Modellverbesserung nutzen, auch wenn 'Improve the model for everyone' deaktiviert ist - begründet mit dem Schutz vor Cyber-Missbrauch. Außerhalb von Trusted-Access-Sessions gilt der normale Schalter weiter. Laut Kunden-E-Mail greift die Regel ab 29. November; nach Protesten kündigte eine zweite E-Mail einen Daybreak-spezifischen Opt-out an, der auf der Hilfeseite zum Recherchezeitpunkt noch nicht sichtbar war. Nicht betroffen: Business-, Enterprise-, Edu- und API-Konten (dort ist Nicht-Training Standard) sowie Nicht-Daybreak-Nutzung. Codex hat ohnehin einen separaten Schalter für Umgebungskontext. Für Projektfreigaben heißt das: Wer Daybreak einsetzt, dokumentiert die Datenflussentscheidung neu; wer es nicht nutzt, muss nichts ändern.
Einordnung: Der Vertrauensbruch liegt weniger in der Regel selbst als in der Zielgruppe - Daybreak-Nutzer arbeiten mit Malware-Samples, Exploit-Details und internem Sicherheitswissen, also genau den Inhalten, die niemand in Trainingskorpora sehen will. Die Kritik verweist auf den Fall Buckmaster/Alpöge, bei dem der bloße Verdacht ungekennzeichneter Trainingsnutzung aus Codex-Eingaben für Schaden sorgte. Bis der Opt-out tatsächlich ausgeliefert ist, ist die saubere Lesart: Daybreak-Sessions auf Privatkonten als potenziell trainierbar behandeln. Das ist eine Zustandsbeschreibung aus den genannten Quellen, keine Bewertung der Rechtmäßigkeit.
3. Agent Desktop: Computer-Use ohne Pixelraten
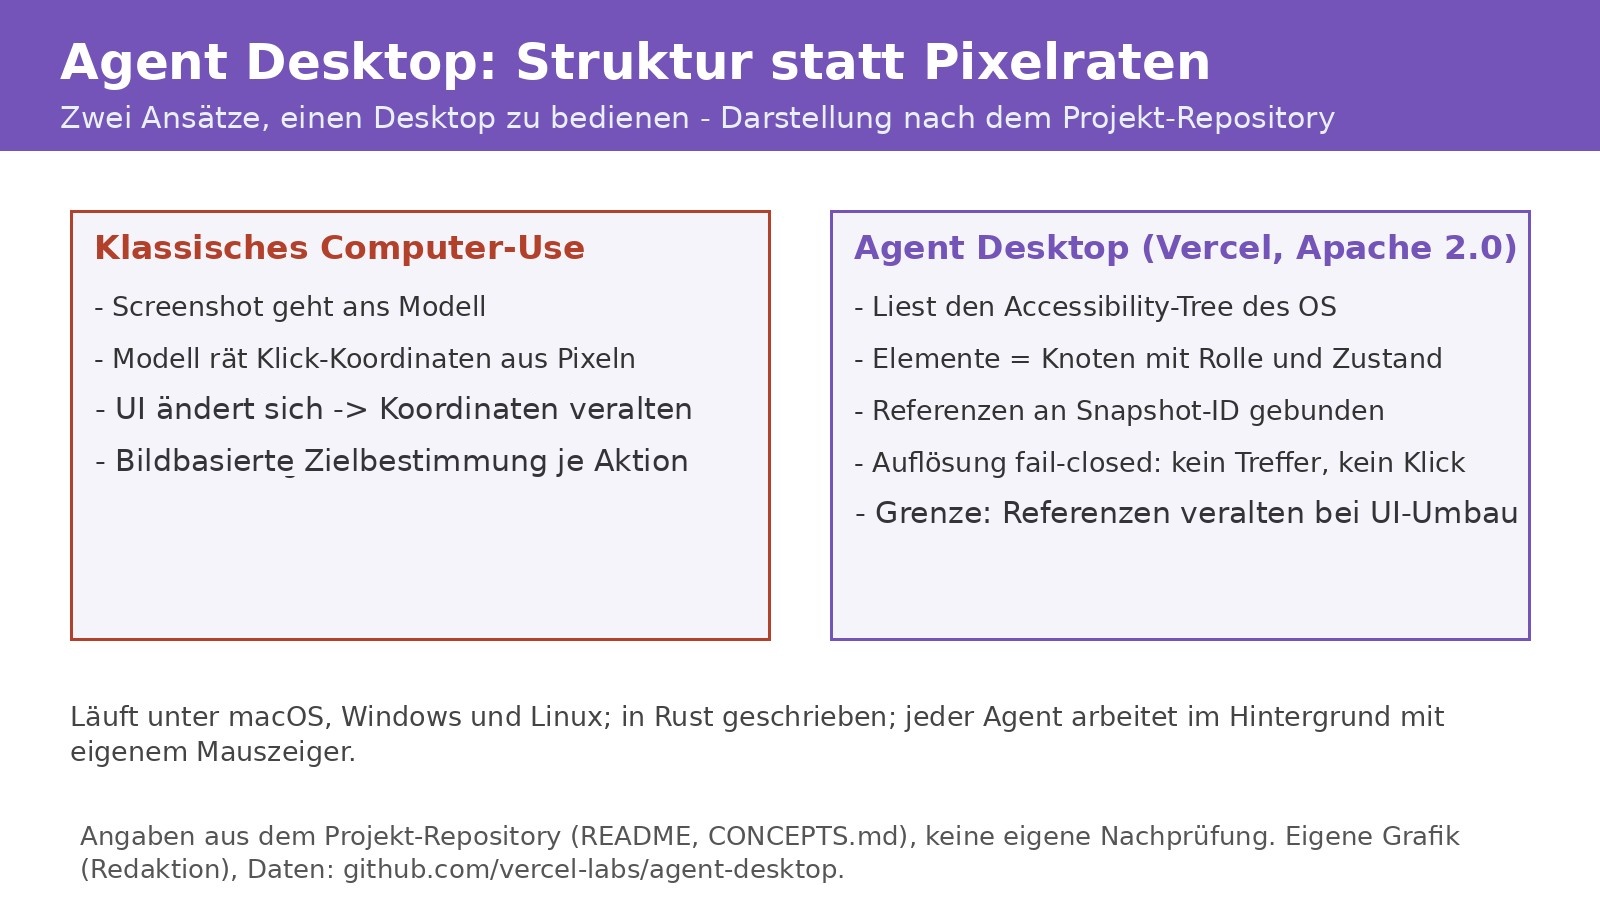
Vercels Agent Desktop (Apache-2.0-Lizenz, Rust, aktiv gepflegt, aktuell Version 1.0.2) gibt beliebigen Coding-Agenten Desktop-Zugriff unter macOS, Windows und Linux. Architektonisch ersetzt es den Screenshot-Ansatz durch den Accessibility-Tree des Betriebssystems als Beobachtungsquelle: Elemente werden als strukturierte Knoten mit Rollen und Zuständen gelesen, nicht als Pixel geraten. Referenzen sind an Snapshot-IDs gebunden; vor jeder Aktion löst ein Strict-Resolution-Verfahren die Referenz fail-closed gegen die Live-Oberfläche auf - fehlende, veraltete oder mehrdeutige Treffer führen zum Abbruch statt zum geratenen Klick. Fenster- und Display-Identitäten werden gegen Handle-Recycling abgesichert (Identity-Checks unmittelbar vor dem Schreibzugriff), und Lesevorgänge unterscheiden strikt zwischen 'Eigenschaft existiert nicht' und 'Lesen fehlgeschlagen'. Das Projekt dokumentiert diese Entscheidungen ungewöhnlich offen: Das CONCEPTS-Dokument beschreibt etwa, warum 'unbekannt' und 'nicht vorhanden' niemals zusammengelegt werden dürfen - ein Muster, das sich auf jede Agenten-Integration übertragen lässt.
Relevanz für Agenten-Stacks: Das ist eine der ersten offenen Implementierungen, die die Fehlerklasse 'falsches Element, falscher Zeitpunkt' systematisch statt promptseitig angeht. Grenzen: Referenzen überleben keine UI-Änderungen, dichte Web-Oberflächen erfordern Tiefen-Budgets mit Wrapper-Erkennung, und Linux-Unterstützung ist erst seit Ende Oktober integriert. Für produktive Agenten-Workflows ist das Projekt eher Baustein als fertige Lösung - aber ein lehrreicher.
Quellen
- How Claude's text watermarking works, Anthropic (abgerufen 2026-11-01)
- How Claude marks AI-generated content, Claude Help Center (abgerufen 2026-11-01)
- Anthropic's watermark rollout leaves a loophole on two older Claude models, THE DECODER (abgerufen 2026-11-01)
- Data controls in ChatGPT (Abschnitt 'Trusted Access on personal accounts'), OpenAI Help Center (abgerufen 2026-11-01)
- OpenAI plans to train models on Daybreak Blue cybersecurity session data that was previously off-limits, THE DECODER (abgerufen 2026-11-01)
- vercel-labs/agent-desktop (README, CONCEPTS.md, LICENSE), GitHub / Vercel Labs (abgerufen 2026-11-01)