 KI
Abendüberblick vom 11. November 2026. Quellenstand: 16:03 Uhr MEZ. Der Quellenabgleich umfasst drei Preprints vom 10. November: eine vorab registrierte Matched-Compute-Studie zu dichten Belohnungen in GRPO, ein Diagnosebenchmark für VLM-Gutachter mit gekoppelten kontrafaktischen Trajektorien und eine Enthaltungsreparatur als Constraint-Problem. Alle Zahlen sind Angaben der Autorenteams; die Versuche wurden von uns nicht wiederholt.
GRPO: Dichte Belohnungen unter fairer Rechenrechnung
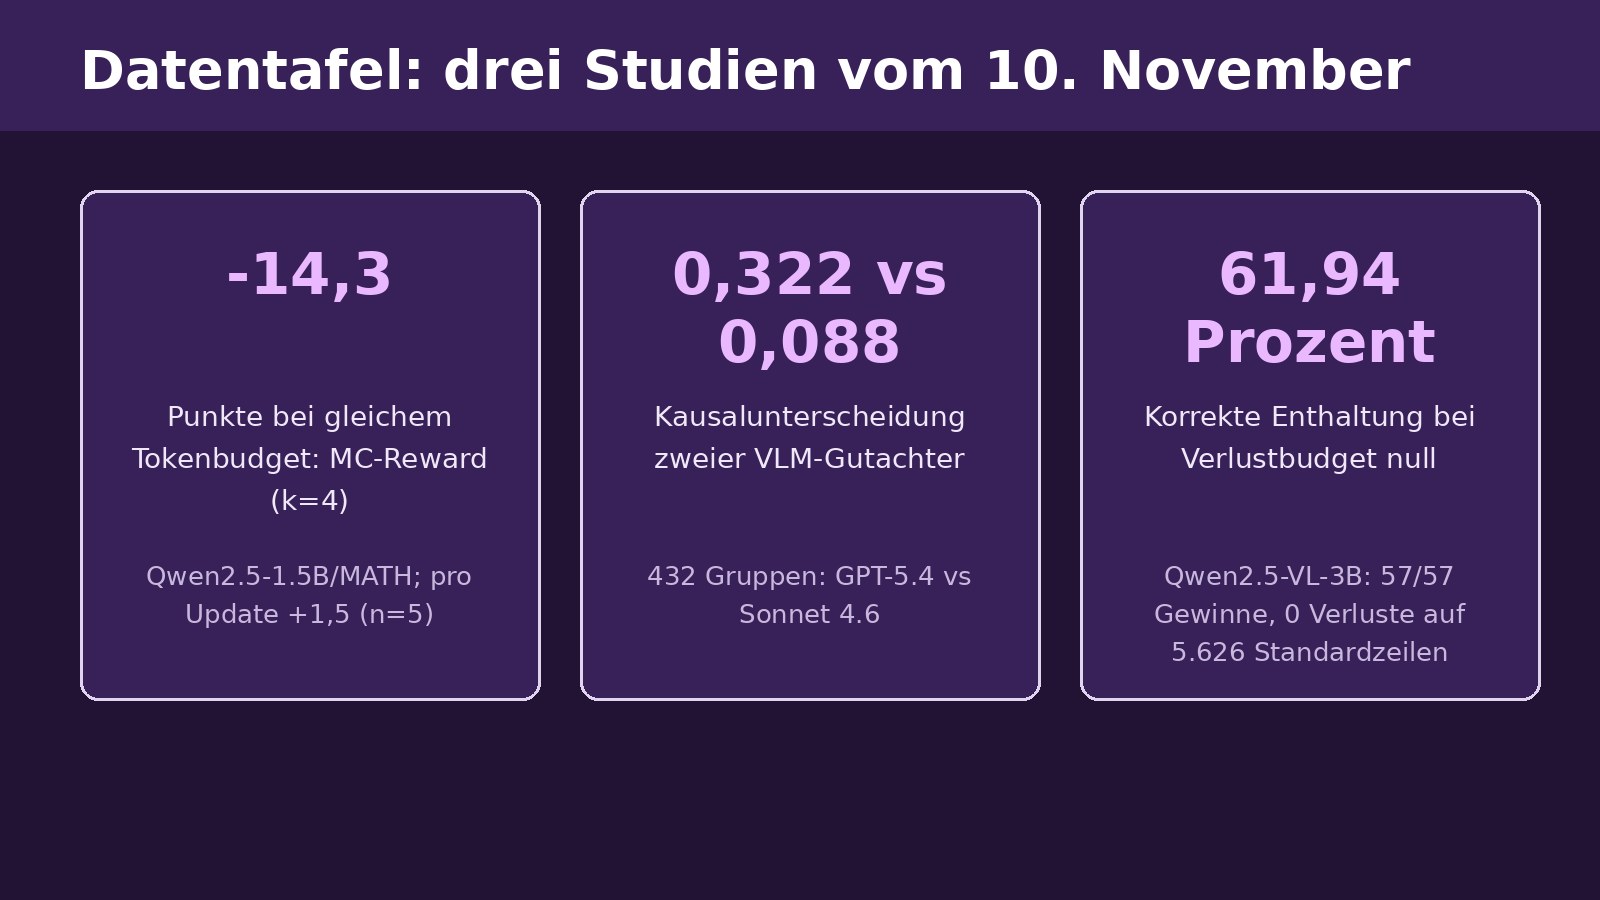
Singh und Kollegen (Case Western Reserve University) berichten 1.668 Läufe mit 1.468 GPU-Stunden über sechs Qwen- und Llama-Modelle, mit angeglichenem Rechenaufwand, vorab registrierten Studien und 95-Prozent-Intervallen über Seeds und Holm-korrigierten p-Werten. Die Monte-Carlo-Belohnung mit k=4 auf Qwen2.5-1.5B-Instruct und MATH investiert 91 Prozent der erzeugten Tokens in Fortsetzungen und erreicht dadurch nur 50 statt 584 Updates. Pro Update führt sie mit +1,5 Punkten [1,0;2,1] und ist 1,56-mal so effizient; bei gleichem Tokenbudget endet sie −14,3 Punkte [12,7;16,0] hinter GRPO (n=5, Holm p=5e-5), repliziert mit −14,9 auf zwölf frischen Seeds, bei gleicher Trainingszeit −7,8 [6,8;8,8]. Die Defizite wiederholen sich auf Qwen3 0,6/1,7/4B (8,0/9,1/10,0 Punkte), GSM8K (9,8) und einem 768-Token-Budget (6,6). Keine dichte Variante schlägt GRPO bei gleicher Trainingszeit: k=4 −3,3; Fortsetzungs-Reuse −5,2; VinePPO-artig −1,1 innerhalb ±2; k=1 −1,1 nicht signifikant.
Der Gradiententest zeigt anfängliche mittlere Kosinus-Übereinstimmung von 0,84; bei späteren Prüfständen des hoch gewichteten Rewards 0,969 bis 1,000, überschätzt aber jede Belohnungsvariante um ein bis zwei Punkte. Ein hohes Reward-Gewicht α=5 verliert 12,4 Punkte bei steigender Entropie (0,21 auf 0,58); die Autoren sprechen von Überoptimierung, nicht Fehlausrichtung. Prompt-Auswahl nahe vorhergesagter Erfolgsquote 1/2 bringt +1,7 Punkte (Qwen3-0.6B) beziehungsweise +0,8 (Qwen2.5-1.5B) bei gleichen Tokens, repliziert auf frischen Seeds und 1.543 ungesehenen Aufgaben; der Filter erreicht die Endgenauigkeit von GRPO mit 0,78 des Tokenbudgets, bei doppeltem Budget schrumpft der Vorsprung auf 0,5 [−0,5;+1,6] (TOST-Äquivalenz), und eine neu abgestimmte Lernrate der GRPO-Baseline kommt bis auf 0,5 Punkte heran. Ein nachsichtiger Verifizierer führt zu Drift (Läufe hören auf, Antworten zu boxen); ein strikter Verifizierer beseitigt den Drift ohne Genauigkeitsverlust. Code: github.com/vicky157/grpo-validation.
GridWM-Judge: Gutachter gegen ihre Verpackung
Zhang, Wang, Jin und Kollegen (University of Science and Technology of China) definieren Zustandsbedingte Invarianz (SCI): stabil unter Darstellungsänderungen, empfindlich unter kausalen Änderungen des Ausgangs. GridWM-Judge nutzt deterministische MiniGrid-Trajektorien als prüfbare Referenz mit abgeglichenen Full-, Evidenz-Entfernungs- und Kontrafaktik-Varianten plus Darstellungs- und Repräsentationssonden; fünf diagnostische Aufgaben decken lokale Wahrnehmung, aktionsbedingte Übergänge, Darstellungsstabilität, Repräsentationsaustausch und Kausalunterscheidung ab. Getestet werden zehn Gutachter: Claude Sonnet 4.6, GPT-4o, GPT-5.4, Gemini 3 Flash, Gemini 2.5 Flash Lite, Gemini 2.0 Flash, Kimi K2.5, Qwen3-8B, Qwen3-32B, Qwen3-235B.
Genauigkeit impliziert keine Kausalempfindlichkeit: Task D mit Referenz misst für GPT-5.4 Full-Akzeptanz 0,750, Kontrafaktik-Verwerfung 0,500 und rohe IDR 0,333; Sonnet 4.6 liegt bei 0,250, 0,917 und 0,250. Auf 432 erweiterten Gruppen stehen rohe IDR 0,322 [0,278;0,366] gegenüber 0,088 [0,062;0,116] (Gruppen-Bootstrap). Sonnet 4.6 ist unter Composite-Storyboards allfail-degeneriert (JAcc 0,06), unter Split-Bildern nicht; Qwen3-32B ist unter Composite erfolgsverzerrt. Der Wechsel Composite zu Split verschiebt JAcc um +0,061, p_active um +0,048 und IDR_raw um +0,173 im Modellmittel, alles nicht signifikant (Wilcoxon p=0,063 für IDR). Scope laut Autoren: kontrollierte MiniGrid-Diagnose mit deterministischen Rollouts, keine Einsatzschätzung für reale Robotik, kein Leaderboard, Standardprompts; ergänzende MiniWorld-/Habitat-Versuche werden separat berichtet; empfohlen wird gemeinsames Reporting von Korrektheit, Darstellungsstabilität und Kausalempfindlichkeit. Bildformat, Prompt-Wortlaut und Laufbedingungen änderten sich gemeinsam; der Unterschied lässt sich nicht allein dem Layout zuschreiben.
ReFrain: Enthaltung als Constraint-Problem
Jinyuan Zhang (Hubei University) maximiert die korrekte Enthaltung unter der Nebenbedingung, dass die negative Flip-Rate gegenüber dem Ausgangsmodell ein Budget ε nicht überschreitet. Die Pipeline: lineare Probe auf den Logits des ersten Tokens, Schwellenkalibrierung auf zurückgehaltenen Bildclustern, deterministisches Veto zugunsten der angezeigten NOTA-Option. Auf einem geteilten Qwen2.5-VL-3B-Prüfpunkt nach Antwort-SFT hält ε=0 alle 57 SFT-gewonnenen Antworten bei null verlorenen ursprünglich richtigen Antworten unter 5.626 Standard-Auswertungszeilen; die korrekte Enthaltung steigt von 54,63 auf 61,94 Prozent (+7,30 pp). Bei ε=0,5 Prozent: 74,05 Prozent mit acht Verlusten und 55 von 57 erhaltenen Gewinnen.
Baselines am selben Startpunkt: CLIP-UP EmbLoRA 64,65 Prozent bei 62 Verlusten; dieselbe Probe ohne Kalibrierung verliert 298; einfaches Abstention-SFT 87,47 Prozent bei 140 Verlusten. Die nach dem Einfrieren gelaufene Bestätigung auf 228 unabhängigen AI2D-Clustern (271 Bilder, 912 Standard- und 816 UPD-Zeilen) zeigt 66,05 Prozent korrekte Enthaltung ohne Verluste am 0,5-Prozent-Punkt (+32,72 pp über EmbLoRA); Abstention-SFT liegt dort +4,90 über ReFrain, allerdings mit Verlusten. Auf zwei Basismodellen ohne SFT (Qwen2.5-VL-3B, InternVL3-8B) verliert das Null-Budget zwei beziehungsweise vier ursprünglich richtige Antworten. Grenzen: ein Trainings-Seed, 677 Trainingszeilen, die Schranke 1/(K+1) gilt nur für das Null-Budget und einen neuen austauschbaren Cluster; Retention-Werte stammen nur von Qwen2.5-VL-3B. Code: github.com/ModeLiberaL/ReFrain.
Quellen
- Are Dense Rewards Worth Their Tokens in GRPO? A Matched-Compute Study, arXiv (Singh u.a.; Case Western Reserve University) (abgerufen 2026-11-11)
- Towards Reliable VLM Judges: State-Conditional Invariance and Presentation-Aware Diagnostics, arXiv (Zhang, Wang, Jin u.a.; University of Science and Technology of China) (abgerufen 2026-11-11)
- Multimodal Abstention That Preserves Acquired Correct Answers, arXiv (Jinyuan Zhang; Hubei University) (abgerufen 2026-11-11)