 KI
Fachüberblick am Mittag des 4. November 2026. Quellenstand: 09:52 Uhr MEZ. Drei Releases mit Substanz: ein hybrider Computer-Use-Agent mit offenen Gewichten, ein agentisches Chemie-Setup und zwei indische Modellfamilien. Alle Benchmark-Werte bleiben Anbieterangaben.
Mage-VL-Cowork: hybride Kanäle in einer 4B-Policy
Microsofts Mage-Team hat Mage-VL-Cowork mit Gewichten (Apache 2.0 auf Hugging Face) und Code veröffentlicht. Eine einzige 4B-Vision-Language-Policy wählt pro Zug zwischen GUI-Aktionen (Screenshot-basiertes Klicken und Tippen) und Terminal-Aktionen (Code, CLI, Anwendungsbibliotheken) - ohne externen Orchestrator. Microsoft meldet 66,0 % auf OSWorld-Verified: 361 Held-out-Tasks ohne Google Drive, 50-Schritte-Budget, Mittel aus zwei Läufen. Zum Vergleich nennt die Seite Mensch 72,4 %, GPT-5.5 78,7 % und ScaleCUA-Qwen3.5-9B 68,7 %; bei OS- (87,5 %) und Multi-App-Workflow-Tasks (62,7 %) liegt das 4B-Modell demnach vorn. WebVoyager-Static (SFT-Checkpoint, vor RL): 58,6 %, hinter dem spezialisierten Fara1.5-4B (68,0 %).
Das Training folgt einem fünfstufigen Curriculum: GUI-Midtraining, GUI-SFT, Coding- und Terminal-SFT, hybrides CUA-SFT, dann Online-RL (GRPO, asynchrone Rollouts). Die Stufen ergeben 45,56 %, dann 55,84 %, schließlich 66,0 %; RL senkt dabei die mittleren Modellaufrufe von 21,57 auf 18,77 und die Ausgabe-Token von 7.374 auf 5.499 pro Task. Die Synthese-Pipeline Mage-CUA-Forge erzeugte 293.806 Desktop- und Web-Tasks über 6.915 Skills und senkt laut Microsoft die wiederkehrenden Erzeugungskosten pro Task um 82,6 % (0,906 auf 0,158 US-Dollar). Bemerkenswert ist das Harness-Experiment: Mit identischem Teacher-Modell erzielte das aufgeräumte GUI+Coding-Harness 92,0 % gegenüber 89,6 % mit zusätzlichem Accessibility-Kanal - die darauf trainierten 4B-Students lagen bei 37,6 % gegenüber 25,1 %. Das technische Paper (arXiv:2610.40747) haben wir nicht eigenständig gelesen; alle Werte stammen von Microsofts Projektseite und Modellkarte.
Cheminformatics in Antigravity: LLM orchestriert, RDKit rechnet
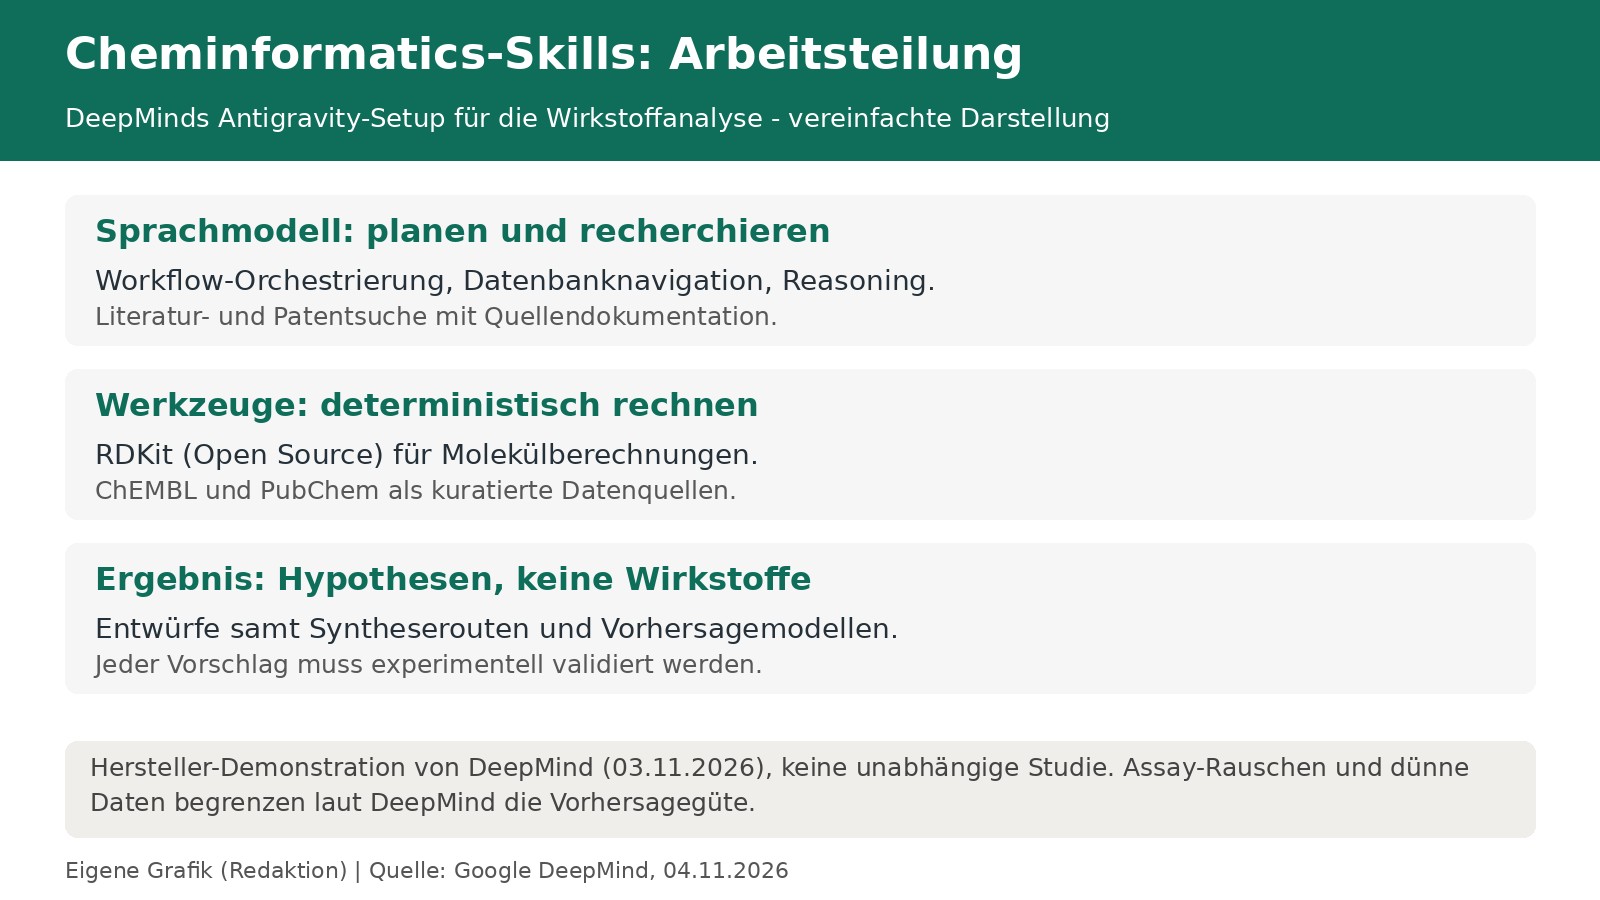
DeepMinds neue Skills binden den Antigravity-Agenten an RDKit sowie kuratierte Ressourcen von ChEMBL und PubChem an. Das Sprachmodell übernimmt Workflow-Orchestrierung, Datenbanknavigation und Reasoning; molekulare Berechnungen laufen in deterministischen Werkzeugen. DeepMind begründet das mit der Fehleranfälligkeit von Molekülrepräsentationen - ein einzelnes verändertes Atom beschreibt eine andere Verbindung. Verfügbar ab sofort: Antigravity-App plus Science-Plugin, Enterprise-Zugang über Google-Cloud-Konten; 10.000 Forschende sollen gestaffelt sechs Monate die höchste Nutzungsstufe kostenlos erhalten.
Die vorgeführte Rigidifizierungs-Analyse (Crizotinib mit fünf rotierbaren Bindungen versus zyklisiertes Lorlatinib) zeigt den Ablauf: Literatur- und Patentrecherche mit Extraktion Tausender Verbindungen, Filterung und Quellendoku (568 kuratierte Substanzen im Beispiel), Matched-Molecular-Pair-Analyse, dann Potenzmodelle mit chronologischen oder Scaffold-Splits über vier Readouts und zuletzt neue Makrozyklus-Entwürfe samt Syntheserouten und Elektronenschiebe-Diagrammen. DeepMind spricht von etwa einer Stunde statt mehrerer Tage pro Iteration - eine Hersteller-Demo. Die eigene Einordnung des Teams bleibt wichtig: Entwürfe sind testbare Hypothesen, keine fertigen Medikamente; Assay-Rauschen und dünne Daten begrenzen die Vorhersagegüte.
EKA-1 und Dhīr: vorgestellt, Download in geprüften Quellen offen
Die IndiaAI-Mission (MeitY) hat EKA-1 von Soket Labs und Dhīr 2B/5B von ZenteiQ vorgestellt. EKA-1: 26,3 Milliarden Parameter, rund 7,5 Billionen Trainings-Token, laut Pressemitteilung ein offenes, sparsam aktiviertes Hybridmodell für Mathematik, Code, Reasoning und agentische Aufgaben in 22 indischen Sprachen plus Englisch. Dhīr 2B (dicht, 2,03B) und Dhīr 5B MoE (5,09B gesamt, 1,79B aktiv, 2 von 12 Experten) teilen Tokenizer (131k Einträge, eigenentwickelt) und Rezept, haben 16.384 Token Kontext und wurden laut ZenteiQ mit über 6 Billionen Token auf TPU v6e in Mumbai von Grund auf trainiert - das Unternehmen nennt sie die ersten indischen Milliarden-Parameter-Modelle komplett von null, was wir nicht unabhängig verifiziert haben.
ZenteiQ meldet auf 41 Benchmarks gegen 24 offene Modelle (1-7B): Dhīr 2B insgesamt 61,4 %, Dhīr 5B MoE 64,6 %; Dhīr 2B führe seine Klasse bei 13 von 15 Indic-Benchmarks an. Gemessene Dekodiergeschwindigkeit (llama.cpp, 4-Bit): für Dhīr 5B MoE 20,5 Token/s auf Intel Iris Xe, 39,9 auf Jetson Orin NX und 2,8 auf Raspberry Pi 4. Die selbst genannten Grenzen: Faktenabruf ohne Quelle ist die schwächste Stelle, kein Reasoning-Modus, nur Text, Instruction-Following nur auf Englisch gemessen. Zur Verfügbarkeit: Trotz der Open-Source-Bezeichnung war in den geprüften Anbieterquellen kein öffentlicher Gewichtsdownload verlinkt - Soket beschreibt eine künftige offene Freigabe, ZenteiQ auf Enterprise-Lizenzen und Piloten (Stand: 09:52 Uhr MEZ). Dhīr 9B ist angekündigt.
Quellen
- Mage-VL-Cowork: A Full Training Recipe to Learn Hybrid Computer Use from Evolved Harnesses, Microsoft (Projektseite) (abgerufen 2026-11-04)
- microsoft/Mage-VL-Cowork (Modellkarte), Hugging Face (abgerufen 2026-11-04)
- Agentic cheminformatics with Google Antigravity, Google DeepMind (abgerufen 2026-11-04)
- IndiaAI Mission Released Indigenous Foundation Models EKA-1 and Dhīr 2B & Dhīr 5B, Press Information Bureau, Indien (abgerufen 2026-11-04)
- Dhīr 2B and Dhīr 5B MoE, ZenteiQ (abgerufen 2026-11-04)
- Eka (Projekt-Charter und Early Access), Soket AI (abgerufen 2026-11-04)