 KI
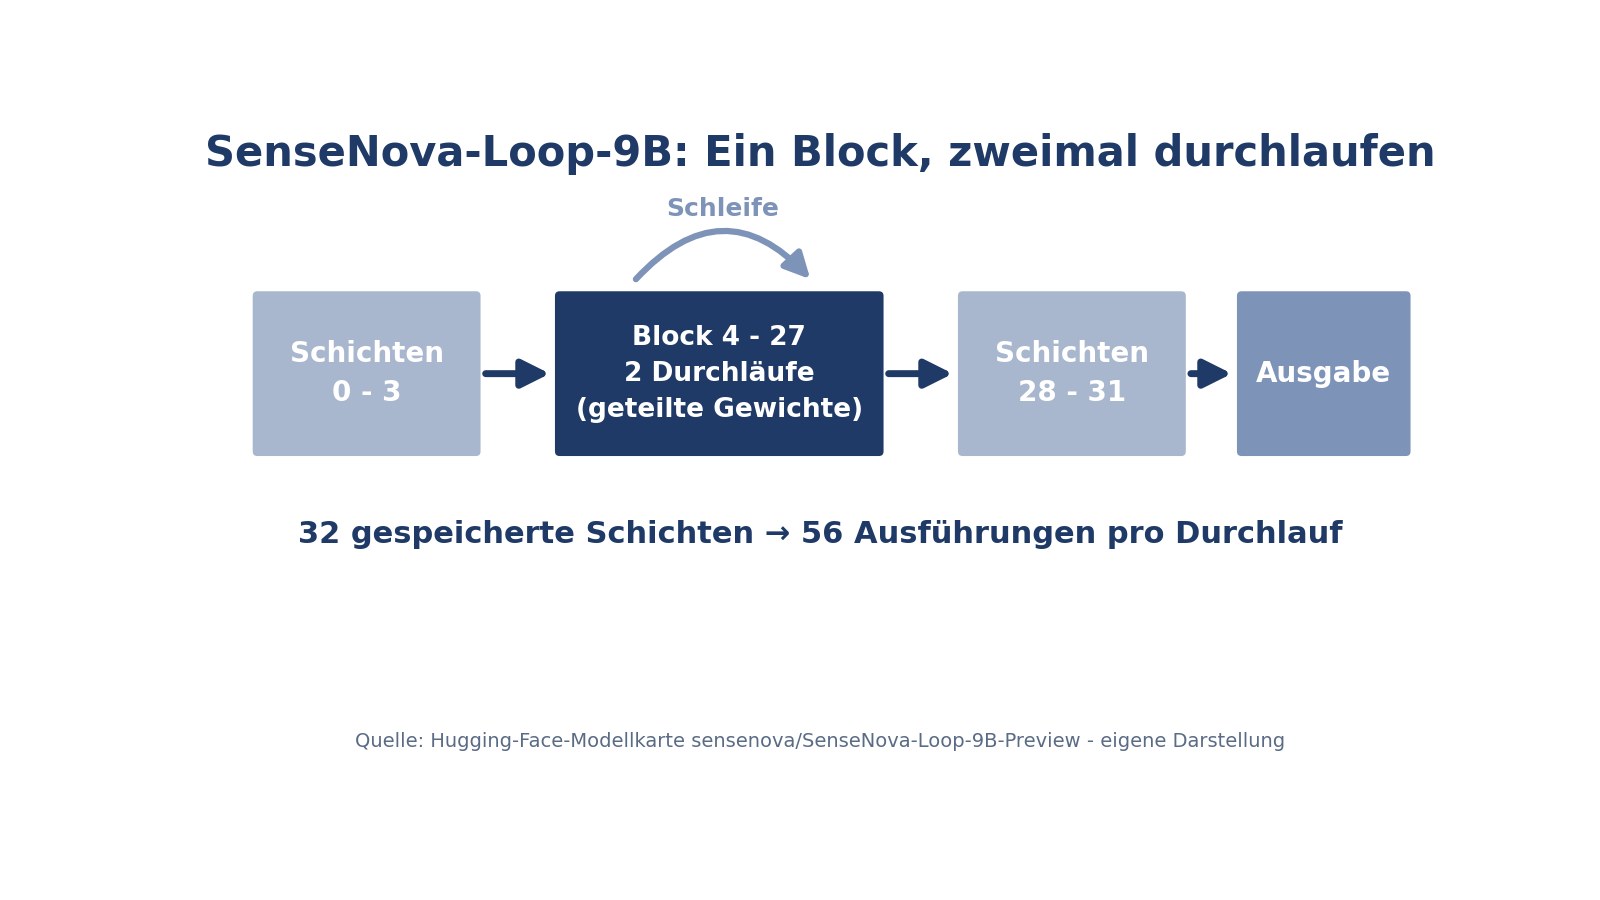
SenseTime hat SenseNova-Loop-9B-Preview veröffentlicht, ein multimodales Modell für lange Kontexte und agentische Arbeitsabläufe. Der News-Eintrag in der Modellkarte trägt das Datum 30. Oktober; das Hugging-Face-Repository wurde laut Plattform-API am 28. Oktober angelegt. Das Modell verarbeitet Text und Bilder und erzeugt Text - Zielanwendungen sind Dokumentenverständnis, Programmieren und der Umgang mit externen Werkzeugen. Die Gewichte stehen unter Apache 2.0, das Training umfasste Sequenzen bis 262.144 Tokens [1][2].
Die Eckdaten
SenseNova-Loop-9B-Preview im Überblick (Herstellerangaben) [1]
Parameter
ca. 9 Mrd. gespeichert; die Karte nennt ca. 14,6 Mrd. Ausführungsparameter durch den doppelten Durchlauf
Schichten
32 gespeicherte Decoder-Schichten, 56 Ausführungen pro Durchlauf; Schleife über Schicht 4 bis 27, zwei Pässe
Restströme
Zwei-Strömige mHC (manifold-constrained hyper-connections), Sinkhorn-Normalisierung mit 20 Iterationen
Aufmerksamkeit
Hybrid: je Vierergruppe drei lineare und eine volle Schicht; 16 Köpfe, 4 KV-Köpfe
Weitere Werte
Hidden 4.096, Feed-Forward 12.288, Vokabular 248.320; BF16-Backbone, FP32-Routing-Parameter
Lizenz
Apache 2.0 (Gewichte und Code), Eingabe Text/Bild, Ausgabe Text
Wie die Schleife funktioniert
Der Decoder verarbeitet die Eingabe zunächst durch die Schichten 0 bis 3. Dann läuft derselbe Block der Schichten 4 bis 27 zweimal hintereinander - die Karte schreibt das als B(B(h)), der zweite Pass bekommt die Ausgabe des ersten als Eingabe. Erst danach folgen die Schichten 28 bis 31 und der Ausgabekopf. Gespeichert werden also 32 Schichtgewichte, gerechnet wird mit 56 Schicht-Ausführungen. Die Schleifengrenzen liegen auf ganzen Vierergruppen, damit das Aufmerksamkeitsmuster über beide Pässe erhalten bleibt. Innerhalb der Schleife führen zwei Restströme Informationen an den Schichten vorbei; gelernte Abbildungen steuern, was eine Schicht aus den Strömen liest und zurückschreibt. Schleifenbereich, Passzahl und Routing-Parameter sind Teil des Checkpoints - eine Inferenz-Implementierung muss exakt diese Reihenfolge nachbauen [1].
Die gemeldeten Messwerte
Die Modellkarte zeigt eine Balkengrafik mit acht Benchmarks und sechs Vergleichsmodellen. SenseNova-Loop-9B-Preview führt das Vergleichsfeld nicht auf jedem Test an; insbesondere bei Terminal Bench 2.1 und T³-Banking liegen andere Balken höher. Die Werte des Modells: BIRD-Dev 71,38, WorkBuddy Bench 66,89, AIDABench 58,87, TeamBench 48,89, Terminal Bench 2.1 40,45, T³-Banking 18,56 und AutomationBench 13,72. Auf dem achten Test, RaccoonPPTBench, erreicht es 70,70 - laut Fußnote ein intern entwickeltes Präsentations-Benchmark. Alle Angaben stammen aus der Herstellergrafik; die Fremdwerte der Vergleichsmodelle geben wir nicht wieder [1].
Daten als Tabelle
| Gemeldeter Wert | |
|---|---|
| BIRD-Dev | 71,38 |
| WorkBuddy Bench | 66,89 |
| AIDABench | 58,87 |
| TeamBench | 48,89 |
| Terminal Bench 2.1 | 40,45 |
Herstellerangaben aus der Benchmark-Grafik der Modellkarte, nicht unabhängig verifiziert [1]. Je Benchmark eigene Aufgaben und Metriken - die Werte sind nicht testübergreifend vergleichbar.
Praxis: Voraussetzungen und offene Punkte
Der Betrieb verlangt eigenen Modellcode: Das Laden läuft über trust_remote_code, geprüft ist die Kombination aus Transformers 5.18.0 und PyTorch 2.11.0 mit CUDA 13.0. Für vLLM und SGLang verweist die Karte auf die Pull-Requests 64832 beziehungsweise 47281 - beide sind zum Redaktionszeitpunkt offen, nicht Teil einer Veröffentlichung; der SGLang-Request beschreibt die Implementierung als auf Qwen3.5 aufbauend. Eine LightLLM-Variante läuft per Docker auf vier GPUs. Multi-Token-Prediction ist verfügbar, die Speculative-Decoding-Entwürfe Dspark und Dflash2 befinden sich laut Karte noch im Training. Den technischen Bericht markiert die Karte als ausstehend. Die Verbreitung: 2.221 Downloads im letzten Monat und 215 Likes (Plattform-Zähler, Stand 4. November) [1][3].
Einordnung
Die Schleifen-Architektur ist ein Speicher- und Rechentausch: mehr Ausführungstiefe ohne mehr gespeicherte Gewichte, bezahlt mit doppelter Rechenzeit im Schleifenblock. Dass im Vergleichsfeld mit IQuest-Coder-V1-40B-Loop ein zweites Loop-Modell auftaucht, zeigt: Die Idee liegt in der Luft. Die Aussagekraft der Zahlen ist begrenzt - alle Werte kommen aus einer Hand, ein technischer Bericht fehlt, und der Preview-Status ist Teil des Namens. Wer die Architektur studieren will, findet mit Apache-2.0-Gewichten, Trainings- und Draft-Skripten auf GitHub aber ungewöhnlich viel Material zum Anfassen [1][2].
Methode
Analyse auf Basis der vollständig gelesenen Hugging-Face-Modellkarte (englische README), der Hugging-Face-Repository-API (Anlagedatum, Download-Zähler), des GitHub-Repositories und des SGLang-Pull-Requests 47281 (Status: offen). Die Benchmark-Werte wurden aus der Balkengrafik der Modellkarte abgelesen und sind Herstellerangaben; Fremdwerte der Vergleichsmodelle werden nicht als deren eigene Werte wiedergegeben.
Grenzen
Keine eigenen Tests. Sämtliche Messwerte stammen aus einer Herstellergrafik; ein technischer Bericht liegt nicht vor. Die Angabe zu Ausführungsparametern (ca. 14,6 Mrd.) ist keine zweite Modellgröße, sondern Folge des doppelten Durchlaufs. Uns ist keine unabhängige Fremdmessung bekannt.
Quellen
- sensenova/SenseNova-Loop-9B-Preview (Modellkarte und Repository-API), Hugging Face / SenseTime (abgerufen 2026-11-04) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- OpenSenseNova/SenseNova-Loop (Code, Trainings- und Draft-Skripte), GitHub / OpenSenseNova (abgerufen 2026-11-04) ↩1 ↩2
- SGLang Pull Request 47281: sensenova_loop - Add multimodal Loop and mHC inference, GitHub / sgl-project (abgerufen 2026-11-04) ↩1 ↩2