 KI
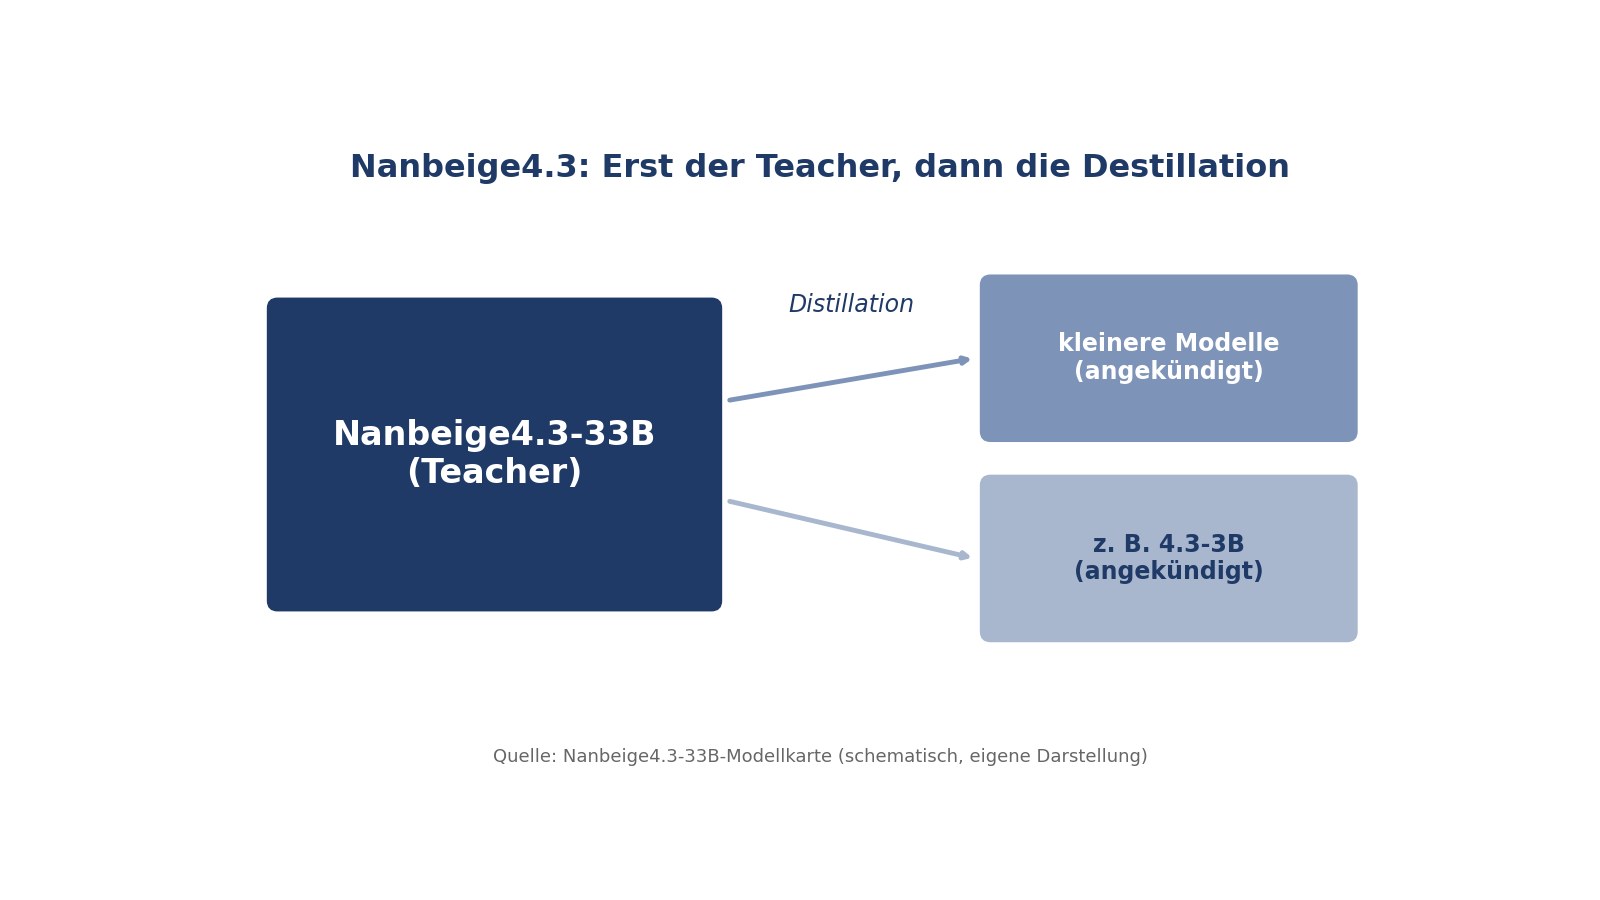
Das Nanbeige LLM Lab verfolgt mit der Nanbeige4.3-Serie eine Teacher-Strategie: Zuerst ein leistungsfähiges Lehrer-Modell bauen, dann die Agenten-Fähigkeiten in kleinere Modelle destillieren. Den Anfang macht Nanbeige4.3-33B, ein dichtes Modell mit 33 Milliarden Parametern, das auf agentisches Codieren und professionelle Cowork-Aufgaben spezialisiert ist. Das Gewichts-Repository wurde am 24. Oktober angelegt; der unabhängige Release-Tracker AIFOD listet die Veröffentlichung auf den 25. Oktober [1][2].
Die Eckdaten
| Eigenschaft | Wert |
|---|---|
| Architektur | Dichtes Llama-Modell: 52 Schichten, Hidden Size 7.168, 56 Query- und 8 Key-Value-Köpfe (GQA), Vokabular 166.912 |
| Kontextfenster | bis 524.288 Tokens (512K) |
| Positionierung | Flagship-Teacher der Nanbeige4.3-Serie; Destillation in kleinere Modelle (z. B. 4.3-3B) angekündigt |
| Schwerpunkte | Agentic Coding und professionelle Cowork-Aufgaben |
| Lizenz | Apache 2.0 |
| Betrieb | Transformers (trust_remote_code), SGLang oder vLLM; Startbeispiele mit Tensor-Parallelismus über 4 GPUs |
Was die Benchmark-Tabelle zeigt
Nanbeige vergleicht das Modell in seiner Modellkarte mit drei anderen offenen Modellen der 30B-Klasse - wichtig: Sämtliche Zahlen, auch die der Vergleichsmodelle, stammen aus Nanbeiges eigener Tabelle. Der Hersteller betont, alle Modelle mit gleichen Inferenz-Einstellungen und demselben Harness je Benchmark gemessen zu haben [1]. Für das eigene Modell meldet die Karte unter anderem: 80,9 auf Terminal-Bench 2.1 (Harness Terminus 2), 23,8 auf Terminal-Bench 4.0 (mini-swe-agent v2.4.6), 65,5 auf DeepSWE, 60,3 auf SWE-Bench Pro, 61,1 auf SkillsBench, 70,4 auf Toolathlon-Verified, 84,8 auf GDPval, 89,5 auf GPQA Diamond und 95,2 auf AIME 2026. Bei den Cowork-Benchmarks fällt YC-bench aus dem Rahmen: Dort wird kein Prozentwert, sondern ein simulierter Geschäftserlös gemeldet - 1.025.437 Dollar für Nanbeige4.3-33B [1].
Daten als Tabelle
| Nanbeige4.3-33B | |
|---|---|
| TB 2.1 | 80,9 |
| TB 4.0 | 23,8 |
| DeepSWE | 65,5 |
| SWE-B. Pro | 60,3 |
| GPQA | 89,5 |
Herstellerangaben aus der Modellkarte, nicht unabhängig verifiziert [1]. Jeder Balken ist der Score des jeweiligen Tests mit dem dort genannten Harness; die Werte sind testübergreifend nicht vergleichbar und bilden keine allgemeine Leistungsrangfolge.
Zwei Einordnungen gehören dazu. Erstens unterscheiden sich die Harness-Konfigurationen je Benchmark: Terminal-Bench 2.1 lief mit Terminus 2, Terminal-Bench 4.0 und DeepSWE mit mini-swe-agent v2.4.6, SWE-Atlas-QnA wurde zusätzlich mit einem anderen Modell als Judge bewertet. Wer die Zahlen mit Ergebnissen aus anderen Quellen vergleichen will, muss die jeweilige Konfiguration mitvergleichen - der Harness-Unterschied zwischen Terminal-Bench 2.1 und 4.0 zeigt, wie stark Setup und Version das Ergebnis prägen. Zweitens ist die Tabelle eine Hersteller-Selektion; unabhängige Messungen liegen bislang nicht vor [1].
Reasoning-Steuerung und Tool-Nutzung
Praktisch interessant ist die Chat-Vorlage: enable_thinking schaltet Reasoning für die aktuelle Antwort, preserve_thinking entscheidet, ob das Reasoning früherer Assistenten-Runden im Verlauf erhalten bleibt. Für allgemeinen Chat empfiehlt Nanbeige preserve_thinking=False, für mehrstufige Tool-Nutzung, Büro- und Code-Agenten True. Für Tool-Aufrufe empfiehlt der Hersteller das XML-Format (tool_call_format='xml'), JSON wird aus Kompatibilitätsgründen ebenfalls unterstützt. Die empfohlenen Sampling-Einstellungen unterscheiden sich je Szenario: Agenten- und Tool-Aufgaben mit Temperatur 1,0 und bis zu 65.536 neuen Tokens, Reasoning- und Chat-Aufgaben mit 0,6 und bis zu 262.144 neuen Tokens [1].
Verfügbarkeit und Einordnung
Die Gewichte stehen unter Apache 2.0 auf Hugging Face, kommerzielle Nutzung ist erlaubt; die Startbeispiele der Modellkarte für SGLang und vLLM laufen mit Tensor-Parallelismus über vier GPUs [1][2]. Die Benchmark-Führung innerhalb der eigenen Tabelle ist ein starkes Signal, aber eben nur das: Entscheidend ist die Leistung auf den eigenen Aufgaben mit dem eigenen Agenten-Setup. Wer evaluiert, sollte die Harness-Frage (Terminus, mini-swe-agent oder Claude Code) von Anfang an mitplanen.
Methode
Analyse auf Basis der Hugging-Face-Modellkarte, der rohen Modellkonfiguration (config.json, Lizenz-Metadaten per HF-API geprüft) und des unabhängigen Release-Trackers; alle Quellen wurden gelesen. Sämtliche Benchmark-Werte sind Herstellerangaben aus Nanbeiges eigener Tabelle; das Modell wurde von der Redaktion nicht selbst ausgeführt.
Grenzen
Keine eigenen Modelltests und keine unabhängige Verifikation der Benchmarks. Die Vergleichswerte anderer Modelle stammen ebenfalls aus Nanbeiges Tabelle und werden hier nicht als eigenständige Werte für diese Modelle wiedergegeben. Harness-Konfigurationen unterscheiden sich je Benchmark; ein technischer Bericht zum Training lag zum Redaktionsschluss nicht vor.
Quellen
- Nanbeige/Nanbeige4.3-33B - Modellkarte, Hugging Face / Nanbeige LLM Lab (abgerufen 2026-11-01) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- AI Model Releases - October 2026 (Live Tracker), AIFOD (abgerufen 2026-11-01) ↩1 ↩2 ↩3
- Nanbeige4.3-33B - config.json (Modellkonfiguration), Hugging Face / Nanbeige LLM Lab (abgerufen 2026-11-01) ↩1 ↩2