 KI
Fachüberblick am Abend des 5. November 2026. Quellenstand: 16:05 Uhr MEZ. Drei offene Modellveröffentlichungen dieser Tage, gelesen an den Primärquellen: Modellkarten auf Hugging Face und das Dory-Papier auf arXiv. Alle Benchmark-Werte sind Anbieterangaben ohne eigene Nachmessung.
Ling-3.1-flash: 560B, MIT laut Metadaten
inclusionAI (Ant Group) hat Ling-3.1-flash bereitgestellt (letzter Hub-Stand 3. November; bereits Oktober-Commits, daher kein daraus abgeleiteter Releasetag; auch ModelScope und OpenRouter): 560B Gesamtparameter, 25B aktiviert, hybride lineare MoE-Architektur aus 63 KDA- und 9 Gated-MLA-Schichten (7:1) plus 4 Dense-Schichten, 512 Routing-Experten (top-8) plus 1 geteilter, 64 Attention-Heads, Hidden Size 4096, Vokabular 157.184, Kontextfenster 1M Token, schaltbares Reasoning. Gegenüber Ling-3.0-flash verspricht der Anbieter bessere agentische und Office-Fähigkeiten; das begleitende Coding-Harness LingCode (auf dem offenen Agenten Pi) soll eventuell später ebenfalls offengelegt werden.
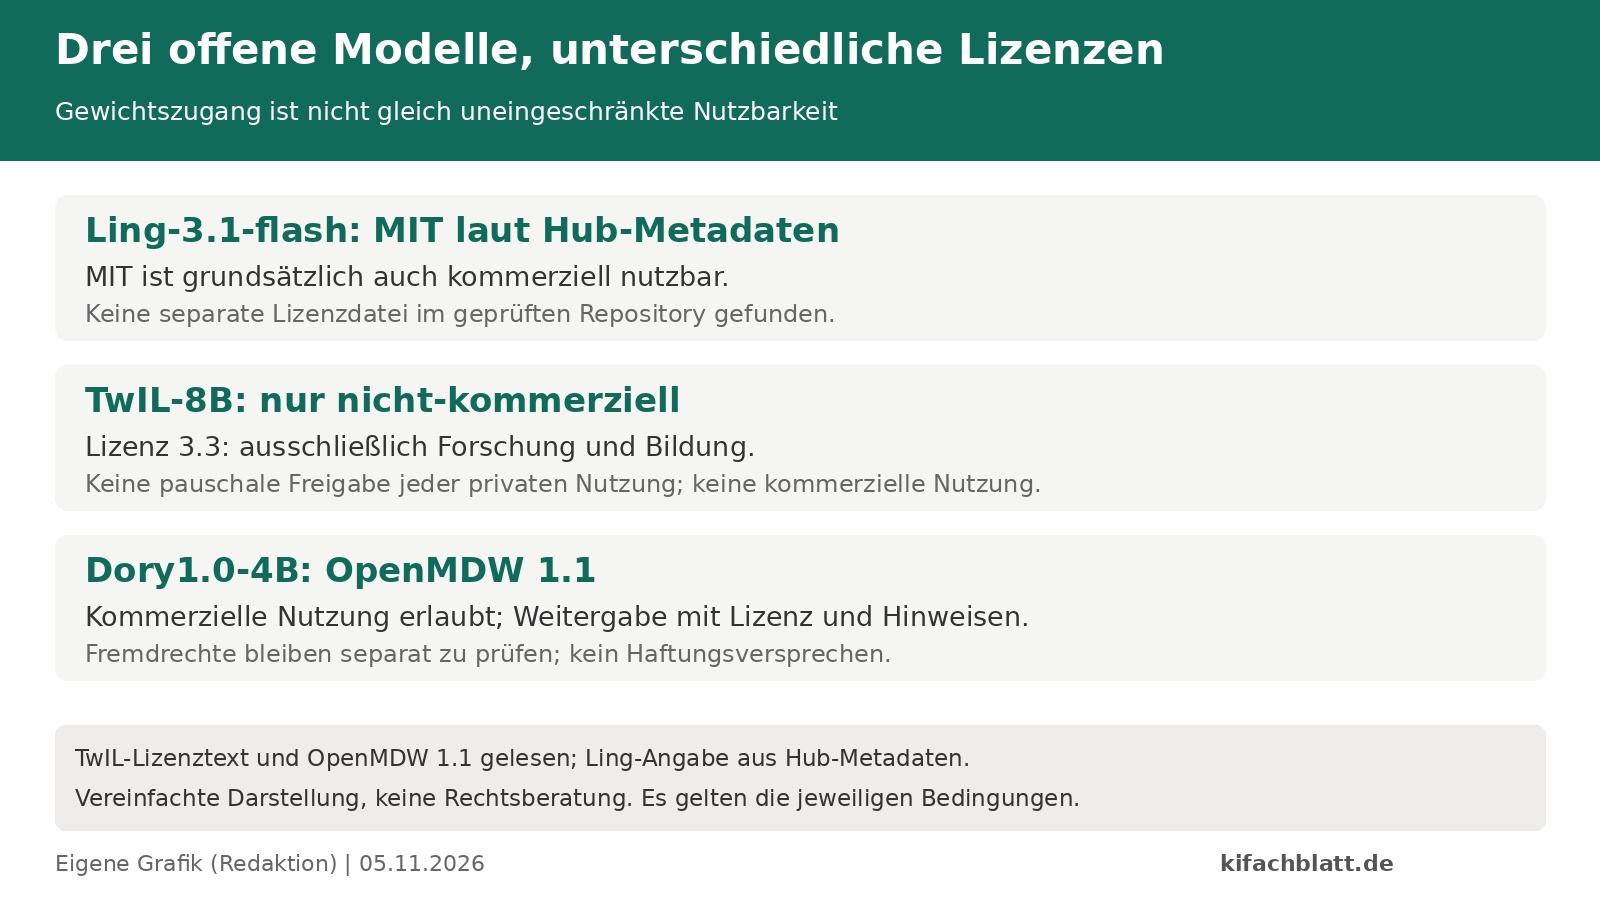
Die Karten-Benchmarks (Firmenangaben): Terminal-Bench 2.1 81,18; Terminal-Bench 4.0 46,03; DeepSWE 59,7; SWE-bench Pro 68,74; SWE-bench Multilingual 88,5; SkillsBench 68,7; HLE 37,44. Betrieb: Day-0-SGLang-Image mit NEXTN-Speculative-Decoding, Referenzsetup 8x H200 oder 4x GB300. Lizenzangabe: MIT laut Hub-Metadaten; grundsätzlich kommerziell nutzbar. Keine separate Lizenzdatei im geprüften Repository gefunden.
TwIL-8B: Contest-Stärke, ehrliche Einschränkungen
webAI hat TwIL-8B veröffentlicht (Hub-Stand 4. November): 8,79B Parameter, dichte Granite-Architektur (40 Schichten, Hidden 4096, 32/8 Attention-KV-Heads, Vokabular 100.352, 128K Kontext vom Basismodell geerbt), post-trainiert aus IBMs Granite 4.2 8B mit Full-Parameter-SFT und GRPO/DAPO-RL. Zwei Varianten: balanced (Standard, kürzere Reasoning-Spuren) und verbose (längere, für Wettkampfsaufgaben). BF16-Checkpoint 16,38 GiB pro Variante, dazu GGUF-Builds (Q4_K_M 4,98 GiB) für lokale Inferenz.
Die Karte ist bemerkenswert transparent: MATH-500 98,2 und LiveCodeBench 81,6 † sind die besten Werte der Vergleichsgruppe (Qwen3.5-9B, Gemma 4 12B/31B), bei Contest-Mathe liegt TwIL-8B auf Augenhöhe mit Qwen3.5-9B bei rund 38 Prozent weniger Ausgabetoken pro AIME-2026-Problem; bei Wissen (GPQA 70,2 vs. 81,7/84,3; MMLU-Pro 76,5; HLE 12,6) liegt es klar zurück. Caveats aus der Karte selbst: Alle mit † markierten Werte stammen von der verbose-Variante und liefen noch nicht auf balanced; Konkurrenzwerte wurden aus Fremdkarten übernommen (Stand 03.11.), nicht nachgemessen; AIME/HMMT mit 30-33 Aufgaben bedeuten rund 3 Punkte Rauschen; HLE-Scoring unterschiedlich; Dekontaminationslücken bei HMMT Nov 2025 und den Code-Suiten; kein zusätzliches Safety-/Preference-Tuning über Granite 4.2 hinaus. Lizenz: webAI Non-Commercial License 1.0, Abschnitt 3.3 - ausschließlich nichtkommerzielle Forschung und Bildung (Basismodell Apache 2.0, IBM). Alle TwIL-Werte wurden auf BF16 gemessen, nicht auf den GGUF-Dateien. Bei TwILs LiveCodeBench-Lauf fehlen laut Karte Version und Zeitfenster, daher ist der Vergleich zur v6 der Konkurrenz nicht exakt gleichgesetzt.
Dory1.0-4B: Latente Loops statt längerer Antworten
NVIDIAs Nemotron Labs haben zu Dory1.0-4B jetzt das Paper veröffentlicht (arXiv, November 2026); die Gewichte selbst liegen bereits seit dem 16. Oktober auf dem Hub. Dory ist ein gelooptes (latent-rekurrentes) normalisiertes GPT: Die Karte zählt Input/Recurrent/Output als 8/20/8. Das Paper zählt 16/40/16 physische Attention- und MLP-Schichten und erklärt 36 reine MLP-Schichten zwischen 36 Attention-Schichten. Wir geben beide Zählweisen an; der geteilte Recurrent-Block läuft k-fach, mit erneuter Input-Einspeisung je Loop. Pre-Training auf 6 Billionen Token, die ersten 4,5 Billionen in einem gemischten NVFP4-Verfahren; weitere rund 0,3 Billionen Token zur Kontexterweiterung auf 256K (rund 6,3T insgesamt); Post-Training mit SFT und RLVR plus schwierigkeitsabhängigem Loop-Curriculum. Verfügbar in BF16, MXFP8, NVFP4 und Q5_K_M-GGUF.
Kernbefund des Papiers: Elastische Inferenz aus einem Checkpoint - der Schnitt über 12 Benchmarks steigt von 35,2 (1 Loop) auf 39,7 (2) und 40,6 (4 Loops); ab zwei Loops liegt das 4B-Modell im Mittel über Qwen3.5-9B, Gemma 4 12B und Gemma 4 26B-A4B und kommt auf 1,7 Punkte an Qwen3.6-35B-A3B heran (rund neunfache Parameter); vier Loops senken die generierten Token pro Versuch auf agentischen Benchmarks um Faktor 1,3-2,5. Wenn aktiviert, hält Last-Loop-KV-Caching den Attention-Cache auf Ein-Loop-Niveau; gegenüber Per-Loop-Caching meldet das Paper bei vier Loops Änderungen von -2,12 bis +0,42 Punkten, also keinen verlustfreien Ersatz. Messungen aus NVIDIAs eigener Harness (NeMo Gym); in der Karten-Tabelle verliert Dory erwartbar bei Wissen (GPQA 72,2 bei 4 Loops vs. 80,9 für Qwen3.5-9B). Aktueller Praxisstand: vLLM-PR #60149 wurde am 25. Oktober gemergt. Daraus folgt keine Zusage für jede installierte Release-Version. Lizenz: OpenMDW 1.1. Der gelesene Text erlaubt kommerzielle Nutzung, verlangt bei Weitergabe Lizenz und Herkunftshinweise und lässt die Prüfung von Fremdrechten beim Nutzer. Der ungewichtete Mittelwert normalisiert GDPval-Elo als (Elo - 500) / 20 und ist keine einheitliche Genauigkeitsquote. Nicht jeder Einzeltest verbessert sich: GPQA und HLE fallen von zwei auf vier Loops leicht. Kürzere Ausgaben sind kein Beleg für geringere Latenz oder Energie: Das Paper schätzt bei vier Loops je nach agentischer Aufgabe 1,07- bis 2,04-fache Generierungsrechenarbeit gegenüber einem Loop.
Quellen
- inclusionAI/Ling-3.1-flash (Modellkarte), inclusionAI / Hugging Face (abgerufen 2026-11-05)
- webAI-Official/TwIL-8B (Modellkarte), webAI / Hugging Face (abgerufen 2026-11-05)
- nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 (Modellkarte), NVIDIA / Hugging Face (abgerufen 2026-11-05)
- Dory1.0-4B: A Looped Normalized-GPT (Paper, arXiv 2611.03998), NVIDIA / arXiv (abgerufen 2026-11-05)
- TwIL webAI Non-Commercial License 1.0, webAI / Hugging Face (abgerufen 2026-11-05)
- OpenMDW License 1.1, OpenMDW (abgerufen 2026-11-05)
- vLLM PR #60149: merged 25.10.2026, vLLM / GitHub (abgerufen 2026-11-05)
- Ling commit history (kein Release-Nachweis), Hugging Face (abgerufen 2026-11-05)