 KI
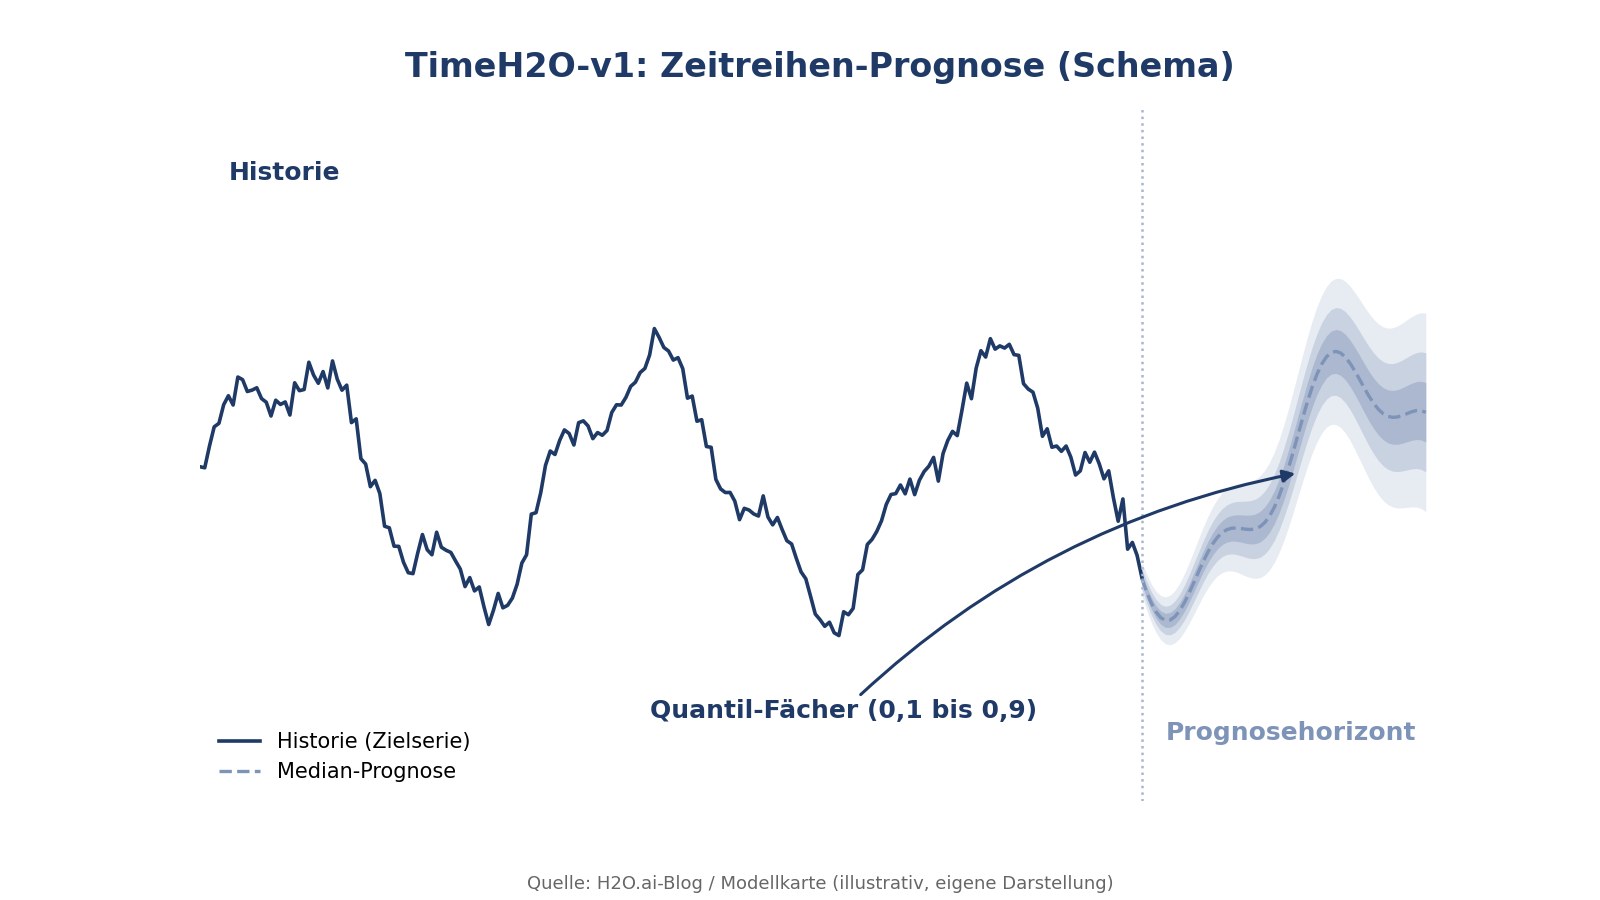
Klassische Zeitreihenprognose trainiert pro Serie ein eigenes Modell. Foundation-Modelle für Zeitreihen drehen das um: Ein einmal trainiertes Modell prognostiziert neue Serien zero-shot, also ohne jede Anpassung. Mit TimeH2O-v1 hat H2O.ai am 26. Oktober das bislang größte Modell seiner TimeH2O-Familie veröffentlicht - 108 Millionen Parameter, also Bruchteile dessen, was Sprachmodelle mitbringen [1][3]. Das kleine Schwestermodell TimeH2O-v1-tiny (5,8 Millionen Parameter) gibt es seit dem 13. Oktober [1].
Die Eckdaten
| Eigenschaft | Wert |
|---|---|
| Modelle | TimeH2O-v1 (108 Mio. Parameter, mit Kovariaten) und TimeH2O-v1-tiny (5,8 Mio., univariat) |
| Kontext / Horizont | bis 16.384 Zeitschritte / beliebig langer Prognosehorizont |
| Ausgabe | 9 Quantile (0,1 bis 0,9) plus Median als Punktprognose |
| Eingaben | Zielserie, optional Kovariaten (z. B. Preis, Wetter) |
| Lizenz | Gewichte: H2O Model Non-Commercial License; Inferenz-Code h2ofm: Apache-2.0 |
Benchmark-Ergebnisse (Herstellerangaben)
Auf fev-bench, einem Benchmark aus 100 realen Prognoseaufgaben, führt TimeH2O-v1 nach Angaben von H2O.ai die Wertung an: Platz 1 von 32 Systemen, 91,9 Prozent Gewinnrate und 50,8 Skill-Punkte, nicht-kommerzielle Modelle eingeschlossen (abgelesen am 24. Oktober 2026). Auf GIFT-Eval erreicht das Modell den niedrigsten Punktfehler (MASE 0,654) und den niedrigsten probabilistischen Fehler (CRPS 0,441) unter den Zero-Shot-Modellen [1]. Der unabhängige Release-Tracker AIFOD übernimmt die fev-bench-Einordnung mit denselben Werten [3]. Das Tiny-Modell kommt auf GIFT-Eval auf MASE 0,687 und CRPS 0,468 [1].
Daten als Tabelle
| MASE | |
|---|---|
| TimeH2O-v1 | 0,65 |
| Timestral | 0,66 |
| t0-gamma | 0,66 |
| TimesFM-3 | 0,67 |
| Chronos-2 | 0,7 |
Werte aus der Hugging-Face-Modellkarte - Herstellerangaben, Leaderboard-Stand 24.10.2026, nicht unabhängig verifiziert [2]. Die Abstände zwischen den ersten vier Modellen sind klein.
Architektur: drei Tricks
Die Basis ist ein Decoder-only-Transformer. Darauf setzt H2O drei Ideen [1]. Erstens Flip-Equivarianz: Zeitreihen haben keine Vorzugsrichtung - ein Spike ist ein umgedrehter Einbruch. Die Architektur baut diese Symmetrie ein, sodass eine gespiegelte Serie garantiert die gespiegelte Prognose liefert, statt beide Varianten mühsam lernen zu müssen. Zweitens variable Patch-Größen: Im Training wird pro Serie zufällig eine Patch-Größe (2, 4, 8 oder 16) gewählt; bei der Inferenz kommen alle Größen zum Einsatz, die in ein 1024-Token-Fenster passen - kurze Serien bekommen so mehr Tokens für Feindetails. Drittens ein Kovariaten-Adapter: Zuerst wird ein rein univariates Modell trainiert, dann eingefroren und nur die Group-Attention-Schichten plus kleine Kovariaten-Schichten auf Serien mit Begleitvariablen nachtrainiert. Das hält das Training billig und die univariaten Prognosen unverändert [1].
Training: mehr bewertete Werte pro Batch
Für die Trainingseffizienz kombiniert H2O drei Maßnahmen: eine abgewandelte Maskierungsstrategie aus dem TiRex-Paper, bei der immer auch Patches am Ende jeder Sequenz verborgen werden; Sequence Packing, das mehrere Serien in volle Trainingszeilen packt; und einen leichtgewichtigen Next-Patch-Head, der aus jedem sichtbaren Patch den nächsten vorhersagt. Zusammen steigert das die Zahl der mit Loss bewerteten Werte pro Batch laut Blog von etwa 52.000 auf 12,2 Millionen [1]. Trainiert wird mit Quantil-Loss (Pinball) über neun Quantile, gewichtet nach der Breite des eigenen Vorhersageintervalls: Werte mit unsicherer Prognose tragen weniger zum Lernsignal bei [1].
Die Trainingsdaten mischen reale Serien (unter anderem LOTSA- und GIFT-Eval-Pretrain-Korpora) mit synthetischen Serien aus einem Temporal Causal Model, das Trends, Saisonalität und Sprünge kontrolliert kombiniert. Gegen Datenlecks wurden die Zeiträume, die fev-bench, GIFT-Eval und M4 bewerten, aus dem Korpus entfernt; fehlende Werte und unregelmäßige Abtastung werden künstlich ergänzt [1][2].
Nutzung und Lizenz
Der Einstieg geht über das Python-Paket h2ofm: TimeH2O.from_pretrained lädt das Modell von Hugging Face, model.forecast liefert Median und Quantile für einen frei wählbaren Horizont [2]. Die Gewichte stehen unter der H2O Model Non-Commercial License - Forschung und Evaluierung sind abgedeckt, produktive Nutzung erfordert eine Lizenz von H2O. Der Inferenz-Code selbst ist Apache-2.0 [1][2].
Einordnung: Ein 108-Millionen-Parameter-Modell, das auf einem CPU-freundlichen Fußabdruck konkurrenzfähige Prognosen liefern soll, ist für den operativen Alltag interessanter als der nächste Milliarden-Rekord. Doch alle Leistungsangaben stammen vom Anbieter, ein Paper und das angekündigte GitHub-Repository liegen noch nicht vor ('coming soon'), und die Abstände an der Spitze von GIFT-Eval sind klein. Wer ernsthaft evaluiert, sollte die Modelle auf den eigenen Serien gegeneinander laufen lassen - dafür reicht das offene Tiny-Modell schon aus.
Methode
Analyse auf Basis des H2O.ai-Blogbeitrags, der Hugging-Face-Modellkarte und des unabhängigen Release-Trackers; alle Quellen wurden gelesen. Sämtliche Benchmark-Werte sind Herstellerangaben mit Leaderboard-Stand 24.10.2026; das Modell wurde von der Redaktion nicht selbst ausgeführt.
Grenzen
Keine eigenen Prognose-Tests und keine unabhängige Verifikation der Benchmark-Werte. Ein Paper und das GitHub-Repository sind angekündigt, lagen aber zum Redaktionsschluss noch nicht vor. Der fev-bench-Live-Leaderboard war technisch nicht direkt abrufbar; die Rangfolge stützt sich auf die Anbieterdarstellung und den Tracker.