 KI
Mittagsüberblick vom 7. November 2026. Quellenstand: 09:52 Uhr MEZ. Drei Themen: Nvidia veröffentlicht NVKE als Open-Source-Preview, ein heise-Fachbeitrag rückt die Architekturfrage bei KI-Agenten in den Mittelpunkt, und das SLA-Paper verlagert räumliches Lernen ins Vortraining von Robotermodellen.
NVKE: Managed Kubernetes für GPU-Cluster, als Preview
Nvidia hat die Nvidia Kubernetes Engine (NVKE) als Preview auf GitHub veröffentlicht, berichtet heise online. Zielgruppe sind Betreiber eigener GPU-Rechenzentren, die ihren Kunden Kubernetes als Managed Service anbieten wollen. Dem Bericht zufolge erstellt ein zentraler Management-Cluster auf Anfrage isolierte Cluster auf Bare-Metal-Servern - jeweils mit eigener Control Plane, eigenem etcd und eigenen Node-Pools; gesteuert wird über die REST-basierte NVKE-API oder das CLI nvkectl. Neue Cluster erhalten ovn-kubernetes als Netzwerk-Plug-in, Calico bleibt Bestandsinstallationen vorbehalten. GPU-Treiber, Container-Toolkit und Device-Plugin installiert separat der GPU Operator. Der Code steht unter Apache-2.0; Nvidia empfiehlt die Preview laut heise nicht für den Produktivbetrieb.
Die dokumentierten Lücken sind beachtlich: Laut NVIDIA-Dokumentation lauscht die NVKE-API nach der Installation unverschlüsselt per HTTP auf Port 30080; die Authentifizierung ist zunächst ausgeschaltet. Betreiber müssen den Zugriff absichern, etwa mit eigenem TLS-Endpunkt und aktivierter JWT-Authentifizierung. Auch danach fehlt eine Autorisierung: Jeder zugelassene Aufrufer darf alle Workload-Cluster anlegen und löschen. Hochverfügbare Control Planes setzen eine virtuelle IP per kube-vip voraus; der Management-Cluster (ungerade Serverzahl mit TPM 2.0) verwaltet sich nicht selbst, und weder ein NVKE-Upgrade-Pfad noch Backup und Restore existieren in der Preview.
Agenten-Sicherheit als Architekturfrage
In einem heise-Fachbeitrag argumentieren Mahbouba Gharbi und Sönke Magnussen (beide iSAQB-Kuratoren für KI-Architekturmodule), dass die von ihnen als kontextbasierte Verhaltensregeln definierten Guardrails allein Agenten nicht sicher machen: Das Modell interpretiere die Regeln nur, technisch erzwungen werde nichts; widersprüchliche Anweisungen und manipulierte Eingaben könnten sie aushebeln. Als backoffice-relevante OWASP-Risiken nennen die Autoren Prompt Injection, Excessive Agency, Agent Goal Hijack und Memory Poisoning. Kritische Fehler lägen in den von ihnen analysierten Projekten selten an unzureichenden Guardrails, sondern im Systemdesign.
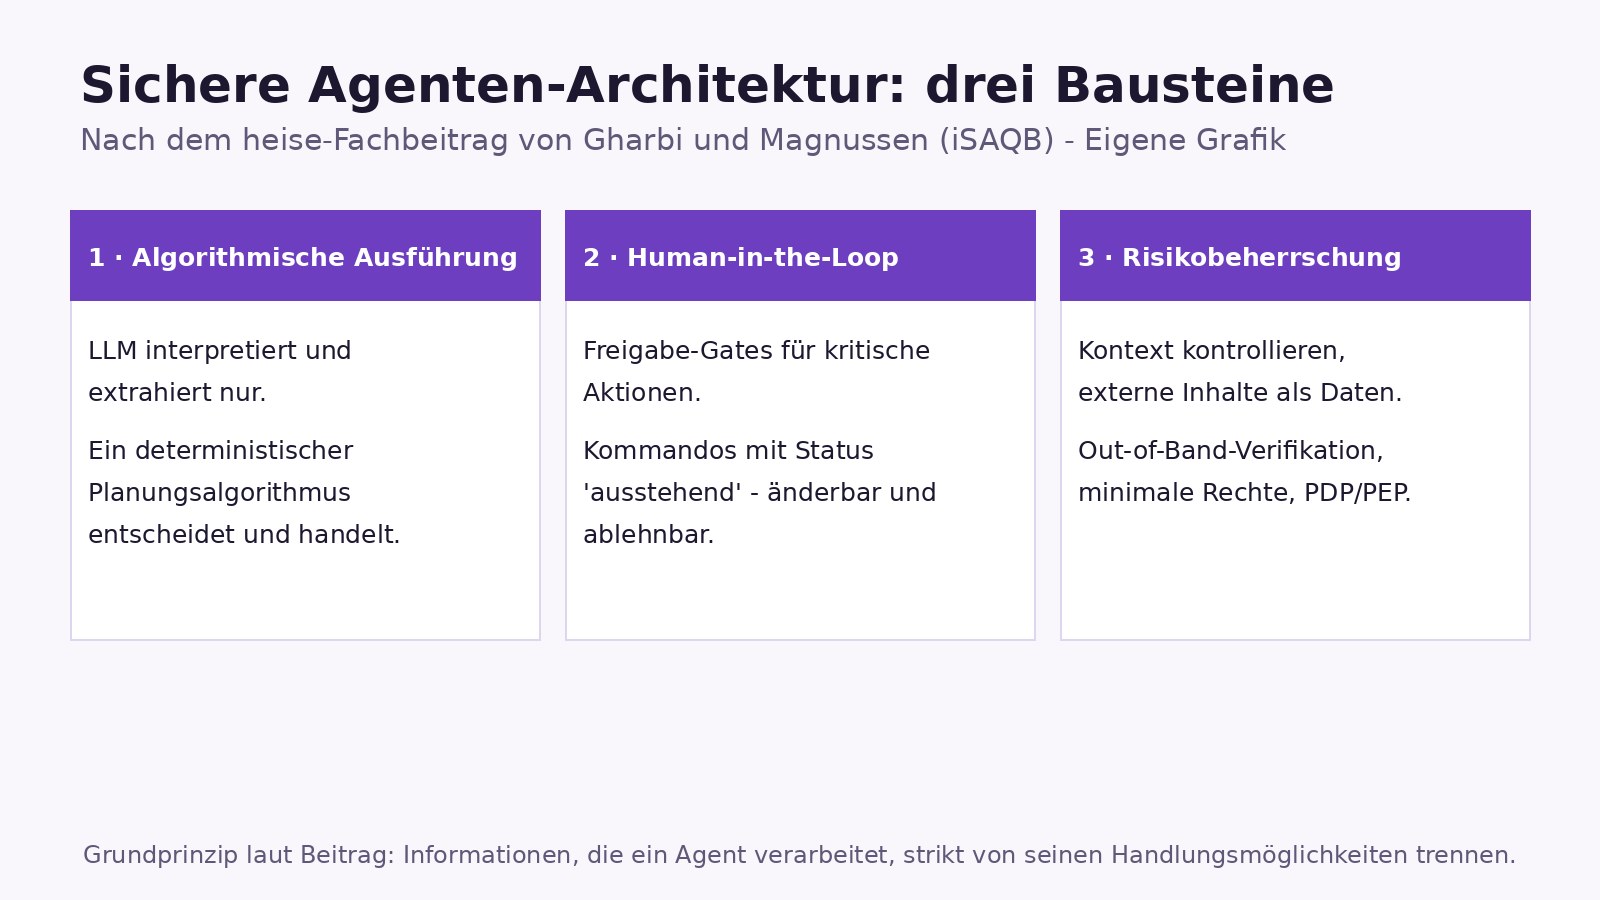
Der Beitrag schlägt drei kombinierbare Bausteine vor, die Informationen strikt von Handlungsmöglichkeiten trennen: Erstens algorithmische Ausführung - das LLM extrahiert nur Absichten und Daten, ein deterministischer Planungsalgorithmus wählt und führt Aktionen aus (Ansatz aus der symbolischen KI). Zweitens Human-in-the-Loop: Freigabe-Gates für kritische Aktionen und Kommandos mit ausstehendem Status, die autorisierte Personen ändern oder ablehnen können. Drittens Risikobeherrschung: vollständig kontrollierter Kontext, externe Inhalte konsequent als Daten behandelt, Out-of-Band-Verifikation über unabhängige Kanäle, minimale Rechte sowie Policy Decision und Enforcement Points, die Regeln technisch statt im Prompt durchsetzen.
SLA: Räumliches Alignment schon im Continual Pre-training
Das Paper 'SLA: Scaling Spatial-Language-Action Model via Continual Pre-training' (arXiv, eingereicht 5. November) verlagert räumliches Lernen in die Vortrainingsphase von Vision-Language-Action-Modellen. Ausgehend von einer vortrainierten pi0.5-Policy optimiert SLA laut Abstract Aktionsvorhersage und das Alignment visueller Zwischenrepräsentationen mit einem eingefrorenen 3D-Wahrnehmungsmodell gemeinsam; feature-abhängige Gates aggregieren dafür Embeddings mehrerer Schichten, probabilistisches State-Dropout soll Überanpassung auf Demonstrationstrajektorien dämpfen. Alle Zusatzkomponenten kommen nur im Training zum Einsatz. Die vortrainierten Gewichte dienen als Startpunkt und werden weitertrainiert; die Inferenzarchitektur bleibt laut Paper unverändert.
Die Autoren melden 87,4 Prozent Gesamterfolg auf LIBERO-Plus unter Störungen, 72,3 Prozent auf RoboTwin 2.0 (Clean2Random) und im Mittel 24,0 Prozentpunkte höhere Erfolgsraten als pi0.5 über acht reale Einsatzbedingungen. Die Werte stammen aus dem Paper und sind nicht unabhängig geprüft. Das im Recherchepaket verlinkte Repository Spatial-Forcing beschreibt das Vorgängerprojekt; einen SLA-spezifischen Code-Release haben wir dort nicht verifiziert.
Quellen
- NVKE: Nvidia bringt eigene Kubernetes Engine als Preview, heise online (iX, Kornelius Kindermann) (abgerufen 2026-11-07)
- NVKE: Preview status and known limitations, NVIDIA-Dokumentation (abgerufen 2026-11-07)
- Sichere Architektur für KI-Agenten im Backoffice, heise online (Developer, Mahbouba Gharbi, Sönke J. Magnussen) (abgerufen 2026-11-07)
- SLA: Scaling Spatial-Language-Action Model via Continual Pre-training, arXiv (Fuhao Li, Wenxuan Song u. a.) (abgerufen 2026-11-07)
- NVKE: What is NVKE, NVIDIA, dsx-ai-factory (GitHub) (abgerufen 2026-11-07)