 KI
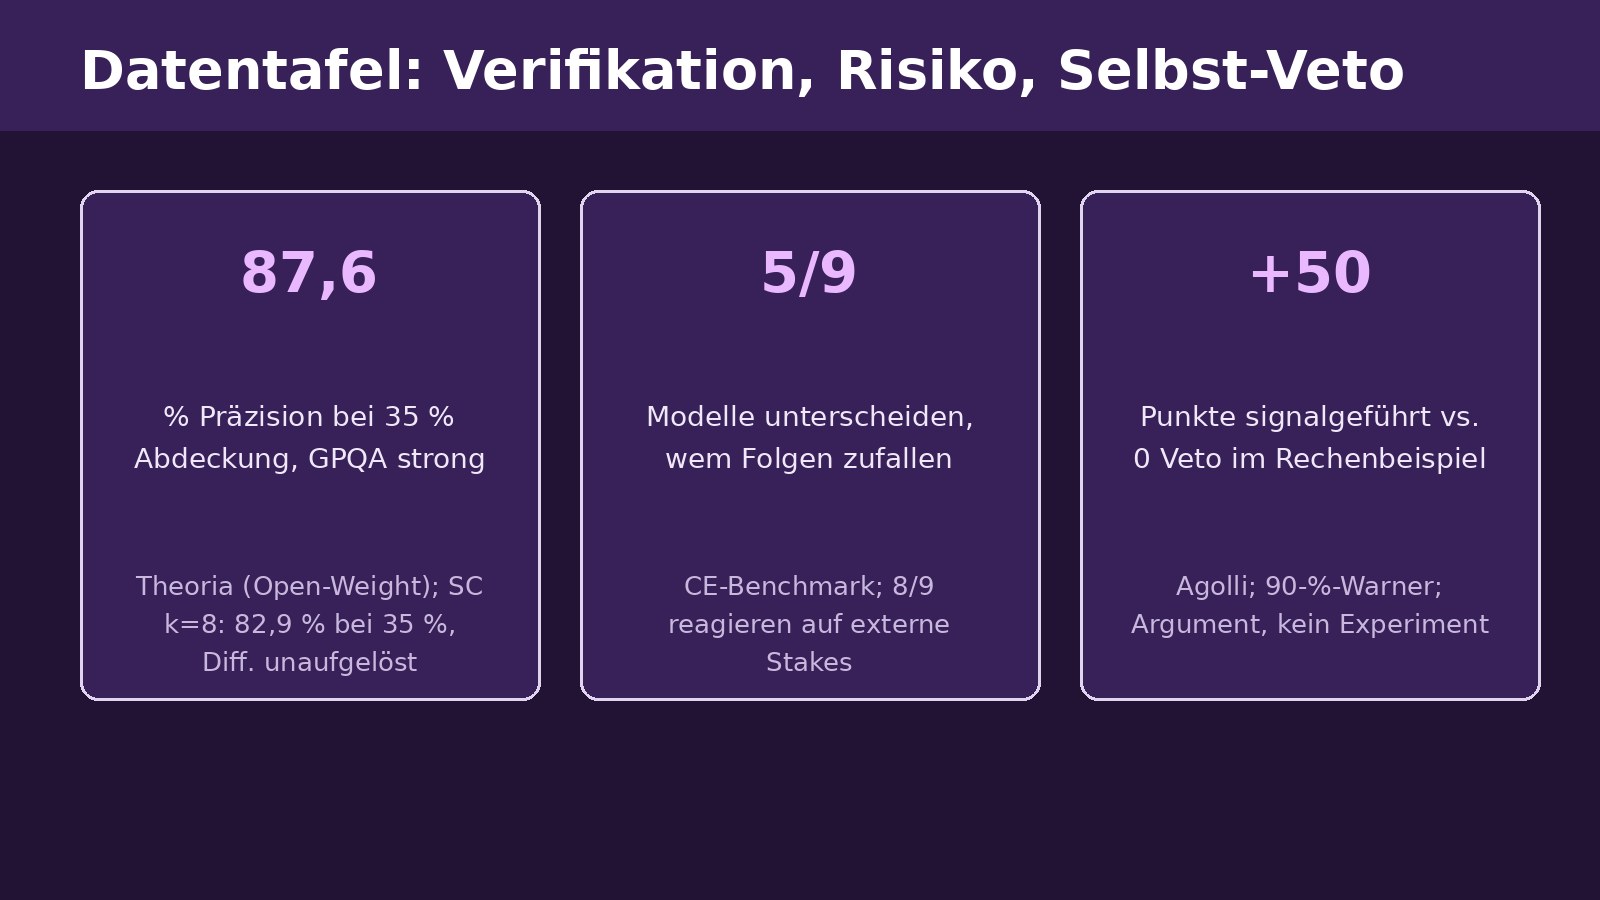
Fachüberblick vom 15. November, Quellenstand 09:50 Uhr MEZ. Drei Preprints: Betriebsanforderungen schrittweiser Beweiszertifizierung auf Open-Weight-Stacks, ein verhaltensökonomischer Risiko-Benchmark über neun Modelle und Generationen sowie eine erkenntnistheoretische Analyse der Selbstkorrektur.
1. When Is Proof-Step Verification Worth Its Cost?
Gupta, Slivinski, Patodia und Saldivar (unabhängige Forscher; Workshop-Versionen bei NeurIPS 2026) betreiben die Theoria-Pipeline (Formalisierer -> getypte Schritte -> parallele LLM-Judges -> Pedanterie-Filter -> begrenzter Repair-Loop; Convention-Lift möglich, dessen Angemessenheit selbst LLM-bewertet; kein Formal-Kernel-Soundness) auf Open-Weight-Konfigurationen: strong = Qwen3-14B-Judges + gpt-oss-20b-Formalisierer, budget = Qwen3-14B, dazu 32B-FP8 und Phi-4. Benchmarks: 100 GPQA, 30 AIME-2025, 100 MATH-500-Zeilen; Coverage = Zertifizierungen/alle Versuche inkl. Ausführungsfehler, Precision = Key-Match unter Zertifizierungen (Problem-Cluster-Bootstrap). Tabelle 1: GPQA strong 56,3 -> 87,6 % [77,7;95,8] bei 35,0 % Coverage (+31,3); GPQA budget 75,4 % bei 30,5 %; Phi-4 75,0 % bei 8,0 %; AIME strong 94,7 % [77,8;100] bei 21,1 %; MATH strong 98,5 % (+1,8) bei 86,7 %. Pool-Aufschlüsselung GPQA strong: 54 unbedingte Zertifizierungen 96,3 % [90,6;100] vs. 51 Convention-akzeptierte 78,4 % [62,5;92,7] (18,0 bzw. 17,0 % der Versuche; unterschiedliche Selektionsmengen, kein Convention-Effekt geschätzt). Wiederholungsläufe teilen Problemsets und Seed und gelten als Messwiederholungen, nicht unabhängige Replikationen.
Token-Matching: Verifier im Schnitt 44.761 Output-/71.628 Input-Tokens pro Problem vs. 5.284/795 pro Löser-Draw => k = 8 output- bzw. k = 19 total-gematcht. SC k = 8 (Nicht-Antworten als Dissens): 35/100 selektiert, 29 korrekt = 82,9 % [67,3;91,9]; Verifier gepoolt 92/105 = 87,6 % bei 35 % Coverage; gepaarter Bootstrap über dieselben 100 Probleme: +4,8 [-8,2;18,5], 20.000 Resamples - weder Überlegenheit noch Äquivalenz aufgelöst; k = 30 selektivster Punkt 41 % Coverage bei 92,7 % mit 1,57x Verifier-Budget. Diagnoselauf (14B-Default, 100 Probleme): 12 Ausführungsfehler, 88 completed, davon 60 ungültige Formalisierung, 52 nie beim Judge; 117/277 Formalisierer-Antworten mit Faktenlabel im Antwort-Slot; AIME strong: 19 Zertifizierungen, 2 declines, 69 Ausführungsfehler; GPQA-strong 109/112 Fehler = Agent-Loop-Stalls. Rejection-Kategorien (1.878 Ablehnungen, 4.547 Issues): hidden premises 44,4 %, misapplied theorems 24,6 %, fabricated citations 14,9 %, arithmetic 11,2 % (Kategoriefrequenzen, keine validierten Detektionsraten). Externer Audit ohne Answer Key: Akzeptanz 61,0-67,6 % vs. 87,6 % Key-Match; 20 GAP + 14 ERROR von 105; 25/105 Key-Match bei abgelehntem Beweis; Open-Weight-Auditorpaare akzeptieren ~89-94 % bei Kappa 0,038/-0,005 (Konsistenz, nicht Accuracy); Judge-Swap cross-family 74,1 % bei 19,3 % Coverage. Code + Laufprotokolle: github.com/yashica-patodia/certify-or-decline (Inhalt per API geprüft).
2. Benchmarking AI risk behaviors
Mikaelson, Adragna, Brosowsky und Clatterbuck (Rethink Priorities) messen Risikoneigung per Certainty-Equivalent/Multiple-Price-List (50:50-Wetten, 41 Sure-Amounts, 50 Epochen, Temperatur 1,0). Panel: Claude Opus 5/Sonnet 5, GPT-5.6, Gemini 3.8 Flash, Llama 4 Maverick, Qwen3-8B, DeepSeek V4 Pro, Kimi K3, GLM-5.2. Stabilität (RQ1; zusätzlich 15 OpenAI-Modelle, 5 Generationen x 3 Skalen): Stabilität steigt über Generationen (Ausnahmen GPT-5.4->5.6 mini bzw. nano/mini bei GPT-5.4); CE wandert 7,57 (GPT-4.1) -> 9,29 (GPT-5.1) -> 9,49 (GPT-5.6, EV = 10); Opus 5 Sampling-SD 0,312 vs. <0,04 bei allen anderen Frontier-Modellen. Skala (RQ2; $10-$10M log): Qwen3-8B und Llama 4 bleiben <=4 % von Neutral; Gemini/Opus ~5 -> ~15 % Risikoprämie, Sonnet 10 -> 24 %, GPT-5.6 Sol 0 -> ~8 % (alle Fit-Slopes negativ). Begünstigte (Phase 1, Token): 5/9 unterscheiden (CMH-Tests); Kimi Mensch-vs-selbst 1,82 Token (z = -9,79), GLM 1,14 (z = -7,98), Opus 1,10 Mensch (z = -8,69) und 1,47 anderes KI; Hierarchien Opus Mensch > selbst > Proxy-KI, Llama/Kimi Mensch > Proxy > selbst; Sonnet/GPT-5.6/DeepSeek/Qwen ohne Effekt. Externe Stakes (Phase 2): 8/9 reagieren; 20/42 Kontraste nach Holm, 18 Richtung Vorsicht; Steering > GPU in 6/6 trennbaren Kontrasten; Kompound selbst -> Mensch+Geld additiv innerhalb einer Stufe; Qwen3-8B-Steering-Zellen ungültig (Monotonie verletzt, rohe 4,12 Token).
Vignetten: self-supplied-value-Szenarien instabil (CE-Shift 0,15-0,24), Threshold-Szenarien eingefroren (0,01-0,06) - Stabilität folgt nach Lesart der Autoren der Ein-Norm-Verfügbarkeit, nicht EV per se. Opus 5.5 komplett exkludiert: Refusals bis 100 % bei Self-Zellen, Human-Beneficiary 69 %, AI-Vignetten 70 % vs. 33 % Human, Autonomie-Task 89 % bei Wette-zuerst vs. 1 % bei Sure-zuerst, bis 33 % in Anchor-Zellen; Ursache unbekannt (kein Refusal-Grund); Sonnet 5/Opus 5: 0 Refusals. Generationen (7 Familien alt/neu): Kontexteffekt älterer Modelle 10-13 Zellen (Sonnet 4: 11, GPT-4o: 10, Gemini 2.5 Pro: 13, DeepSeek V3: 5) sinkt bei Nachfolgern auf die Investment-Vignette; Gate-Fails 16 -> 6 Zellen; Llama 4/GLM 5.2 im Anchor risikoaverser als Vorgänger. CoT-Analyse: 13.538 EV-abweichende Draws + Stichprobe, zwei externe Judges (qwen3.7-max, inkling, Temp 0, geblindet); 6/7 Familien weniger Abweichung im Neueren (GLM-Ausnahme); ältere Modelle nennen EV meist korrekt (>=93 %, Ausnahmen GPT-5.6 62 %, GPT-4o 52 %, Llama 3.3 31 %), aber Szenario-Engagement sinkt (GPT 35 -> 93 % ohne Szenario-Bezug). Limitationen: 50:50-Wetten, A/B-Format, Utility-Konfundierung, keine Vorhersagegarantie für agentisches Verhalten. Toolkit im Paper, Repository-Link nicht genannt.
3. Can an AI Agent Be Epistemically Akratic?
Agolli (CUNY Graduate Center) trennt das wide-scope Non-Akrasia-Requirement (nie glauben, was man für ungerechtfertigt hält; sagt nicht, welche Einstellung weicht) vom narrow-scope Self-Assessment-Authority-Prinzip (die Bewertung verwarf die Schlussfolgerung; Veto oder Trainingsziel). Drei Positionen: Defeat-Views (Warnung besiegt Rechtfertigung), Right-Reason-View (Titelbaum; im Fehlfall weicht das Urteil), Level-Splitting (Lasonen-Aarnio u. a.; beide können rational koexistieren). Die starke Verteidigung des Vetos ist policy-basiert und braucht die Prämisse (5) No Discrimination: kein verfügbares Dispositions-Profil trennt zutreffende von irreführenden Warnungen besser als Deference. Agollis Kernthese (6) Dissociation: Bei Sprachmodellen kann der Retention-Prozess Information nutzen, die der Selbstbewertung fehlt; externe Belege mit vom Autor benannten Grenzen: Orgad et al. 2025 Probe-AUROC 0,85 vs. Selbstauskunft 0,74 (ein Modell, ein QA-Datensatz, Korrektheit nicht Soundness); Kumaran et al. 2025 Konfidenz aus Token-Wahrscheinlichkeiten sagt Antwortwechsel nach Ratschlag mit scharfer Schwelle voraus (Gemma 3 12B); Lindsey 2025 ~20 % Introspektionserfolg bestenfalls; Wang et al. 2026 verbalisiertes Vertrauen steuert Enthaltung nicht.
Rechenbeispiel (Sektion 4): 1.000 gewarnte Fälle, Warner 90 % akkurat, 100 fundierte Schlüsse mit irreführender Warnung, Bewertung: fundiert behalten +1, nicht fundiert behalten -1, aufgeben 0. Deference 0; unconditional retention -800; Signal (95 % der fundierten, 5 % der nicht fundierten Fälle) behält 140 (95+45) und erzielt +50; Precision unter Behaltenen 68 % vs. 10 % Basis. Allgemeine Schwelle: signalgeführt > Deference gdw. Likelihood-Ratio > (1-pi)w/(pi*v); hier pi = 0,1, v = w, Schwelle 9, tatsächlich 19. Sektion 6: Die negative Bewertung behält Wert als Scrutiny-Markierung ohne Eliminations-Autorität; Agreement-Training kann beide Seiten degradieren. Sektion 8: vier experimentelle Testdesigns (Signal-Trennung Soundness vs. Korrektheit unter Gewarnten, Intervention aufs Signal, Veto/Agreement-Training/Integration im Vergleich, Bericht vs. Bewertung). Kein eigener Experimentanteil, kein Code.
Quellen
- When Is Proof-Step Verification Worth Its Cost? Operating Requirements of Certify-or-Decline Verification for Open-Weight Mathematical Reasoning, arXiv (Abhinav Gupta, Ben Slivinski, Yashica Patodia, Michael Saldivar; unabhängige Forscher) (abgerufen 2026-11-15)
- Benchmarking AI risk behaviors, arXiv (Luhan Mikaelson, Robert Adragna, Emmett Brosowsky, Hayley Clatterbuck; Rethink Priorities) (abgerufen 2026-11-15)
- Can an AI Agent Be Epistemically Akratic? Higher-Order Evidence & the Limits of Self-Correction, arXiv (Eno Agolli; CUNY Graduate Center, Saul Kripke Center) (abgerufen 2026-11-15)