 KI
Morgenüberblick vom 3. November 2026. Quellenstand: 06:37 Uhr MEZ. Drei Meldungen zum Wochenstart: Eine offene Computer-Use-Familie bis 397 Milliarden Parameter erscheint unter Apache-2.0, OpenAI legt einen Eval für Alltagsaufgaben vor, und Flower Labs verbindet Frontier-Anspruch mit EU-Inferenz und Ausgaben-Eigentum.
NorthCUA: offene Computer-Use-Familie bis 397B
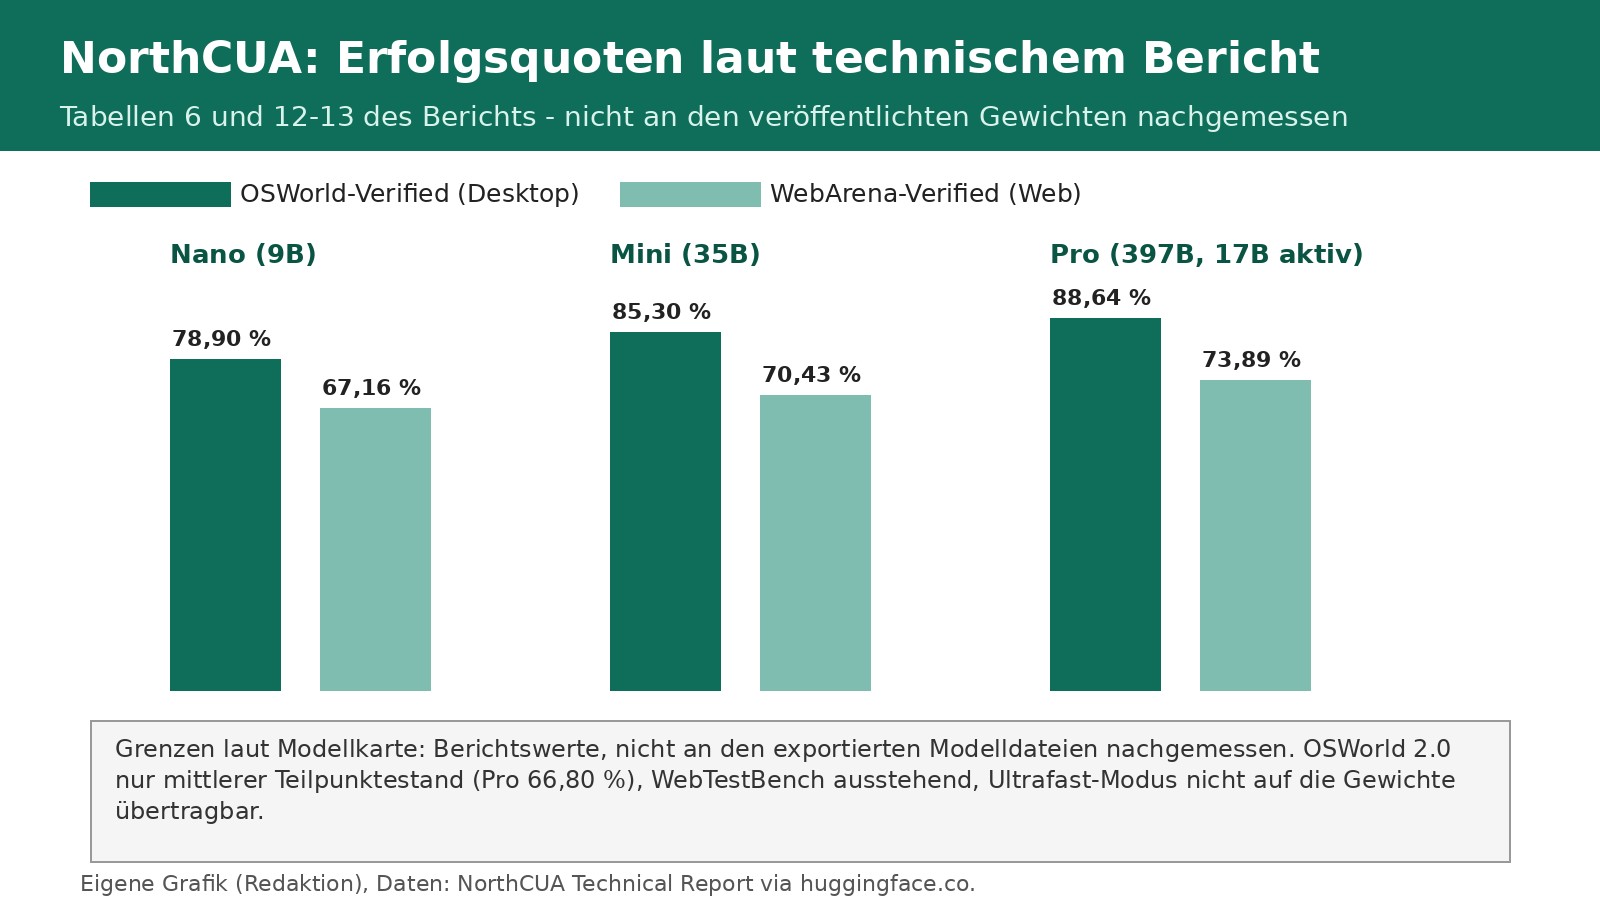
NorthCUA umfasst drei Größen - Nano (9B), Mini (35B) und Pro (397B total, 17B aktiv pro Token, MoE) - aufgebaut auf Qwen3.5 und unter Apache-2.0 veröffentlicht (Hugging Face, Organisation inzwischen china-beipo). Laut Modellkarte meldet der 121-seitige technische Bericht ("Turbocharging Computer-Use Agents through Experience at Scale") meldet nach dem Reinforcement-Learning-Training Erfolgsquoten auf OSWorld-Verified von 78,90 (Nano), 85,30 (Mini) und 88,64 Prozent (Pro) sowie auf WebArena-Verified von 67,16, 70,43 und 73,89 Prozent. Das Protokoll: 361 OSWorld-Aufgaben (ohne acht Google-Drive-Aufgaben) und 812 WebArena-Aufgaben mit 100-Schritt-Limit; das Grounding-Ergebnis OSWorld-G (SFT, 564 verfeinerte Anweisungen, best-of-3 statt Mittelwert) liegt bei 82,98, 87,94 und 90,96 Prozent.
Bemerkenswert ist die Transparenz der Modellkarte: Sie betont ausdrücklich, dass die Berichtswerte nicht an den exportierten Modelldateien nachgemessen wurden; für OSWorld 2.0 (108 Aufgaben, 500-Schritt-Limit) liegt nur ein mittlerer Teilpunktestand von 66,80 Prozent für Pro vor, keine volle Abschlussquote; WebTestBench-Ergebnisse sind als ausstehend markiert; und der erforschte Ultrafast-Modus (direkte Aktionsauswahl) ist nicht auf die veröffentlichten Gewichte übertragbar. Die sekundär verbreitete Behauptung, Pro schlage geschlossene Billionen-Parameter-Modelle, ist an der Karte nicht belegt.
LifeVal: OpenAIs Eval für den Alltag
OpenAI hat am 2. November LifeVal veröffentlicht: ein Eval für Alltagsaufgaben, aufgebaut auf der American Time Use Survey, der Multinational Time Use Study und einer eigenen demografisch repräsentativen Umfrage unter 3.995 Teilnehmenden. Die Aufgabenbereiche: Betreuung, Gesundheit, Bildung, Haushaltsverwaltung, persönliche Finanzen, Einkaufen und Behördengänge. Gezeigt werden fünf Beispielaufgaben mit Ergebnisquoten der aktuellen Modelle zwischen 90,4 und 100 Prozent. OpenAI gibt an, den Eval seit einem Jahr intern zur Modellverbesserung zu nutzen, mit Fokus auf Browser-Nutzung, Computer-Nutzung und Connectoren.
Einordnung: Alle Werte sind Anbieterangaben ohne Fremdprüfung; OpenAI zeigt eine Auswahl und veröffentlicht weder Gesamtscore noch Modellvergleich. Ein in einem News-Digest kursierender Gesamtwert von 80 Prozent für ein künftiges Modell ließ sich an der Primärquelle nicht bestätigen.
Endeavor 1.1: Frontier-Anspruch mit EU-Option
Flower Labs meldet für Endeavor 1.1 einen Spitzenwert von 97,18 in einem selbst definierten "Intelligence Composite" (gleich gewichtet: GPQA, AIME 2026, HumanEval, IFEval), vor GPT-5.6 Sol (96,25), Claude Fable 5 (95,30), Kimi K3 (94,83) und Nemotron 3 Ultra (92,28). Gegenüber Endeavor 1.0 steigt GPQA von 92,0 auf 94,4 (laut Flower rund 30 Prozent weniger Fehler) und HumanEval von 98,2 auf 99,9; MMMU-Pro wird separat mit 81,12 angegeben. Alle Werte sind Anbieterangaben aus dem eigenen Blog, ohne unabhängige Prüfung.
Jenseits der Benchmarks: Inferenz wahlweise auf GPUs in der EU mit SLAs und Support (weitere Regionen wie Großbritannien, Naher Osten, Asien und Afrika angekündigt), Multimodalität durch Bildeingaben, einsehbare Denkspuren sowie das Recht, alle Ausgaben und Spuren zu behalten und eigene Modelle darauf zu trainieren. Flowers Vergleich, OpenAI zeige nur Zusammenfassungen und Anthropic halte Rohspuren meist zurück, ist Anbieterdarstellung.
Quellen
- NorthCUA-Pro (Modellkarte), Hugging Face (beipo-ai) (abgerufen 2026-11-03)
- NorthCUA: Open 397B Computer-Use Model (Alert), AI Weekly (abgerufen 2026-11-03)
- Introducing LifeVal, OpenAI (abgerufen 2026-11-03)
- OpenAI LifeVal: Everyday tasks as a personal assistant benchmark, neuralbrew (abgerufen 2026-11-03)
- Introducing Endeavor 1.1, Flower Labs (abgerufen 2026-11-03)