 KI
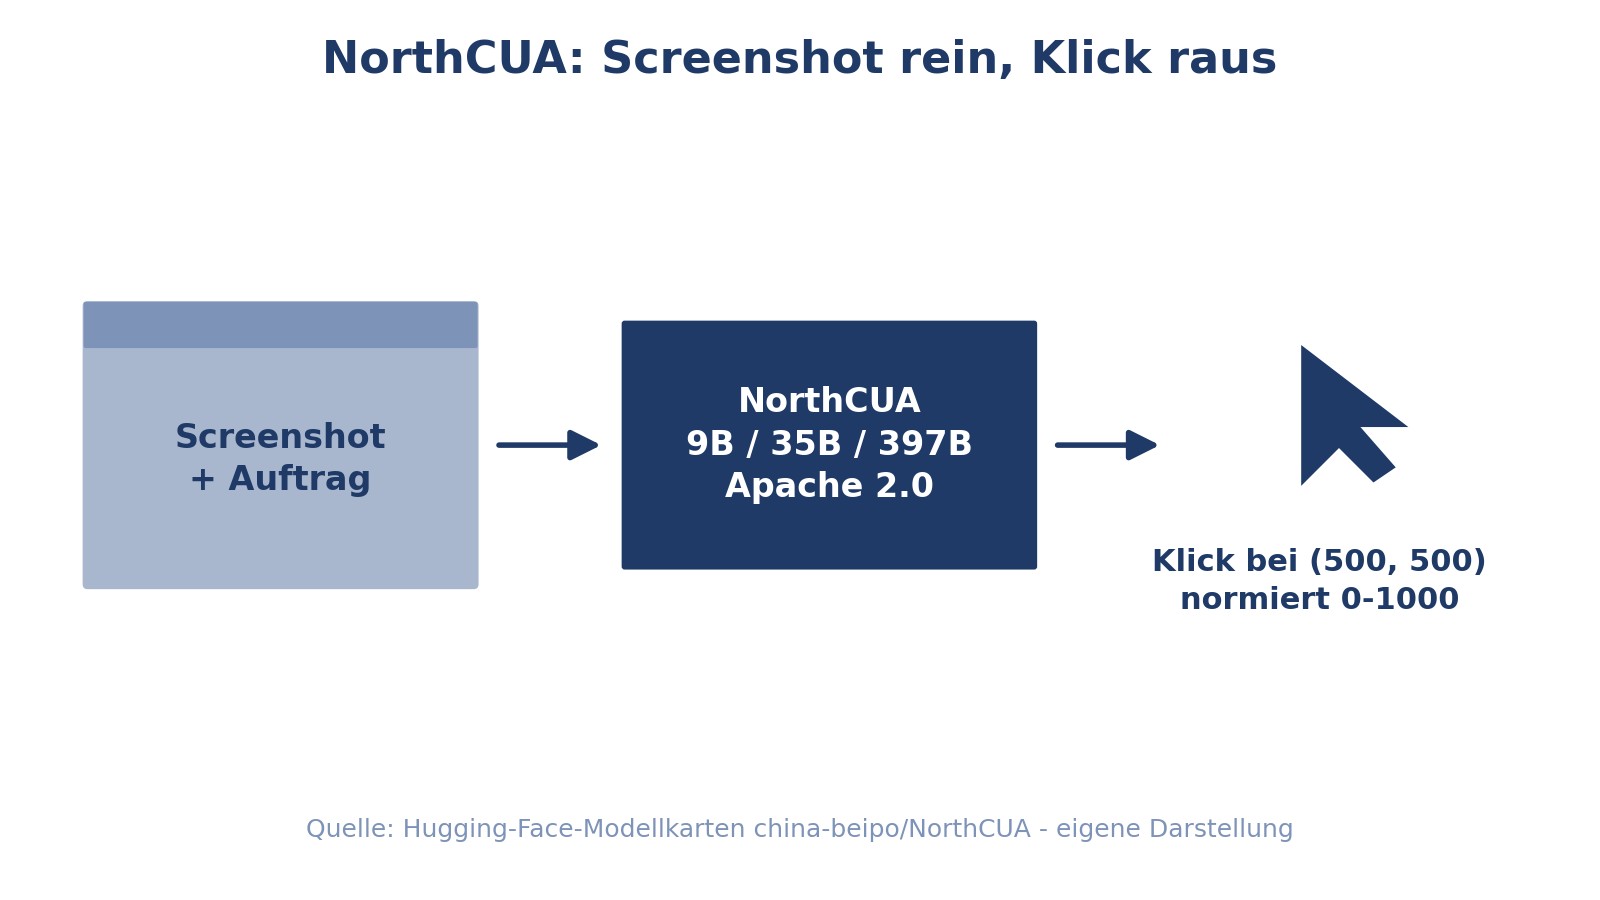
Computer-Use-Modelle steuern Rechner so, wie Menschen es tun: Sie sehen Screenshots und erzeugen Klicks, Tastatureingaben und Tool-Aufrufe. Bisher kamen die stärksten dieser Modelle fast ausschließlich hinter APIs. NorthCUA legt eine offene Gegenposition vor: drei Modellgrößen auf Qwen3.5-Basis, veröffentlicht unter Apache 2.0, dazu ein 121-seitiger technischer Bericht. Die Gewichts-Repositories stehen seit dem 30. Oktober (Pro) beziehungsweise 1. November (Nano und Mini) auf Hugging Face; die Organisation firmiert inzwischen als china-beipo [1][2][3].
Die Eckdaten
| Eigenschaft | Wert |
|---|---|
| Modelle | Nano: 9B dicht (32 Schichten, ca. 18,84 GB); Mini: 35B MoE mit 3B aktiv (40 Schichten, ca. 70,23 GB); Pro: 397B MoE mit 17B aktiv (60 Schichten, ca. 793,63 GB) |
| Basis / Export | Qwen3.5 (Pro: Qwen3.5-397B-A17B); Safetensors BF16, Pro in 122 Shards; Release r13, Checkpoint 975; ohne MTP-Gewichte |
| Kontext | 262.144 Tokens konfiguriert - laut Karte keine Qualitätsgarantie bei dieser Länge |
| Ein-/Ausgabe | Anfragen, Screenshots und Interaktionshistorie hinein; Reasoning, Antworten und Tool-Aufrufe heraus |
| Betrieb | Offizielles NorthCUA Harness erforderlich; Koordinaten strikt normalized_1000 (0-1000), Umrechnung in Pixel erst bei der Ausführung |
| Lizenz | Apache 2.0 für Gewichte und Dokumentation, mit NOTICE-Attribution |
Die gemeldeten Messwerte
Laut Modellkarte meldet der technische Bericht nach dem Reinforcement-Learning-Training Erfolgsquoten von 88,64 Prozent (Pro), 85,30 (Mini) und 78,90 (Nano) auf OSWorld-Verified - 361 Aufgaben, acht Google-Drive-Aufgaben ausgenommen, 100-Schritte-Limit. Auf WebArena-Verified (812 Aufgaben, offizielle Ergebnisprüfungen) liegen die Werte bei 73,89, 70,43 und 67,16 Prozent. Grounding-Messungen liefen auf SFT-Checkpoints: 93,30 Prozent (Pro) auf ScreenSpot-Pro und 90,96 auf OSWorld-G. Der Sprung vom SFT- zum RL-Checkpoint ist moderat (Pro auf OSWorld: 85,87 auf 88,64) [1].
Daten als Tabelle
| Erfolgsquote OSWorld-Verified in % (RL) | |
|---|---|
| Nano 9B | 78,9 |
| Mini 35B | 85,3 |
| Pro 397B | 88,64 |
Herstellerangaben aus der Modellkarte, die den technischen Bericht zitiert [1]. Erfolgsquote in Prozent auf OSWorld-Verified (361 Aufgaben, 100-Schritte-Limit), nicht von uns nachgemessen; die Karte betont selbst, dass die Werte nicht am exportierten Checkpoint verifiziert sind.
Was die Karte selbst einräumt
Das Bemerkenswerteste an dieser Veröffentlichung ist ihre Ehrlichkeit. Die Karte sagt ausdrücklich: Die Berichtswerte stammen aus Forschungs-Checkpoints und wurden nicht an den exportierten Modelldateien nachgemessen. Für OSWorld 2.0 (108 Aufgaben, 500-Schritte-Limit) liegt nur eine mittlere Teilpunkte-Quote von 66,80 Prozent für Pro vor, keine Abschlussquote; Nano und Mini fehlen dort ganz. Die WebTestBench-Tabelle markiert NorthCUA als ausstehend - kein Wert wird behauptet. Der Bericht dokumentiert zudem ein Grounding-Beispiel, bei dem ein Bedienelement im Training vorkam und in verändertem Zustand wiedererkannt wurde; die Werte seien daher nicht als Beweis zu lesen, dass jedes geprüfte Element ungesehen war. Der Bericht selbst ist öffentlich nicht verlinkt; dokumentierende Quelle ist die Modellkarte. Auch der erwähnte Ultrafast-Modus gilt nicht als auf die veröffentlichten Gewichte übertragbar [1].
Training laut Modellkarte
Drei Stufen: ein breites GUI-Midtraining mit mehr als 100.000 Trajektorien und 4 Millionen Interaktionsschritten (plus rund 40.000 Grounding-Beispiele), dann verifiziertes Long-Horizon-SFT mit etwa 3.000 geprüften Trajektorien (310.000 GUI-Schritte), schließlich gemeinsames Desktop-Web-RL (GRPO) aus einem Pool von rund 1.500 Desktop- und 500 Web-Aufgaben. Die Karte kennzeichnet diese Zahlen als gerundete Korpus-Angaben, nicht als Verbrauch pro Modell [1].
Einordnung
Eine Apache-2.0-Familie bis 397B für Computer Use ist ein Angebot an Forschung und an Teams, die Agenten selbst hosten wollen. Praktisch bleibt der Einstieg anspruchsvoll: Der Pro-Export belegt rund 794 GB, und Modell wie Harness bilden eine Einheit - wer ein anderes Agenten-Interface anschließt, bricht den Koordinatenvertrag. Die Verbreitung ist gering (Pro: 361 Downloads im letzten Monat, Nano und Mini jeweils 0). Dennoch setzt die Karte einen Standard, den man sich öfter wünschen würde: Sie trennt Berichtswerte von Export-Werten, markiert Lücken und benennt Kontaminationsrisiken selbst [1][2][3].
Methode
Analyse auf Basis der drei Hugging-Face-Modellkarten (Pro, Mini, Nano), jeweils vollständig gelesen; Erstellungs- und Änderungsdaten der Repositories über die Hugging-Face-API geprüft. Alle Benchmark-Werte sind Herstellerangaben aus den Karten, die ihrerseits den 121-seitigen technischen Bericht zitieren.
Grenzen
Keine eigenen Agenten- oder Grounding-Tests. Der technische Bericht ist öffentlich nicht verlinkt; wir geben nur Werte wieder, die die Modellkarte aus ihm zitiert. Der offizielle NorthCUA-Harness-Code wurde nicht geprüft. Uns ist keine unabhängige Fremdmessung der Erfolgsquoten bekannt.
Quellen
- china-beipo/NorthCUA-Pro - Modellkarte, Hugging Face / NorthCUA Team (abgerufen 2026-11-03) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- china-beipo/NorthCUA-Mini - Modellkarte, Hugging Face / NorthCUA Team (abgerufen 2026-11-03) ↩1 ↩2 ↩3 ↩4
- china-beipo/NorthCUA-Nano - Modellkarte, Hugging Face / NorthCUA Team (abgerufen 2026-11-03) ↩1 ↩2 ↩3 ↩4