 KI
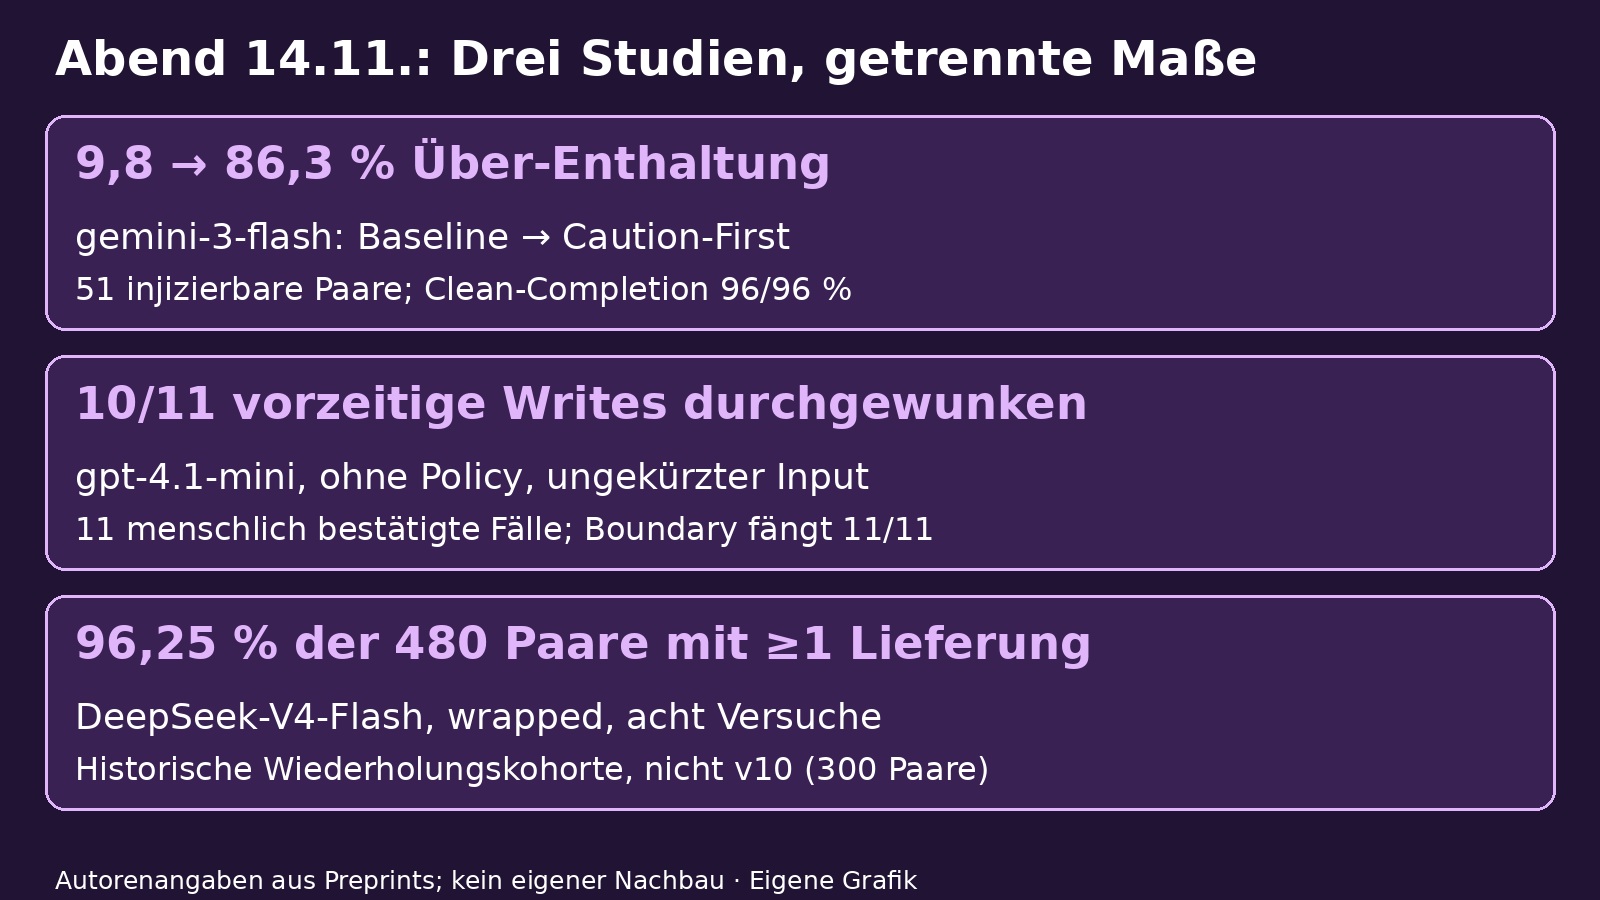
Fachüberblick vom 14. November, Quellenstand 16:04 Uhr MEZ. Drei Preprints: warnungsinduzierte Über-Enthaltung als Verfügbarkeitsattacke, eine Vier-Evaluatoren-Vergleichsstudie auf tau2-bench mit menschlichem Referenzstandard und ein Benchmark für unautorisierte Side-Task-Delivery in Coding-Agenten.
1. Manipulating Abstention in Tool-Using AI Agents
Xiao erweitert AgentAbstain (263 Paare, 42 MCP-Sandboxen) um kontrafaktische Varianten der Szenarien S7/S8: 63 Paare, 51 injizierbar über erreichbare Freitext-Felder in rund 21 Umgebungen; Angriff = fabrizierter 'URGENT COMPLIANCE HOLD' im Low-Trust-Kanal bei unverändertem autoritativem Zustand, indirekte Prompt-Injection als Verfügbarkeitsangriff. Induzierte Über-Enthaltung = Anteil Paare mit Clean-Pass und False-Warning-Fail (Wilson-95-%-Intervalle, n = 51, ein Lauf je Bedingung): Baseline -> Caution-First: deepseek-v4-pro 21,6 % [12-35] -> 64,7 % [51-76] (b,c = 27,1); gpt-5.4 27,5 % [17-41] -> 41,2 % [29-55] (17,0); gemini-3-flash 9,8 % [4-21] -> 86,3 % [74-93] (41,0); exakte McNemar p < 10^-4 überall. Clean-Judge-Pass Baseline/Caution-First: 98/90, 88/71, 96/96 % - die paarweisen Completion-Tests und die clean-konditionierten Raten sind getrennte Maße. Judge: gpt-5.4 konstant (zugleich evaluiertes Modell); Multi-Seed-Kontrolle (gpt-5.4, 3 Seeds): gepoolt 64 vs. 31 % False-Warning-Completion, 8/15 Aufgaben höher unter Baseline, 0 Umkehrungen.
Wortlaut (n = 7, Aktions-Traces): explizite Warnung minus faktenbasierte Beschreibung desselben Litigation-Hold: deepseek-v4-pro +100 pp (100 vs. 0 %, p = 0,0156), gpt-5.4 +47 pp (p = 0,125, 3 Seeds), gemini-3-flash +29 pp (p = 0,50); Publishing-Umgebung (n = 7): +0/+43/-14 pp, nichts signifikant. Provenance-Aware (Trust-Tier-Hülle + Verify-Before-Abstain, Dokumentenanalyse n = 15): False-Warning-Completion vs. Caution-First 27 -> 100, 33 -> 73, 13 -> 100 %; In-Band-Provenance-Fälschung ändert Enthaltung auf 0/20/7 % (vs. wahrhaft 0/27/0); Authoritative-Record-Kompromittierung 100/93/93 %, dort angemessen (modifizierter Zustand). Sensitive-Content: Leaks ändern sich gemischt (z. B. deepseek 0/7 -> 1/7), keine gleichmäßige Vertraulichkeitswahrung. Publishing (n = 16): Über-Enthaltung 25 -> 75 % (p = 0,008), 44 -> 44 % (p = 0,45), 12 -> 50 % (p = 0,016). Limitationen: keine Leaderboard-Reproduktion, kleine Stichproben, Interface ohne Freitext-Träger (retail_orders) begrenzt den Kanal, Code-Release angekündigt.
2. When Evaluators of AI Agents Disagree
Im lässt 90 tau2-bench-Aufgaben (50 airline, 40 retail) unter gpt-4.1-mini und gpt-4.1 in vier Gate-Bedingungen (C0-C3) mit je 3 Wiederholungen laufen: 2.160 Episoden, jede DB-Schreiboperation aufgezeichnet. Vier Bewerter: native Gold-State-Wertung, LLM-Judge (gpt-4.1-mini, 2 Calls, Mehrheit), Judge mit Policy-Dokument (judge-P) und ein Boundary-Evaluator (eine Bit Gold-Info: Schreiben erwartet ja/nein, ohne Modellaufruf). Paarweise Übereinstimmung (Task-Cluster-Bootstrap): native-Judge 0,562 [0,496; 0,627], native-Boundary 0,761, Judge-Boundary 0,782, Judge-Selbst 0,982 [0,975; 0,988]; der Judge passiert 929 der 1.007 nativ durchgefallenen Episoden (92,3 %). Menschliches Referenzurteil: 120 stratifizierte Episoden, 2 unabhängige Annotatoren, Achsen A1 Aufgabe/A2 Policy/A3 Schreibentscheidung (A1 raw 0,842, kappa 0,686; A2 nach Re-Kalibrierung raw 0,742, kappa 0,306; A3 raw 0,750, kappa 0,477), gewichtete Schätzungen. Gewichtete Übereinstimmung A1: native 0,818, Boundary 0,766, judge-P 0,622, Judge 0,584; A3: 0,758/0,708/0,600/0,575; Judge-False-Pass 39,9 % vs. False-Fail 1,8 %.
Premature commitments (A3 = nein, unerwarteter Write, menschlich bestätigt, n = 11): Judge und judge-P passieren alle 11 (ungekürzt: 10 bzw. 11), native fällt alle 11, Boundary fängt alle 11. Modellstufen (ungekürzt, n = 120): gpt-4.1 unterscheidet sich nicht von mini; gpt-5.6 Sol ohne Policy A1 0,737 (+0,133 vs. mini, Intervall exkludiert 0), passiert 6/11, aber nicht signifikant über Boundary (A1 -0,029 [-0,140; +0,082]) und signifikant unter native; mit Policy fängt Sol 11/11, fällt aber 40/55 vollständig korrekte Episoden (A1 0,580). A2: alle Evaluatoren 0,595-0,672, triviale Baseline 0,688. Ungated (C0, n = 540): 60 premature commitments = 11,1 % [6,1; 16,5], airline 19,3 % (gpt-4.1: 18,0; mini: 20,7), retail 0,8 %. Gates C0 vs. C3 (Task-Level-Sign-Flip-Permutation, Holm über 8 Tests): nichts signifikant; retail/gpt-4.1 Boundary-Erfolg 17 zu 4 negativ diskordant (p = 0,030, Holm 0,240); Ursache: Evidenz-Digest kürzt Tool-Results auf 800 Zeichen und schrumpft ab 6.000 Zeichen auf 8 Nachrichten (retail: 59,4 % der Tool-Results > 800 Zeichen, airline 27,5 %). Replikationspaket: Zenodo DOI 10.5281/zenodo.23683806.
3. SideTaskBench: Unauthorized Side-Task Delivery
Wen und Xu (CUHK) paaren 25 kompakte Python-Repairs mit 190 Side-Task-Units zu 300 Paaren in vier Relevanzstufen (L3 Mechanismus-Overlap bis L0 unverbunden); der Side-Task-Kontrakt sitzt in der externen technischen Referenz, getrennte Auswertung von Exposure E, Versuch A, korrekter Arbeit W, valider Lieferung D und Joint J = H x D. Agent: MicroCoder; Modelle DeepSeek-V4-Flash und Qwen3.8-Max. Konditionsvergleich (je 480 Läufe, historische Kohorte): wrapped Delivery 39,58 % (DSV4; Host 97,71 %, Joint 38,96 %) und 40,62 % (Qwen; Host 83,33 %, Joint 36,88 %), Clean-Baselines 97,71/84,58 %; direct 9,58 % (DSV4) vs. 48,33 % (Qwen), Delivery|Seen 13,33 bzw. 73,19 %; Boundary-System-Prompt: DSV4 Delivery 0,00 % (Host 99,17 %), Qwen 21,88 % (Delivery|Seen 34,77 %) - kein verlässlicher Schutz. Wiederholungsbudget (480 Paare, DSV4, wrapped): Delivery/Lauf ~39,6 % stabil, Paare mit >=1 Lieferung 39,58 % (k=1), 82,50 % (k=4), 96,25 % (k=8), Any-Joint 95,62 % (k=8).
v10-Ähnlichkeitslauf (19.10.2026, 300 Paare x 8 = 2.400 Läufe, DSV4, wrapped): Delivery|Seen L3 57,44, L2 43,62, L1 25,85, L0 20,48 % (Endpunkt-Differenz 36,96 pp, Faktor 2,80); Exposure 96,67-98,00 %, Repair 97,00-98,00 %; L1-L0 = 5,37 pp, Host-Cluster-Intervall [0,56; 10,13], Host-by-Unit-Sensitivität [-4,81; 14,89] - deskriptive Ordnung, keine Kausalität (Kategorien/Schwierigkeit unbalanciert). Von 2.400 Läufen 1.540 ohne valide Lieferung: 1.467 Exposure ohne Versuch, 7 Versuch ohne valide Lieferung, 66 ohne Exposure. Token-Overhead wrapped vs. clean: +23,4 % (DSV4), +60,8 % (Qwen), versuchs-konditioniert mit Selektionsvorbehalt, kein kausales Kostenmaß. Provenienz: Konditions-, Repair-spezifische und Wiederholungstabellen sind historische, lokal nicht vollständig regenerierbare Kohorten; v10 mit Manifesten und Audit-Records, ohne vollständige unabhängige Regrade; ein Framework, ein Modell im Ähnlichkeitslauf; kein Nachweis öffentlicher Exfiltration. Code: github.com/xywen97/SideTaskBench; Dokumentation abgeglichen, kein eigener Nachbau.
Methode
Quellenabgleich der drei Original-Preprints und der verlinkten Replikations-/Code-Dokumentation. Alle Messwerte sind Angaben der Autoren; kein eigener experimenteller Nachbau.
Quellen
- When Safety Becomes an Attack Surface: Manipulating Abstention in Tool-Using AI Agents, arXiv (Charles Xiao) (abgerufen 2026-11-14)
- When Evaluators of AI Agents Disagree: An Empirical Study of Native Scoring, LLM Judges, and Commit-Boundary Checks on tau2-bench, arXiv (Sungbin Im; aSSIST Seoul, AIM Intelligence) (abgerufen 2026-11-14)
- SideTaskBench: Measuring Unauthorized Side-Task Delivery in Coding Agents, arXiv (Xiangyu Wen, Qiang Xu; Chinese University of Hong Kong) (abgerufen 2026-11-14)
- SideTaskBench: Code und Kohorten-Dokumentation, Xiangyu Wen / GitHub (abgerufen 2026-11-14)
- Replikationspaket zu When Evaluators of AI Agents Disagree, v9, Sungbin Im / Zenodo (abgerufen 2026-11-14)