 KI
Hugging Face hat mit Carbon-X ein ungewöhnliches Sprachmodell veröffentlicht: Das offene Modell mit 14,8 Milliarden Parametern wurde gemeinsam auf DNA-Sequenzen und natürlichsprachlichem Text trainiert. Man gibt rohe DNA in einer ganz normalen Chat-Unterhaltung ein, und das Modell antwortet auf Englisch: Es schätzt ein, ob Mutationen harmlos oder krankheitserregend sind, erkennt Regionen, die Genaktivität steuern, ordnet Sequenzen Organismusgruppen zu, sagt die nächsten Basen einer Sequenz voraus und erklärt seine Begründung [1].
Architektonisch ist Carbon-X ein Decoder-only-Transformer mit 40 Schichten, Hidden Size 5.120, Grouped Query Attention (40 Query-, 8 KV-Köpfe), SwiGLU und RMSNorm mit QK-Norm. DNA und Text teilen sich einen einzigen Tokenstrom in einem einzigen Decoder - einen separaten DNA-Encoder gibt es nicht [1].
Ein Tokenizer für zwei Alphabete
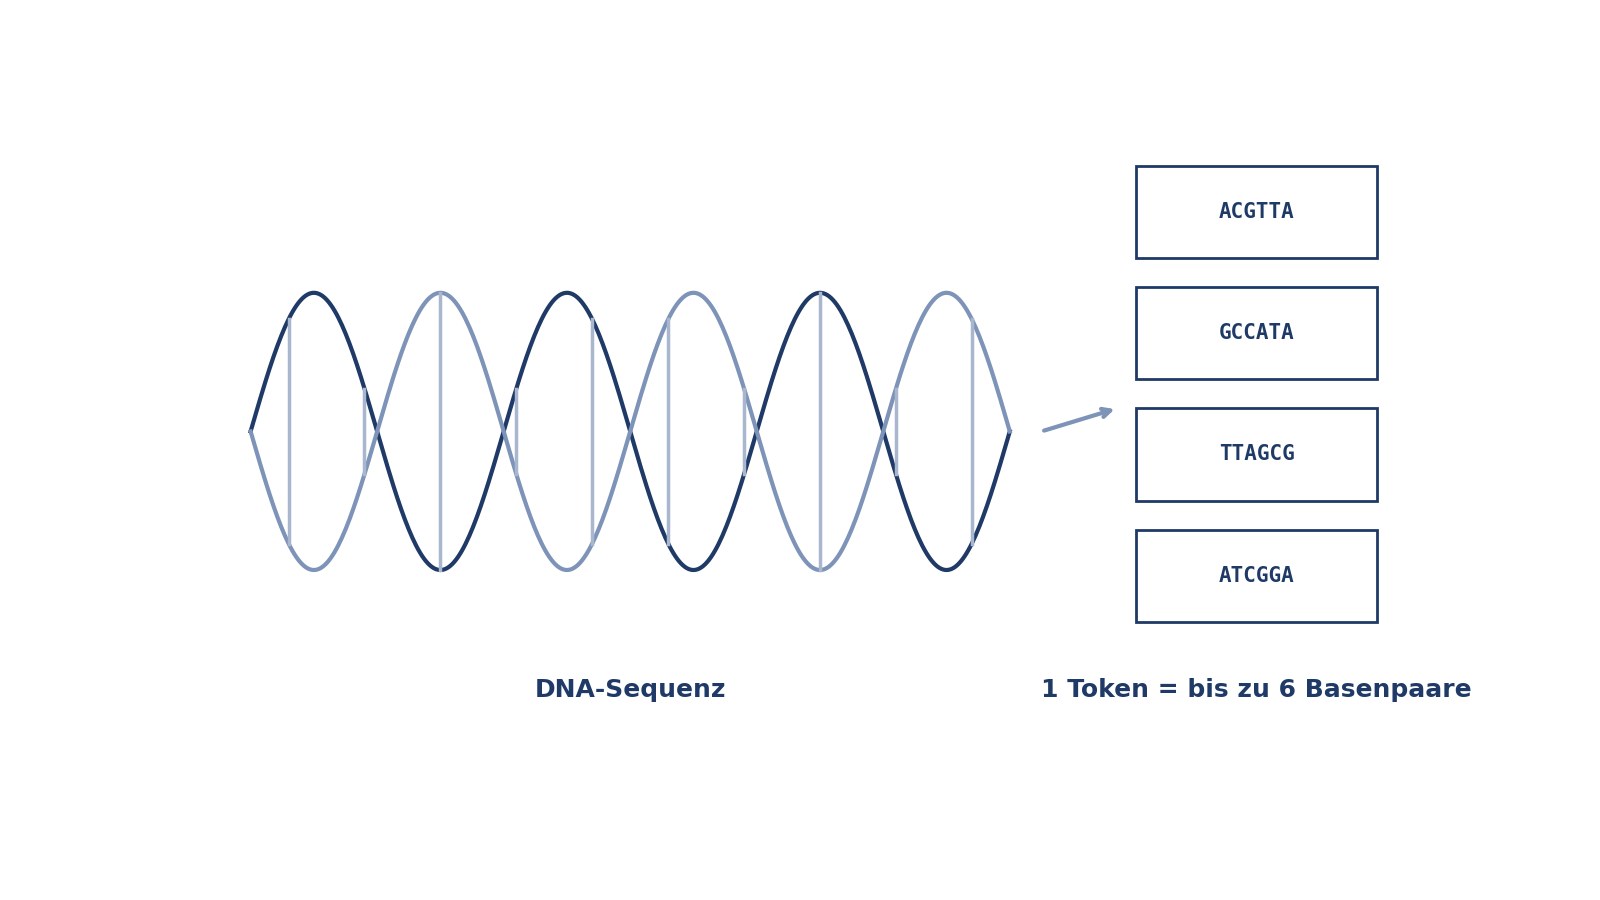
Der Kniff steckt im hybriden Tokenizer: Für Text nutzt Carbon-X das BPE-Vokabular von Qwen3, DNA wird als nicht überlappende 6-Mere kodiert - ein DNA-Token deckt also sechs Basenpaare ab. Insgesamt kommen 5.515 DNA-Tokens zum Textvokabular: 4.096 6-Mere, 1.364 Rest-Tokens für Sequenzen, deren Länge kein Vielfaches von sechs ist, sowie Marker für Sequenzanfang und -ende. DNA im Prompt wird automatisch erkannt und markiert [1]. Damit llama.cpp den Hybrid-Tokenizer korrekt verarbeitet, ist mindestens Build b11742 nötig - ältere Builds laden das Modell, tokenisieren DNA aber falsch [2].
Benchmarks: nah an Frontier-Modellen, mit Ausreißern nach beiden Seiten
Über fünf DNA-Benchmarks - sie decken die Vorhersage von Mutationseffekten, Sequenzverständnis und die Vorhersage der nächsten Basen ab - erreicht Carbon-X ohne Reasoning-Modus im Mittel 66,7 Prozent. Das sind nach Herstellerangaben 27 Punkte mehr als Qwen3-14B, das Ausgangsmodell, und mehr als jedes andere getestete offene Modell. GPT-6.1 Sol liegt mit 67,5 Prozent nur knapp vorn - laut Hugging Face bei etwa 1/1.800 der Inferenzkosten pro Aufgabe [1]. Zwei der fünf Benchmarks (FrontierVEP und NextBase) stammen vom Carbon-X-Team selbst, BioReason und GenomeQA aus der Literatur [1][3].
| Benchmark (Aufgabe) | Carbon-X | Bester Vergleichswert | Von |
|---|---|---|---|
| BioReason Coding (Mutationen in kodierenden Regionen) | 74,9 | 71,0 | GPT-6.1 Sol |
| BioReason Non-SNV (Insertionen, Deletionen u.a.) | 85,1 | 94,8 | Opus 5.5 |
| GenomeQA (Sequenzverständnis, 6 Teilaufgaben) | 63,6 | 67,2 | GPT-6.1 Sol |
| NextBase (nächste Basen vorhersagen) | 39,4 | 32,9 | GPT-6.1 Sol |
| FrontierVEP (Einbasen-Varianten, lange Referenz) | 70,4 | 76,2 | Opus 5.5 |
| Durchschnitt | 66,7 | 67,5 | GPT-6.1 Sol |
Die Detailwerte zeigen, wo das Modell stark und wo es schwach ist: Bei Mutationen in kodierenden Regionen und bei der Vorhersage der nächsten Basen führt Carbon-X das gesamte Testfeld an. Bei Fragen zu Splice-Sites (29,8 Prozent) und Histon-Marken (34,6 Prozent) liegt es dagegen kaum über der Zufallsrate - die Hersteller nennen das selbst als Schwäche [1]. Als Chat-Assistent bleibt das Modell brauchbar: Auf IFEval erreicht es 79,3 Prozent im strengen Maßstab [1].
Daten als Tabelle
| Durchschnitt in Prozent | |
|---|---|
| GPT-6.1 Sol | 67,5 |
| Carbon-X | 66,7 |
| Opus 5.5 | 60,9 |
| Kimi K3 | 50,4 |
| Gemini 4 | 49,8 |
| DS V4.1 Flash | 47,1 |
| GLM-5.3 | 39,8 |
Herstellerangaben; Vergleichsmodelle jeweils mit der Reasoning-Stufe ihres besten Durchschnitts [1]
Kosten: die 300-Dollar-Rechnung
Die Kostenargumentation der Modellkarte ist konkret: Carbon-X antwortet direkt, ohne ausgedehntes Reasoning, und verbraucht damit wenige Ausgabe-Tokens pro Aufgabe. Die Analyse der 2,4 Millionen Varianten unklarer Bedeutung (VUS) in der Datenbank ClinVar würde mit Carbon-X etwa 300 US-Dollar kosten, schätzt Hugging Face - mit den getesteten Frontier-Modellen dagegen 32.000 Dollar bis zu vier Millionen. Grundlage ist der gemessene Durchsatz pro H200-Stunde zu 5 Dollar [1]. Diese Rechnung stammt vom Hersteller und hängt an den eigenen Preis- und Durchsatzannahmen.
Training: Vokabular zuerst, dann 302 Milliarden Token
Carbon-X startet von Qwen3-14B [1][4]. Die neuen DNA-Tokens bekommen zufällig initialisierte Embeddings; rund zehn Milliarden Token lang bleibt der Transformer-Körper eingefroren, damit nur die DNA-Embeddings lernen. Danach folgt das eigentliche Mid-Training über 302 Milliarden Token: 55 Prozent rohe DNA, 20 Prozent Englisch, 15 Prozent Biologie-Text und 10 Prozent Instruktionsdaten. Die Lernrate war in den Ablationen der kritische Regler: zu niedrig, und die DNA-Werte bleiben auf Zufallsniveau; zu hoch, und das Modell verlernt Englisch [1]. Anschließend folgen Supervised Fine-Tuning (drei Epochen, rund 30 Prozent Varianten-Reasoning) und Reinforcement Learning mit verifizierbaren Belohnungen auf DNA-Aufgaben [1].
Offen und lokal: Apache 2.0, eine GPU, GGUF
Die Gewichte stehen unter Apache 2.0 [1]. In bfloat16 passen sie auf eine einzige GPU mit 80 GB; als Servingschicht genügt vLLM [1]. Für den lokalen Betrieb gibt es GGUF-Quantisierungen für llama.cpp - empfohlen wird Q8_0 mit 15,8 GB, dazu kleinere Varianten bis rund 9 GB [2]. Hugging Face hebt den Datenschutzaspekt hervor: Wer mit sensiblen oder unveröffentlichten Sequenzen arbeitet, kann das Modell auf eigener Infrastruktur halten, statt sie an eine API zu schicken [1]. Umgekehrt warnt die Karte davor, genetische Daten unbedarft in Drittanbieter-Demos oder Spaces zu geben [1].
Grenzen: kein klinisches Werkzeug
Die Modellkarte ist ungewöhnlich deutlich: Carbon-X ist nicht klinisch validiert und darf nicht für medizinische Entscheidungen genutzt werden [1]. Dazu kommen technische Grenzen: Exakte Sequenzoperationen (Zählen, Koordinaten, Edits) sind fehleranfällig, besonders bei langen Sequenzen; bei fehlendem Kontext kann das Modell Identität oder Funktion einer Sequenz erfinden - klassische Halluzinationen; für das Design neuer Sequenzen wurde es nicht trainiert [1]. Das Kontextfenster beträgt zwar 40.960 Token, evaluiert wurde aber nur bis zu den im Training gesehenen Längen (8.192 Token, etwa 49 kbp DNA) [1].
Entstanden ist Carbon-X als Kollaboration der Forschungsteams von Hugging Face, der Zhongguancun Academy und des Telethon Institute of Genetics and Medicine beziehungsweise der Universität Neapel 'Federico II' [1]. Für die Bioinformatik ist der Ansatz bemerkenswert, weil er die Trennung zwischen Sequenzmodellen und Sprachmodellen aufhebt: Statt DNA als bloße Eingabe für Spezialmodelle zu behandeln, wird sie zur zweiten Sprache eines normalen Chat-Modells - inklusive der Frage, ob sich biologisches Wissen ähnlich stichprobeneffizient lernen lässt wie Sprache.
Methode
Analyse auf Basis der von Hugging Face veröffentlichten Modellkarten (Carbon-X und GGUF-Variante), der Qwen3-14B-Karte sowie des BioReason-Papers (NeurIPS 2025) zur Herkunft der Benchmarks. Alle Benchmark- und Kostenzahlen stammen vom Hersteller und wurden nicht unabhängig reproduziert.
Grenzen
Die Benchmark-Ergebnisse sind Herstellerangaben; zwei der fünf Benchmarks (FrontierVEP, NextBase) wurden vom Carbon-X-Team selbst entwickelt. Das Modell wurde von der Redaktion nicht selbst ausgeführt. Carbon-X ist nicht klinisch validiert; alle Angaben zur Variantenbewertung sind Forschungskontext, keine medizinische Aussage.
Quellen
- HuggingFaceBio/Carbon-X - Modellkarte, Hugging Face (abgerufen 2026-10-26) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- HuggingFaceBio/Carbon-X-GGUF - Modellkarte, Hugging Face (abgerufen 2026-10-26) ↩1 ↩2 ↩3
- BIOREASON: Incentivizing Multimodal Biological Reasoning within a DNA-LLM Model, NeurIPS 2025 Proceedings (abgerufen 2026-10-26) ↩
- Qwen/Qwen3-14B - Modellkarte, Hugging Face / Qwen (abgerufen 2026-10-26) ↩