 KI
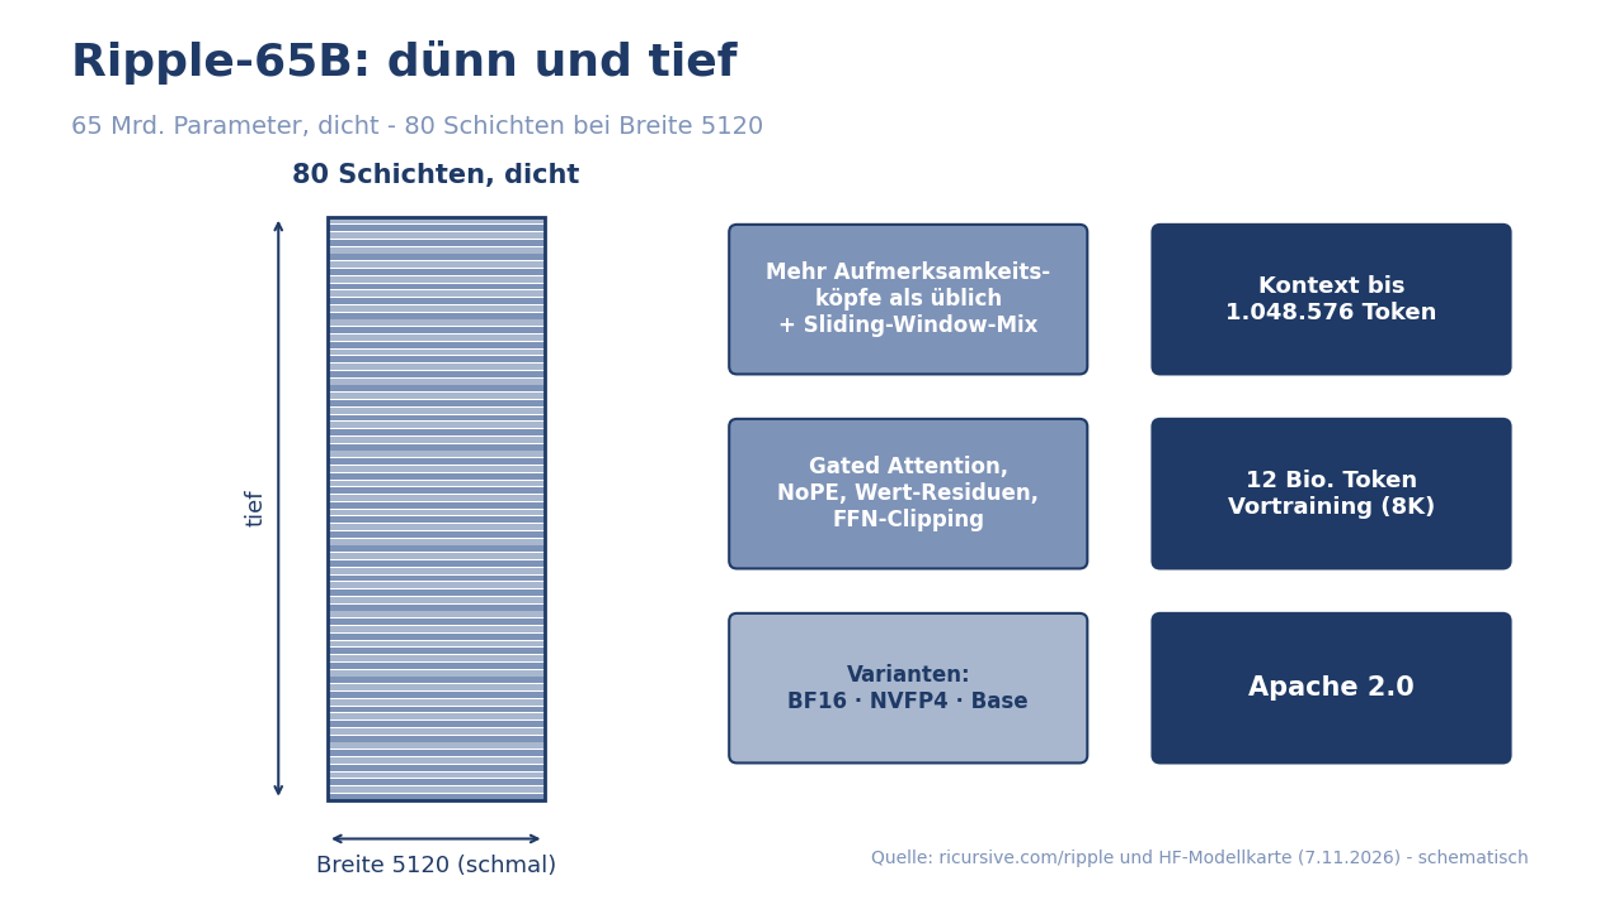
Ricursive Intelligence, ein US-Labor für gemeinsam optimierte Modelle und Hardware, hat Ripple-65B Preview veröffentlicht: ein dichtes Sprachmodell mit 65 Milliarden Parametern, bis zu einer Million Token Kontext und Apache-2.0-Lizenz [1][2]. Das Modell ist die allgemein nutzbare Variante eines proprietären Modells, das im Hause eine Plattform für KI-gestützten Chipentwurf steuert [2]. Verfügbar ist es über Hugging Face und mehrere Inference-Anbieter; das Repository wurde am 4. November 2026 angelegt (Plattform-API) [1].
Die Eckdaten
Ripple-65B Preview im Überblick (Herstellerangaben aus Karte und Blog) [1][2]
Modell
65 Milliarden Parameter, dichter Transformer, 80 Schichten, Modellbreite 5120. Von Grund auf trainiert auf 12 Billionen Token (überwiegend englischsprachiger Text und Code) mit 8K Sequenzlänge. Kontext bis 1.048.576 Token.
Varianten und Lizenz
Instruct-Modell in BF16 und NVFP4, dazu ein reines Basismodell (nur vortrainiert, ohne Mid-Training oder synthetische QA-Daten) und eine DFlash2-Variante. Lizenz: Apache 2.0.
Training und Kosten
Modell-FLOPs-Auslastung (MFU) von 40 Prozent während Vor- und Nachtraining, mit einfachem Sharding, ohne eigene Kernels und ohne Quantisierung (BF16). Gesamte F&E-Kosten laut Anbieter 32 Millionen US-Dollar - inklusive Trainingsleiter, Datenmischung, Evaluierungen, Debugging, synthetischer Daten, Nachtraining und dem finalen Lauf.
Architektur: dünn und tief statt Experten-Mischung
Während viele aktuelle offene Modelle auf Mixture-of-Experts setzen, wählte Ricursive bewusst einen modernisierten dichten Transformer - ausdrücklich, um die Infrastruktur für Training und Betrieb einfach zu halten [1][2]. Das Seitenverhältnis ist "thin-and-deep": schmale Breite von 5120 bei 80 Schichten. Als Ausgangspunkt diente die Architektur von Olmo 3 (Ai2); gewechselt wurde zu einer Gemma-3N-ähnlichen Bauweise für mehr Stabilität in dieser Größe [1].
Für besseres Schlussfolgern setzt das Modell auf mehr Aufmerksamkeitsköpfe als üblich; die Mehrkosten gleicht der Anbieter durch ein höheres Verhältnis von Sliding-Window- zu globalen Schichten und kleinere Fenster aus. Dazu kommen FFN-Aktivierungs-Clipping, sigmoid-gesteuerte Aufmerksamkeit (gated attention), globales NoPE (ein Teil der Schichten verzichtet auf Positionskodierung) und Wert-Residuen (value residuals) [1][2].
Der Weg dahin lief über eine Trainingsleiter mit sechs dokumentierten Stufen: Chargengrößen- und Lernraten-Gesetze (v1.0/v1.1), Wechsel zu pre+post-Normierung (v1.2, wirksam ab 4 Milliarden Parametern), sigmoid-gesteuerte Aufmerksamkeit (v1.3), ein verworfener Hyper-Connections-Ansatz (v1.4, bei 4 Milliarden ohne Vorteil), globales NoPE mit Lernraten-Cooldown (v1.5) und Wert-Residuen (v1.6) [2]. Gemessen an der Recheneffizienz auf Code (dolma_stack CE) brachten die Stufen zusammen laut Anbieter bis zum Faktor 16 bei 4 Milliarden Parametern gegenüber der Olmo-3-Leiter; beim vollen Lauf spricht der Anbieter von bis zu Faktor 55. Solche Faktoren sind interne Vergleichsrechnungen des Anbieters, keine unabhängig geprüften Werte [1][2].
Nachtraining: keine Daten gekauft, viel selbst gebaut
Das Nachtraining folgt einem Standardgerüst - Mid-Training, Langkontext, SFT, Langkontext-SFT und domänengemischtes Reinforcement Learning -, bleibt aber nach Angaben des Anbieters bewusst schlank [1][2]:
- Mid-Training: 200 Milliarden Token, 8.000 Schritte, 64K Sequenzlänge
- Langkontext: 6,5 Milliarden Token, 389 Schritte, 2M Sequenzlänge
- SFT: 183 Milliarden Token, 7.274 Schritte, 128K Sequenzlänge
- Langkontext-SFT: 13,5 Milliarden Token, 802 Schritte, 2M Sequenzlänge
- RL: 700 Schritte, 128K Sequenzlänge, Batch 2048
Für das RL nutzt der Anbieter eigene synthetische Datenpipelines mit Qualitätsfiltern und Abdeckungsmetriken; gekaufte Nachtrainingsdaten gab es nicht. Das Rezept kombiniert abgeschnittene Importance-Sampling-Korrektur, Score-Zentrierung und eine lineare Längenstrafe mit langen synthetischen Aufgabenumgebungen, die mit dem Modell mitwuchsen [2]. Das Ergebnis: 80,5 auf TerminalBench 2.1 mit 1,4 Millionen Rollouts - laut Anbieter rund 70-mal weniger Rollouts als Reflection Beam, der vorherige Spitzenwert. Auch das ist eine Anbieterangabe [2].
Die gemeldeten Messwerte
Die Karte vergleicht Ripple-65B Preview mit vier größeren US-Modellen offener Gewichte (Nemotron 3 Ultra 550B, Inkling 975B, Muse Spark Open 816B, Reflection Beam 501B). Getestet wurde in BF16 mit maximalen Anstrengungseinstellungen; wo Herstellerwerte fehlten, maß Ricursive mit eigenem Ablauf nach (in der Karte kursiv markiert). Für SWE-bench Pro v2.0 Hard und DeepSWE 1.1 kam Terminus 2 zum Einsatz, sonst überwiegend OpenCode [1].
Daten als Tabelle
| Ripple-65B Preview | |
|---|---|
| TerminalBench 2.1 | 80,5 |
| SWE-bench Verified | 76,5 |
| SWE-bench Pro v2.0 Hard | 79,1 |
| MMLU | 89,6 |
| GPQA Diamond | 85,2 |
| AA-LCR (Langkontext) | 75 |
Anbieterangaben aus der Modellkarte, von uns nicht unabhängig nachgemessen [1]. Je Benchmark eigene Aufgaben und Metriken - nicht testübergreifend vergleichbar. Der Anbieter weist selbst auf starke Harness-Abhängigkeit agentischer Tests hin.
Bemerkenswert offen: Der Anbieter beschreibt ausdrücklich, wie schwierig die Nachmessung moderner agentischer Evals ist. Mit dem offiziellen Terminus-2-Harness bei 128K Sequenzlänge und Zusammenfassung lagen die TerminalBench-2.1-Werte nahezu aller Modelle niedriger als selbst gemeldet - Ausnahme: Muse Spark Open. Die eigene Tabelle sei daher ein "best-effort"-Vergleich, kein Endurteil [1]. Im direkten Harness-Vergleich (Terminus 2) erreichte Ripple 80,5, Muse Spark Open 78,7, Reflection Beam 70,8, Inkling 56,2 und Nemotron 3 Ultra 55,1 [1].
Abseits des Programmierens meldet die Karte unter anderem MMLU 89,6, GPQA Diamond 85,2, AIME 2025 98,3, IFBench 79,2 und AA-LCR 75,0 für Langkontext. Bei Sicherheitstests: FORTRESS Adversarial 83,8 und Benign 95,5, StrongREJECT 97,5. In diesen Zeilen führt jeweils ein anderes, größeres Modell die Tabelle an - der Anbieter druckt das so ab [1].
Das Basismodell im Vergleich
Ripple-65B Base Preview ist ein reiner Vortrainings-Checkpoint ohne Mid-Training. Verglichen mit Poolside Laguna M.1 (225B MoE), DeepSeek V3.1 (671B MoE), DeepSeek V4 Flash (284B MoE) und Nemotron 3 Ultra (550B MoE) liegt es nach Anbieterangaben bei klassischen Vortrainings-Evals vor Laguna M.1 und bei Schlussfolgern, Mathe und Code etwa auf DeepSeek-Niveau. Nemotron 3 Ultra dominiere die klassischen Evals - vermutlich wegen stark eingesetzter synthetischer Daten mit Aufgabenähnlichkeit -, ohne dass sich das in moderne agentische Aufgaben übertragen ließ, schreibt der Anbieter [1]. Gemessen wurde mit einem internen Fork von Ai2s Olmes [1].
Einordnung
Drei Punkte machen die Veröffentlichung relevant. Erstens die Richtung: ein dichtes Modell, das bewusst auf Infrastruktur-Einfachheit setzt und trotzdem in der selbst gemeldeten Tabelle mit deutlich größeren MoE-Modellen mitzieht - ein Gegenentwurf zur aktuellen MoE-Mehrheit [1][2]. Zweitens die Transparenz: Karte und Blog legen Trainingsleiter, Nachtrainings-Mengen, Harness-Wahl und sogar verworfene Architektur-Stufen offen; die Replikationswarnung zu agentischen Benchmarks ist ungewöhnlich deutlich [1][2]. Drittens die Zugänglichkeit: Apache 2.0, NVFP4-Checkpoint und ein Colab-Einstieg zielen ausdrücklich auf lokale Entwicklung [1].
Gleichzeitig bleibt alles Gemessene Herstellerangabe. Die 32-Millionen-Dollar-Rechnung, die Effizienzfaktoren der Trainingsleiter und der Vergleich der Rollout-Zahlen stammen aus dem eigenen Blog; eine unabhängige Prüfung liegt uns nicht vor [2]. Und die Stärke des Modells liegt laut Karte klar im agentischen Programmieren - bei Wissen, Mathe und Instruktionsbefolgung führen in der eigenen Tabelle andere Modelle [1].
FAQ
Methode
Analyse auf Basis der vollständig gelesenen Modellkarte (inklusive aller Benchmark-Tabellen und Trainingsdetails) und des vollständig gelesenen Launch-Blogbeitrags des Anbieters, ergänzt um die Hugging-Face-Repository-API (Anlagedatum, Varianten). Sämtliche Messwerte sind Herstellerangaben. Keine eigenen Tests.
Grenzen
Keine eigenen Tests. Alle Benchmark-Werte stammen vom Anbieter; dieser weist selbst darauf hin, dass agentische Evaluierungen je nach Harness stark abweichen können. Der TerminalBench-Vergleich mit anderen Modellen nutzt teils Herstellerwerte, teils eigene Nachmessungen des Anbieters (in der Karte kursiv markiert). Kosten- und Effizienzangaben (32 Mio. US-Dollar, 16-fache Recheneffizienz) sind Angaben des Anbieters ohne unabhängige Prüfung. Wir haben keine Fremdmessung ausgewertet - ob es eine gibt, können wir nicht ausschließen.
Quellen
- ricursiveAI/Ripple-65B-Preview (Modellkarte und Repository-API), Hugging Face / Ricursive Intelligence (abgerufen 2026-11-07) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Introducing Ripple-65B Preview, a Frontier Open-Weight Model, Ricursive Intelligence (Launch-Blog) (abgerufen 2026-11-07) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- ricursiveAI/Ripple-65B-Preview-NVFP4 und Ripple-65B-Base-Preview (Varianten-Repositories, API), Hugging Face / Ricursive Intelligence (abgerufen 2026-11-07)