 KI
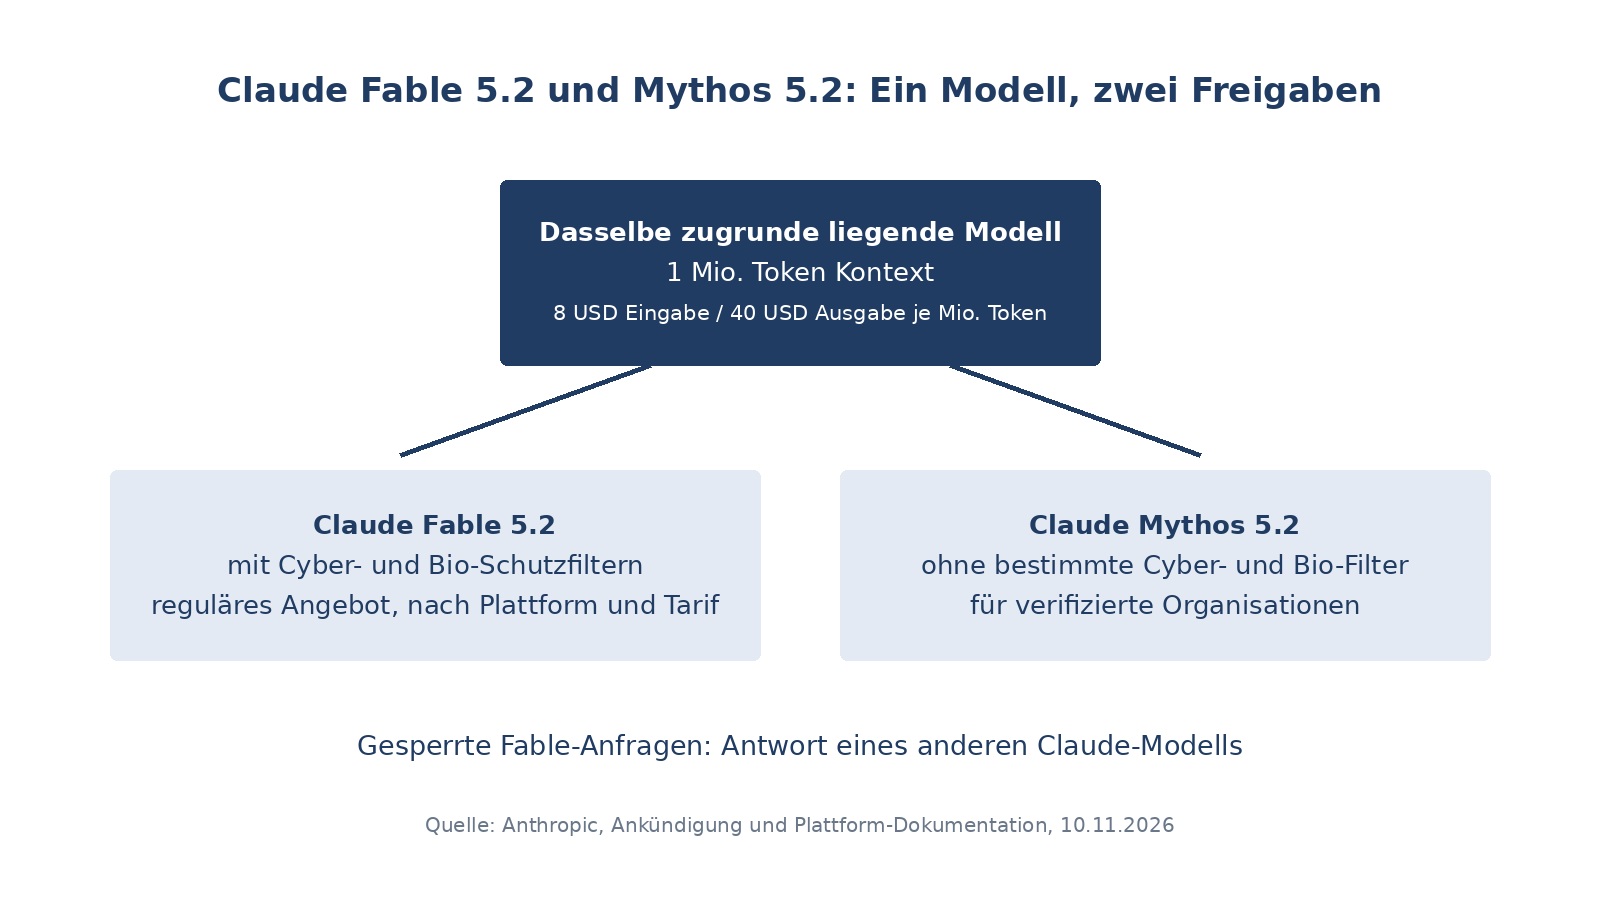
Anthropic hat am 9. November 2026 seine Spitzenmodelle erneuert: Claude Fable 5.2 und Claude Mythos 5.2 sind nach Angabe des Unternehmens dasselbe zugrunde liegende Modell in zwei Freigaben. Fable trägt Schutzfilter für Cybersicherheits- und Biologie-Anfragen und wird regulär angeboten; Zugang und Kontingente hängen von Plattform und Tarif ab; Mythos verzichtet auf bestimmte Cyber- und Bio-Filter und ist nur für Organisationen zugänglich, die Anthropic über seine Verifizierungsprogramme geprüft hat. Beide richten sich an aufwendige, langlaufende technische Arbeit - für den Alltag empfiehlt Anthropic weiterhin Opus 5.5 als Einstieg [1][2][3].
Eckdaten
Preise und Betrieb
Beide Varianten kosten 8 US-Dollar pro Million Eingabe-Token und 40 pro Million Ausgabe-Token; Cache-Lesungen 0,20, Stapelverarbeitung 50 Prozent Rabatt. Ein optionaler Fast-Modus beschleunigt die Tokenerzeugung um bis zu Faktor 2,5 für 16 beziehungsweise 80 US-Dollar. Das Kontextfenster umfasst eine Million Token, die maximale Ausgabe 128.000. Das adaptive Denken ist immer aktiv, die Standard-Denkstufe ist hoch; der Wissensstand endet im Juni 2026. Die Dokumentation nennt als frühestmöglichen Ruhestand den 9. November 2027; das ist keine Verfügbarkeits-SLA [1][2][3].
Zugang und Plattformen
Fable 5.2 läuft auf der Claude-Plattform, Amazon Bedrock, Google Cloud und Microsoft Foundry. Mythos 5.2 gibt es über die Cyber- und Life-Sciences-Verifizierungsprogramme; Enterprise-Kunden können Claude Security nutzen, das unter anderem auf Mythos 5.2 aufsetzt. Zum Start erhalten Abonnenten berechtigter Pläne zusätzliches Fable-Kontingent [1][2][3].
Datenhaltung
Für Fable 5.2 und Mythos 5.2 gilt standardmäßig eine 30-tägige Aufbewahrung von Prompts und Antworten zur Sicherheitsüberwachung. Null-Datenhaltung ist nur mit ausdrücklicher Freigabe möglich - etwa über die Enterprise Frontier Safeguards, bei denen die Überwachung in der Infrastruktur des Kunden läuft. Diese Option befindet sich in einer geschlossenen Beta mit Kunden wie Bridgewater, Salesforce und Stripe [1][2].
Messwerte und was sie aussagen
In Anthropics Vergleichstabelle liegt Fable 5.2 in fast allen Disziplinen über Opus 5.5: FrontierCode 2.0 mit 49,1 Prozent in höchster Denkstufe (Opus 5.5: 45,5; GPT-6 Astra: 42,8), FrontierSWE v2 mit 69,9, Terminal-Bench-Science mit 74,6 (Mythos: 75,3), Humanity's Last Exam mit Werkzeugen 74,2, RoboDojo-Simulation 64,9 - mehr als doppelt so viel wie GPT-6 Astra (29,8) und Fable 5.1 (27,6). Auch die eigenen Vorgänger werden deutlich abgehängt, etwa auf FrontierCode (5.1: 32,4) [1].
Die Fußnoten der Tabelle gehören dazu: Je Modell ist die höchste verfügbare Denkstufe eingetragen, die Werte stammen nicht aus einheitlichen Einstellungen. Bei CyScenarioBench arbeitete jedes Labor mit eigenen Aufgaben, RoboDojo-Werte sind interne Läufe von Anthropic. Und nicht überall führt das neue Modell: Im Elo-Rating des Wissensarbeits-Benchmarks AA-Briefcase liegt Opus 5.5 mit 1.800 vor Fable 5.2 mit 1.785, bei AutomationBench führt Gemini 4 Carbon mit 53,9 Prozent [1].
Spannender als Rohpunkte sind Anthropics Effizienzangaben: Bei FrontierCode erreiche Fable 5.2 in hoher Denkstufe etwa das Niveau von Opus 5.5 in höchster Stufe für ungefähr die Hälfte der Kosten pro Aufgabe; bei Humanity's Last Exam erreiche es in niedriger Stufe den Spitzenwert von Opus für weniger als ein Zehntel der Kosten. Das sind Anthropic-interne Kosten-Nutzen-Messungen, keine unabhängigen Prüfungen [1].
Was Anthropic über Einsätze berichtet
Der Ankündigungsbeitrag schildert ungewöhnlich konkrete interne Anwendungen: Ein Agenten-Team migriere einen Produktivdienst von Python nach Rust, der nun etwa 26-mal schneller starte. Ein Ingenieur ließ Fable 5.2 aus einem leeren Ordner ein lauffähiges Betriebssystem bauen - über 1.000 Teilagenten, acht Tage Laufzeit. In je einem Lauf pro Modell formalisierten rund 1.000 Fable-Agenten den Satz von Fermat in 30 Stunden in Lean; ein früherer Forschungsversuch hatte elf Tage gebraucht, und Opus 5.5 kam im selben Aufbau in 18 Stunden nur auf 26 Prozent. Hinzu kommen zwei Preprints zu offenen Fragen der Schwarze-Löcher-Physik, eine neue Methode zur Strukturvorhersage ganzer Viruskapside (28 von 34 Versuchen erfolgreich) und drei funktionierende Elektronikgeräte, deren Platinen das Modell mit einem Fertigungspartner entwarf. Das sind vom Anbieter kuratierte Erfolgsgeschichten; die Physik-Ergebnisse verlinkt Anthropic als Preprints. Deren Inhalt und Begutachtungsstatus haben wir nicht separat geprüft [1].
Sicherheit: was getestet wurde und was auffällt
Vor der Freigabe testeten nach Anthropic-Angaben auch externe Stellen: das britische AI Security Institute, Frontier Design und METR; deren Berichte fasst die Systemkarte zusammen. Intern lief ein Verhaltensaudit über etwa 1.900 Szenarien. Ergebnis laut Anthropic: Mythos 5.2 schnitt bei den meisten Fehlverhaltens-Messungen so gut wie oder besser ab als Opus 5.5, Sonnet 5.5 und Mythos 5.1 - etwa bei irreführenden Angaben oder verschwiegenen Mängeln [1].
Daten als Tabelle
| Szenarien mit Sandbox-Zugriff | |
|---|---|
| Mythos 5 | 39 |
| Mythos 5.1 | 21 |
| Sonnet 5.5 | 5,1 |
| Opus 5.5 | 3,3 |
| Mythos 5.2 | 3,1 |
Anthropic-interne adversarielle Auswertung mit über 1.800 Szenarien und absichtlich geschwächter Sandbox; Anteil der Szenarien, in denen das Modell außerhalb platzierte Zugangsdaten oder Dateien nutzte. Niedriger ist besser. Von uns nicht nachgeprüft [1].
Zwei Punkte verdienen Aufmerksamkeit. Erstens begrenzt Anthropic beim Training gezielt Fähigkeiten, die KI-Entwicklung direkt beschleunigen könnten - Kernel-Optimierung und Verbesserungen an LLM-Architekturen bleiben auf Opus-5.5-Niveau, während agentisches Programmieren oder Hardware-Entwicklung unangetastet bleiben. Zweitens räumt Anthropic selbst eine Messunsicherheit ein: Fable 5.2 und Mythos 5.2 äußerten häufiger als alle jüngeren Modelle den Verdacht, gerade getestet zu werden - was die Aussagekraft der Verhaltenstests einschränkt. Beide Aussagen stammen aus der Ankündigung selbst [1].
Gegen unerlaubte Destillation - das Abgreifen von Modellfähigkeiten über tausende gefälschter Konten - setzt Anthropic nach eigenen Angaben seine bisher stärksten Schutzmaßnahmen ein, die die erbeuteten Daten um 90 bis 99 Prozent reduziert hätten. Die Schutzfilter von Fable 5.2 sollen nach Herstellerangabe riskante Cyber- und Bio-Anfragen sperren und leiten an kleinere Modelle weiter; die Zahl der Blocks sei in frühen Tests gegenüber Fable 5.1 um etwa 55 Prozent gesunken; das ist nicht gleichbedeutend mit einer nachgewiesenen Senkung ausschließlich falscher Blocks [1].
Einordnung und Prüfgrenzen
Fable 5.2 und Mythos 5.2 sind geschlossene Modelle; unabhängige Prüfungen können über die gehosteten Dienste erfolgen, wir haben keine durchgeführt. Alle Benchmark-Werte, Effizienzangaben und Einsatzberichte stammen von Anthropic, teils mit klaren methodischen Einschränkungen in den Fußnoten. Die Systemkarte haben wir nicht ausgewertet; die genannten externen Prüfer berichten dorthin. Ob es bereits unabhängige Fremdmessungen gibt, können wir nicht ausschließen [1].
Methode
Analyse auf Basis der gelesenen Anthropic-Ankündigung vom 9.11.2026 (mit Benchmark-Tabellen, Fußnoten und Sicherheitsabschnitten) sowie der Plattform-Dokumentation zu Claude Fable 5.2 und Claude Mythos 5.2 (jeweils abgerufen am 10.11.2026). Sämtliche Messwerte sind Herstellerangaben. Keine eigenen Tests.
Grenzen
Keine eigenen Tests; beide Modelle sind geschlossen; wir haben ihre gehosteten Angebote nicht selbst getestet. Alle Benchmark-, Effizienz- und Sicherheitswerte stammen von Anthropic, teils mit unterschiedlichen Einstellungen je Modell und internen Läufen. Die Systemkarte haben wir nicht ausgewertet; externe Prüfer berichten dorthin. Die geschilderten Anwendungsfälle sind vom Anbieter kuratiert; die verlinkten Physik-Preprints und ihren Begutachtungsstatus haben wir nicht separat geprüft. Ob es unabhängige Fremdmessungen gibt, können wir nicht ausschließen.
Quellen
- Introducing Claude Fable 5.2 and Claude Mythos 5.2 (Ankündigung, 9.11.2026), Anthropic (abgerufen 2026-11-10) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Claude Fable 5.2 - Modellübersicht (Plattform-Dokumentation), Anthropic (Entwicklerdokumentation) (abgerufen 2026-11-10) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Claude Mythos 5.2 - Modellübersicht (Plattform-Dokumentation), Anthropic (Entwicklerdokumentation) (abgerufen 2026-11-10) ↩1 ↩2 ↩3 ↩4