 KI
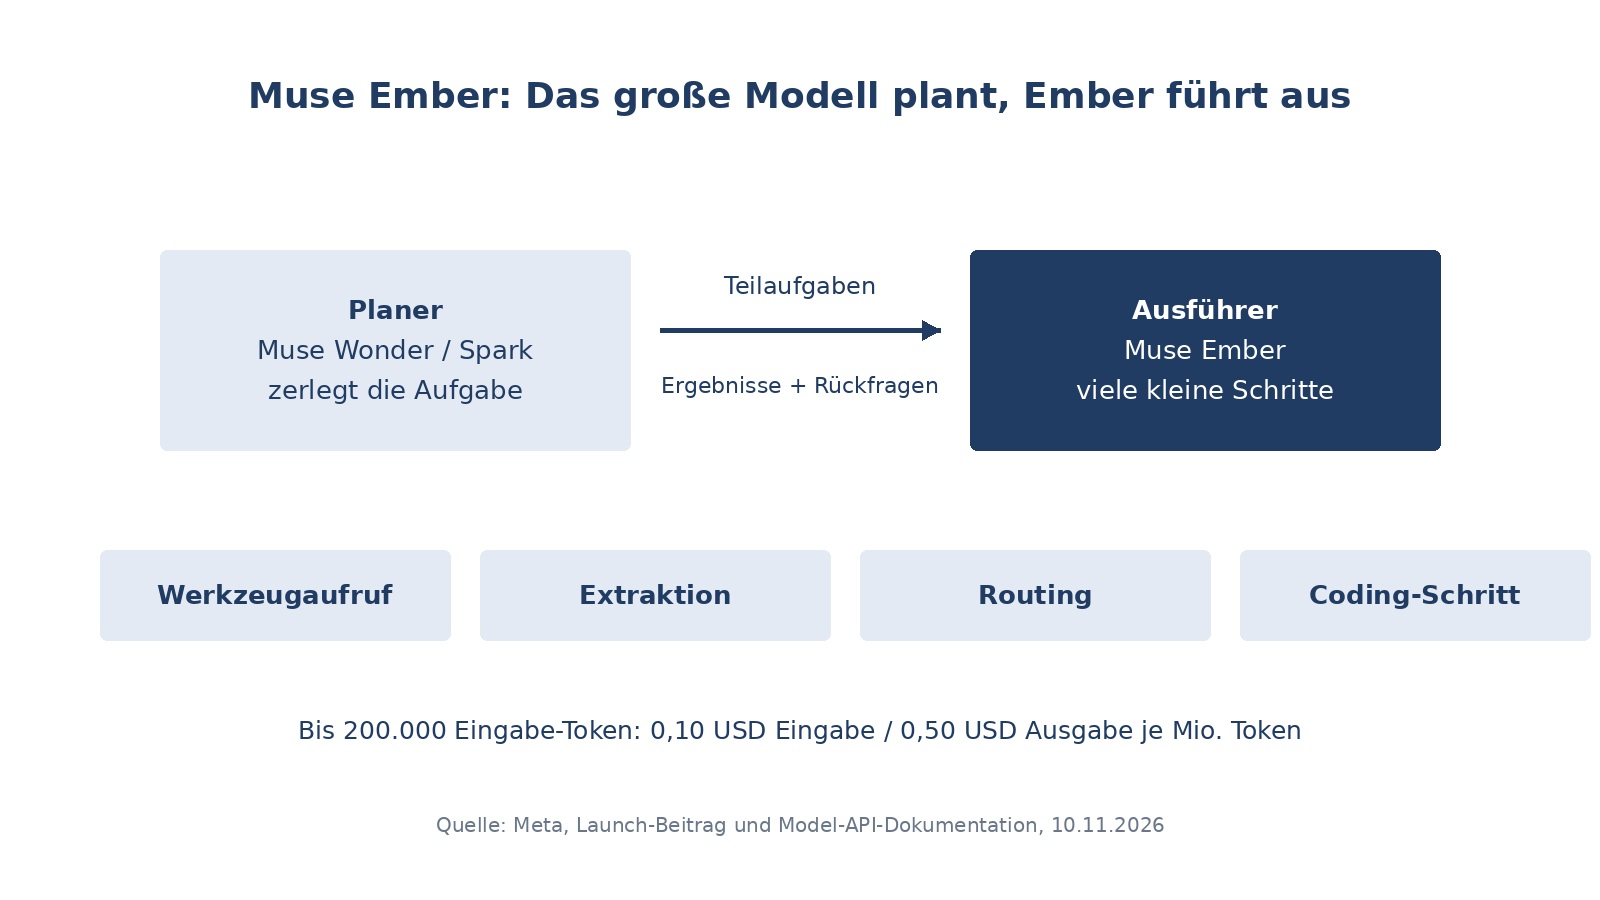
Meta hat am 9. November 2026 mit Muse Ember das kleinste Modell seiner Muse-Familie vorgestellt. Die Zielsetzung ist klar abgegrenzt: Ember soll nicht die schwersten Probleme lösen, sondern die vielen kleinen, strukturierten Schritte übernehmen, die in Agenten-Systemen den größten Teil der Token verbrauchen - Werkzeugaufrufe, Coding-Teilaufgaben, Routing, Extraktion und das Lesen langer Dokumente. Es ist laut Meta das erste Modell, das mit Muse Wonder Full trainiert wurde. Die geprüften Quellen beschreiben gehostete Dienste, keine zum Download angebotenen Gewichte [1][2].
Eckdaten
Preise und Abrechnung
Für Prompts bis 200.000 Token kostet Muse Ember 0,10 US-Dollar pro Million Eingabe-Token, 0,004 für zwischengespeicherte Eingaben und 0,50 pro Million Ausgabe-Token. Darüber greifen Langkontext-Sätze: 0,30 beziehungsweise 1,50 US-Dollar und 0,012 für Cache-Zugriffe. In Muse Code ist das Modell in allen Abonnements enthalten; auf der Model API läuft es im Standard-Modus, eine Contributor-Variante gibt es nicht [1][2].
Ein- und Ausgabe, Schnittstellen
Das Kontextfenster umfasst 1.048.576 Token, die maximale Ausgabe 524.288 Token. Muse Ember nimmt Text, Bilder, Video, Audio und PDFs entgegen und gibt Text aus. Die Denktiefe lässt sich von minimal bis maximal stufen, Standard ist die höchste Stufe. Unterstützt werden die Responses-, Chat-Completions- und Messages-Schnittstellen; Anfragen haben denselben Aufbau wie bei Muse Spark, ein Wechsel ist laut Meta meist nur eine andere Modell-ID [2].
Rolle im Portfolio
Meta positioniert die Familie gestaffelt: Muse Wonder für die schwersten Probleme, Muse Spark für Coding und agentische Arbeit, Muse Ember für wiederholbare Ausführung in großer Stückzahl. Die empfohlene Bauweise: Ein größeres Modell plant die Hauptschleife, Ember bekommt klar umrissene Teilaufgaben mit Akzeptanzkriterien übergeben und meldet Unklarheiten an den Planer zurück [1][3].
Messwerte und was sie aussagen
Meta vergleicht Muse Ember in seiner Launch-Tabelle mit Claude Haiku 5.5 und GPT-6 Luna, jeweils in der höchsten Reasoning-Einstellung. Vorn liegt Ember demnach bei AutomationBench-AA (37,8 gegenüber 13,9 und 20,2 Prozent), bei Agents' Last Exam (61,6 gegenüber 57,0 und 57,1), beim firmeninternen Personal Superintelligence Index (46,8 gegenüber 36,1 und 37,0), bei Terminal-Bench 4.0 (40,9 gegenüber 39,2 und 16,4), beim Coding Agent Index-AA (46 gegenüber 37 und 31), bei OSWorld 2.1 (69,5 gegenüber 68,9 Teilpunkte) und bei PerceptionBench (80,6 gegenüber 78,6). Die Fußnoten ordnen ein: Terminal-Bench lief je Modell in dessen bestem veröffentlichten Harness (mini-swe-agent, Claude Code, Codex), der PSI ist ein interner Mischindex, OSWorld wurde intern mit Teilpunkten gemessen, PerceptionBench intern mit Werkzeugen [1].
Nicht vorn liegt Ember in derselben Tabelle bei FrontierCode 2.0-AA: Dort führt Claude Haiku 5.5 mit 34,9 Prozent vor Muse Ember mit 27,2. Bei GDP.pdf-AA steht es 22,8 zu 22,8 gegen GPT-6 Luna. Und auf dem Artificial Analysis Intelligence Index (Version 5, Stand 9.11.2026, von Meta zitiert) erreichen Ember und Haiku 5.5 mit je 36 Punkten denselben Wert - der Preis macht den Unterschied: Laut Meta kostet eine Index-Aufgabe mit Ember etwa 0,14 US-Dollar, mit Haiku in dessen höchster Reasoning-Stufe etwa 0,41 US-Dollar. Die Artificial-Analysis-Werte hat Meta übernommen; wir haben sie nicht selbst nachgemessen [1].
Daten als Tabelle
| Kosten pro Aufgabe | |
|---|---|
| Muse Ember (max) | 0,14 |
| GPT-6 Luna (max) | 0,15 |
| Claude Haiku 5.5 (max) | 0,41 |
Meta-Angaben auf Basis der Rohdaten von Artificial Analysis (Intelligence Index v5, 9.11.2026); Muse-Ember-Kosten zum Listenpreis geschätzt. Eine Metrik: US-Dollar pro Aufgabe in der jeweils höchsten Reasoning-Einstellung. Von uns nicht nachgemessen [1].
Zum Vergleich im eigenen Haus: Muse Spark 1.3 erreicht auf demselben Index 37 Punkte, kostet aber laut Meta 2,39 US-Dollar pro Aufgabe - rund das Siebzehnfache des gerundeten Ember-Werts von 0,14 US-Dollar. Wer also Aufgaben hat, die Ember noch zuverlässig erledigt, zahlt für die gleiche Stückzahl deutlich weniger [1].
Was frühe Tester berichten
Meta lässt in seinem Beitrag fünf Partner zu Wort kommen. Messbare Aussagen: Cloudflare berichtet von bis zu 30 Prozent schnelleren Antworten am oberen Ende der Latenzverteilung gegenüber einem vergleichbaren Modell. You.com nennt eine p95-Latenz von 2,2 Sekunden bei eigenen Coding-Aufgaben - nach eigener Angabe vier- bis dreizehnmal schneller als führende Modelle mit offenen Gewichten, bei 36 bis 48 Prozent weniger Ausgabe-Token. Das sind Aussagen von Early-Access-Partnern in einem Meta-Beitrag, keine unabhängigen Messungen [1].
Sicherheit und Verhalten im Agenten
Vor der Veröffentlichung hat Meta das Modell nach eigenen Angaben unter seinem Superintelligence Scaling Framework geprüft, einschließlich Chemie-/Bio-, Cyber- und Kontrollverlust-Risiken; in allen Kategorien sei es unter den Hochrisiko-Schwellen geblieben. Zusätzlich wurde das Verhalten als Agent getestet: ob das Modell die Nutzerabsicht respektiert, mit sensiblen Informationen angemessen umgeht, versteckten Anweisungen in Webseiten, Dokumenten oder Werkzeugausgaben widersteht und vor folgenschweren Aktionen Rücksprache hält. Im hier gelesenen Sicherheitsabschnitt des Launch-Beitrags werden keine externen Prüfer benannt. Weitere Sicherheitsberichte haben wir nicht ausgewertet [1].
Einordnung und Prüfgrenzen
Muse Ember ist ein geschlossenes API-Modell; unabhängige Nachmessungen sind nur über die Schnittstelle möglich, wir haben keine durchgeführt. Sämtliche Werte stammen aus Metas Launch-Material und den dort zitierten Artificial-Analysis-Daten. Die Effizienz-These - gleiche Punktzahl wie Haiku 5.5 für etwa ein Drittel der Kosten - beruht auf geschätzten Kosten zum Listenpreis und einer bestimmten Aufgabenmischung; für die eigenen Aufgaben kann das anders aussehen, wie Metas FrontierCode-Wert zeigt. Ob es bereits unabhängige Fremdmessungen gibt, können wir nicht ausschließen [1].
Methode
Analyse auf Basis des gelesenen Launch-Beitrags von Meta (9.11.2026, mit Benchmark-Tabellen und Fußnoten), der Produktdokumentation zur Meta Model API und des Meta-Entwickler-Blogs zur Verwendung (jeweils abgerufen am 10.11.2026). Sämtliche Messwerte sind Herstellerangaben beziehungsweise vom Hersteller zitierte Drittwerte. Keine eigenen Tests.
Grenzen
Keine eigenen Tests; Muse Ember ist nur über APIs verfügbar, eine Gewichts-basierte unabhängige Prüfung ist nicht möglich. Alle Benchmark- und Kostenwerte stammen von Meta beziehungsweise aus von Meta zitierten Artificial-Analysis-Rohdaten (Stand 9.11.2026); die Kosten pro Aufgabe sind Schätzungen zum Listenpreis. Partner-Aussagen stammen aus Metas Launch-Beitrag. Ob es unabhängige Fremdmessungen gibt, können wir nicht ausschließen.
Quellen
- Introducing Our Smallest, Most Efficient Model: Muse Ember (Launch-Beitrag, 9.11.2026), Meta (Meta Superintelligence Labs) (abgerufen 2026-11-10) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Muse Ember - Meta Model API (Produktdokumentation), Meta (Entwicklerdokumentation) (abgerufen 2026-11-10) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Start building with Muse Ember (Entwickler-Blog, 9.11.2026), Meta (Entwicklerdokumentation) (abgerufen 2026-11-10) ↩1 ↩2