 KI
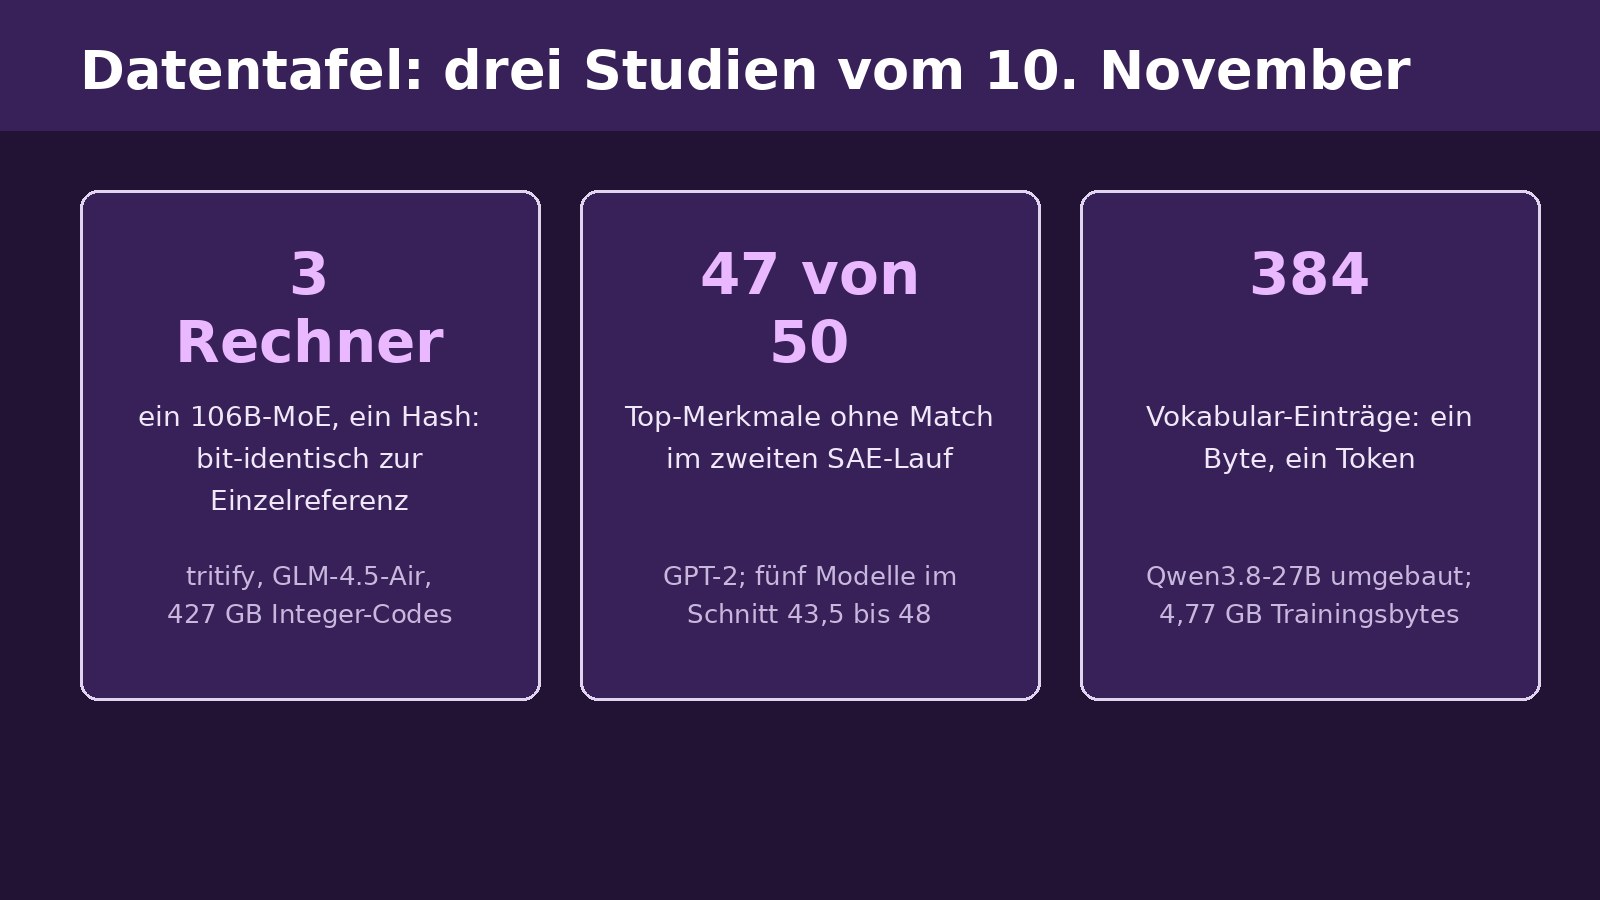
Morgenüberblick vom 12. November 2026. Quellenstand der Studien: 06:43 Uhr MEZ; ergänzender Artefaktabgleich: 06:49 Uhr MEZ. Drei Preprints vom 10. November: eine exakt-ganzzahlige Inferenzlaufzeit mit verteilter Verifikation, eine NeurIPS-2026-Analyse, die massive Aktivierungen als Konfounder beider SAE-Standardmetriken ausweist, und die Patching-freie Umwandlung eines 27B-Subword-Modells in ein Byte-Modell mit selbsterzeugten Trainingsdaten. Alle Messwerte sind Angaben der jeweiligen Autoren, keine unabhängige Replikation durch unsere Redaktion.
tritify: Exakte Ganzzahl statt Vertrauensvorschuss
Laut der jeweiligen Studie: Sayed Amir Karim (Pelloran Inc.) quantisiert Gewichte einmalig zu Festkomma-Integern, Aktivierungen dynamisch pro Tensor, und führt den kompletten Datenpfad (MatMul-Akkumulation, Requantisierung, Residuen, Normierungs- und Attention-Skalen, GELU/Softmax als Integer-Tabellen, isqrt statt sqrt) ohne Gleitkomma zur Laufzeit aus. Claim 1, Cross-Hardware-Reproduzierbarkeit: bit-identische Ausgabe über CPU-ISAs und CPU/GPU, getragen von reproduzierendem SHA-256. Claim 2, Entscheidungstreue: 509/512 Argmax-Treffer auf einer 512-Token-Probe von Qwen2.5-0.5B (drei Near-Ties); per-Schicht-Kosinus über sechzehn Schichten von OLMoE-1B-7B und GLM-4.5-Air median >0,999, schlechteste Probe 0,97; SAM-2.1-Maske IoU = 1,000. Claim 3, Ortsunabhängigkeit: GLM-4.5-Air (106.852.251.264 Parameter, 427 GB Integer-Codes) lief über drei Rechner, keiner mit vollem RAM-Bestand, bit-identisch zum Einzelhost, der Experten von Platte streamt; ein zweiter Lauf über sechs Maschinen, zwei ISAs, drei Standorte, identischer Hash. Bonus: Das MoE-Routing wird als deterministische, byte-reproduzierbare Funktion beobachtbar (OLMoE 64 Experten, Qwen3-30B-A3B 128).
Explizite Nicht-Claims: kein Tempo- oder Durchsatzgewinn (Verteilung addiert Latenz, der Gewinn ist Kapazität plus Verifizierbarkeit); keine Bit-Gleichheit der Float-Zwischenwerte (deklarierte Requantisierungs-Toleranz); keine Schedule-Invarianz (dynamische Per-Tensor-Quantisierung, gemessen an Qwen2.5-0.5B; Barrys detllm erreicht sie mit statischem Scaling); GPU-Bit-Identität im Preprint nur für das ternäre GEMM auf Apple M3 Metal; volle 46-Schicht-Antwort nicht gegen ein Float-Modell verglichen (kein Knoten hält GLM-4.5-Air in fp32); Verifizierbarkeit ist keine Vertraulichkeit; Schutz gegen aktiv betrügende Server ist Zukunftsarbeit. Validiert auf dichten 0,5B-1,5B-LMs, OLMoE-1B-7B, SAM 2.1 base-plus und GLM-4.5-Air. Code: github.com/pelloran-inc/tritify (Preprint, Artefakt-Hashes bei Release). Das aktuell gelesene öffentliche tritify-Repository nennt inzwischen Ganzmodell-GPU-Vergleiche für Qwen2.5-0.5B. Den großen GLM-Lauf kennzeichnet es dagegen als Pelloran-Vergleichsbericht mit separater kommerzieller Orchestrierung: Allein aus diesem Repository lässt er sich nicht wiederholen. Wir haben keinen dieser Läufe selbst reproduziert.
Massive Aktivierungen konfundieren SAE-Metriken
Laut der jeweiligen Studie: Delisle und Tan (NeurIPS 2026) messen an GPT-2, Pythia 70M/160M/1.4B/6.9B, Qwen-2.5-7B, Llama-3.1-8B/70B und Gemma-2-2B/9B (mittlerer Block, 5M WikiText-103-Tokens, TopK, k=64): Wo PC1 mindestens 93 Prozent der Varianz trägt, sind die 50 wichtigsten Merkmale (Ablations-ΔCE) schlechter reproduzierbar als das ganze Wörterbuch; in fünf Modellen matchen im Schnitt nur 5 bis 11 Prozent (wörterbuchweit 47 bis 63), 43,5 bis 48 der 50 haben kein Gegenstück (Zufall: 19 bis 27), Pearson r = -0,93 gegen die PC1-Dominanz. Ursache: Unter TopK hat ein isoliertes Rang-1-Signal unendlich viele exakte Zerlegungen; jeder Seed kachelt PC1 anders, und die Kacheln dominieren die Wichtigkeit, weil sich ihre Anteile außerhalb von PC1 gegenseitig aufheben. Die erklärte Varianz leidet mit: Qwen-2.5-7B-SAEs melden 99,96 Prozent Gesamtvarianz und lassen 33,0 Prozent der Inhaltsvarianz unerklärt; der Meldewert unterschätzt den Inhaltsfehler um bis zu Faktor 890 (Näherung FVU_content/FVU_total ≈ 1/(1-w1), auf allen Modellen bis auf 0,2 Prozent genau). Auch Gemma Scope 2 zeigt den Effekt (Faktor 2,1).
Fixes: Eine β||z||1-Magnituden-Strafe hebt bei GPT-2, Block 6 (TopK, fünf Seeds), die Top-50-Sharing-Rate von 6,4 auf 94,9 Prozent bei <1 Prozent Änderung an Sparsamkeit/Rekonstruktion. Der PC1-Bypass (Training ohne PC1-Projektion, Rückaddition bei Inferenz) hebt sie auf 73 bis 99,5 Prozent; die zehn wichtigsten Merkmale teilen sich mit 1,4- bis 2,0-facher Wörterbuchrate; bis zu 44 Prozent weniger Splice-Degradation und bis zu 33,9 Prozent weniger Inhaltsfehler (Qwen-2.5-7B) bei gleicher Sparsamkeit; post-hoc-Ausschluss PC1-alignierter Merkmale aus der Rangliste ohne Neutraining. ReLU+ℓ1 zeigt die Umkehrung nicht, TopK/BatchTopK/JumpReLU schon. Scope: Inversion verschwindet in Pythia-1.4B-Letztschicht; Llama-3.1-8B-Dominanz sinkt ohne erste Position von 97 auf 3 Prozent, Qwen-2.5-7B bleibt bei 99,7; wörterbuchweites Sharing bleibt 44 bis 68 Prozent. Code und SAEs: github.com/nathandelisle/massive-saes.
Byteify: Subword-Modell ohne Patching zu Bytes
Laut der jeweiligen Studie: Liwei Zhang und ZhiMing Tong schrumpfen das Vokabular von Qwen3.8-27B (48 Gated-DeltaNet- plus 16 Full-Attention-Schichten, natives MTP) von 248.320 Tabellenzeilen auf 384 Einträge; die 256 Byte-Symbole stehen bereits in der Byte-Level-BPE-Tabelle (GPT-2-Stil), es braucht keinen Initialisierungstrick, bei der Initialisierung bleiben die übrigen Gewichte unverändert; anschließend wird das ganze Sprachmodell weitertrainiert, die gesamte Schwierigkeit wandert ins Weitertraining. Das läuft in zwei Stufen (M1 Kodieren, M2 Lesen, Grenze bei 1,143 GB) auf 4,77 GB überwachten Bytes, 178,6 Stunden auf 8xH200; Dialog- und Verhaltenssupervision erzeugt das Ausgangsmodell on-policy selbst, Die separat untersuchte Nachtrainingskette behandelt Wiederholungen mit längennormiertem DPO. Im Held-out-bpb landen alle vier Domänen leicht unter dem Original (zh 0,742 vs 0,778, zh_ood 0,997 vs 1,022, en 0,549 vs 0,587, code 0,190 vs 0,205); die Autoren warnen selbst: Das Held-out-Set stammt aus LD3s eigener Verteilung, das ist kein Stärkebeweis, nur die Rückkehr auf das Ausgangsniveau. Die 384 Einträge bedeuten nicht 384 verschiedene Bytes: Es sind 256 Byte-Symbole, 35 benannte Spezialtokens und 93 reservierte Platzhalter. 248.320 bezeichnet die ursprüngliche Tabellengröße; der eigentliche BPE-Tokenbestand umfasst laut Studie 248.077 Einträge. 54 Prozent der überwachten Trainingsbytes sind menschlich geschriebener Wikipedia-Text, nicht selbstgenerierte Dialoge. DPO gehört zur getrennten Nachtrainingskette und nicht zum LD3-base-Vergleich der Haupttabelle. Durch die kleineren Ein-/Ausgabetabellen sinkt der Sprachmodellteil von 26,9 auf 24,4 Milliarden Parameter; 27B bezeichnet hier das Ausgangsmodell. Die Benchmarks stammen aus einem Seed und einem Lauf; die Bootstrap-Intervalle erfassen Aufgabenstichproben, nicht die Zufälligkeit des Decodierens.
Tabelle 1 (gleiche RTX 6000 Ada 48G, gleicher Stack): Non-Thinking GSM8K -0,4, MATH-500 +0,8, HumanEval+ -2,5, MMLU-Pro -1,3 (vier von sieben innerhalb ±2,5), C-Eval -4,7, IFEval -4,1 bis -6,2; Thinking MATH-500 +1,4, IFEval +0,2 bis +0,6, GSM8K -4,0, C-Eval -4,5; ein Teil der Non-Thinking-IFEval-Lücke ist fehlendem Instruction-Tuning zuzuschreiben (nicht experimentell getrennt). Zeichenebene (non-thinking, Makro über Suiten): CUTE +8,8, EXECUTE-zho +12,2, eigene chinesische Suite +9,7; Lookup-Wissen (Aussprache, Strichzahl) fällt und kehrt mit Thinking nicht zurück. Rezitation von 12.126 Zeichen: LD3-base 1 Fehler, Original 3, beide null ungültige UTF-8. Kosten: gleiche Schrittzeit, aber 3- bis 5-mal weniger Output pro Schritt; chinesische Zeichen/s auf 1/4; Prefill bei 64K Bytes 6,5-mal langsamer; Draft Head als Abhilfe passt nicht auf eine 48G-GPU. Fehlerbilder mit Fixes: Greedy-Runaway, UTF-8-Bruch durch byteweises Sampling, wirkungslose Penalties auf kleinem Vokabular, Denkschleifen. Release-Status: Eval-Skripte und Zeichensuite öffentlich (huggingface.co/datasets/leiwhere/ld3-byte-eval), Gewichte und Korpus derzeit nicht veröffentlicht.
Quellen
- Deterministic, Reproducible Inference in Exact Integer Arithmetic, and Verifiable Distributed Inference as Its Consequence, arXiv (Sayed Amir Karim; Pelloran Inc.) (abgerufen 2026-11-12)
- Massive Activations Confound Sparse Autoencoders, arXiv / NeurIPS 2026 (Nathan Delisle, Chenhao Tan) (abgerufen 2026-11-12)
- One Byte, One Token: Byteifying a 27B Hybrid-Attention LLM with Self-Generated Data, arXiv (Liwei Zhang, ZhiMing Tong) (abgerufen 2026-11-12)
- tritify: aktuelles öffentliches Repository und Artefaktgrenzen, Pelloran Inc. / GitHub (abgerufen 2026-11-12)
- massive-saes: Code und gespeicherte Ergebnisse, Nathan Delisle / GitHub (abgerufen 2026-11-12)
- LD3-byte-eval: Evaluationsskripte und Zeichensuite, leiwhere / Hugging Face (abgerufen 2026-11-12)