 KI
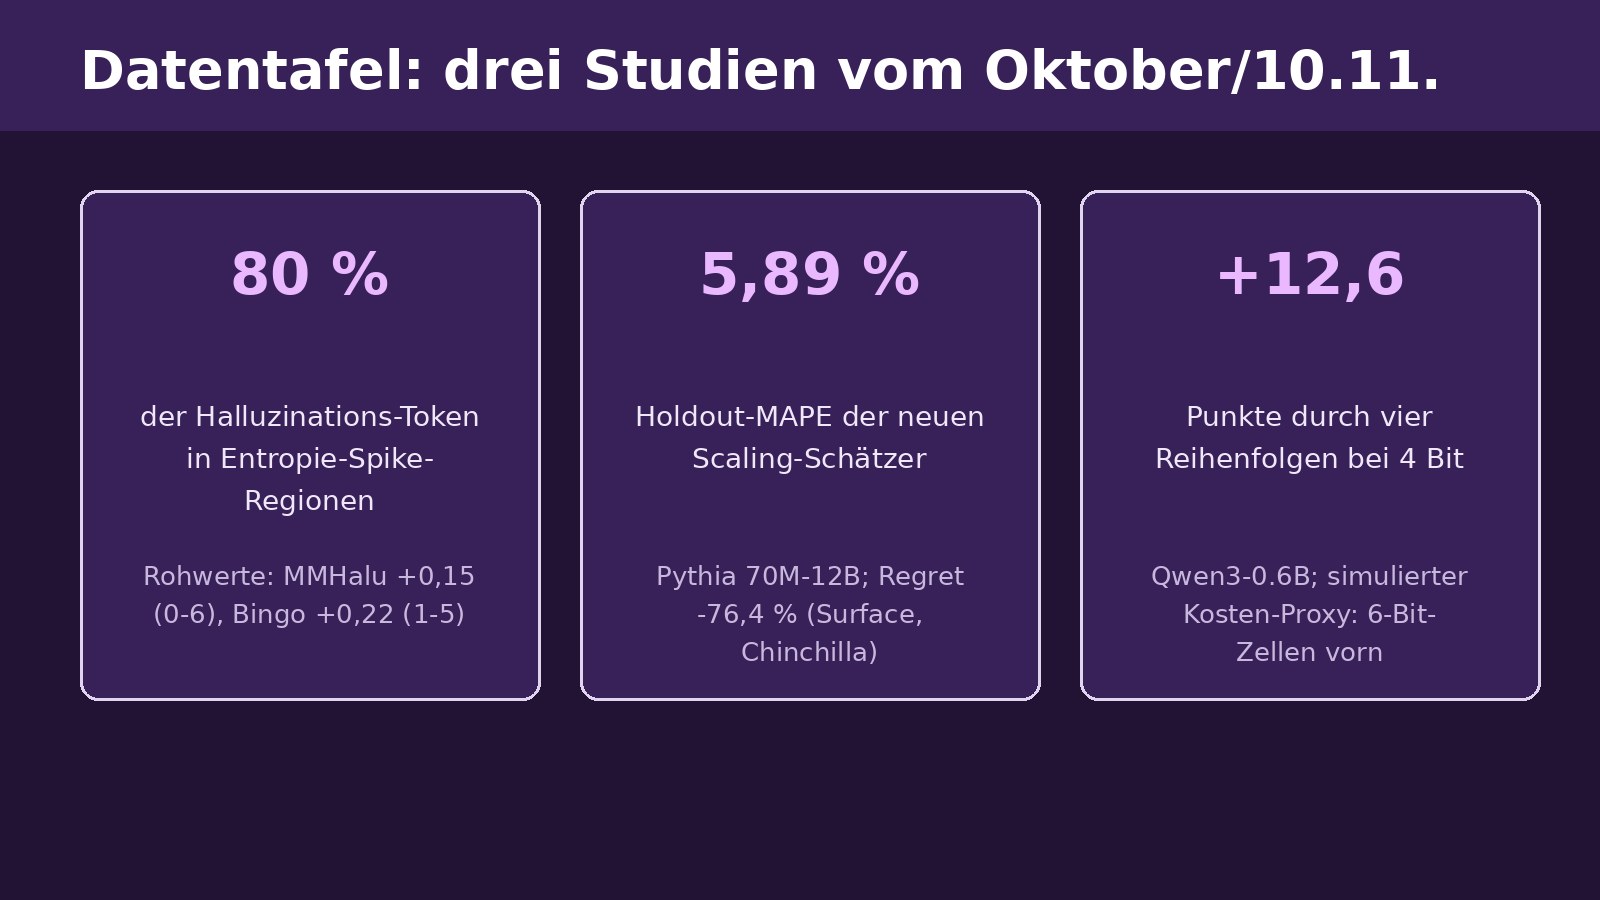
Fachüberblick vom 12. November, Quellenstand 16:02 Uhr MEZ. Drei Preprints: trainingsfreie latente Verfeinerung gegen Halluzinationen in multimodalen Diffusionsmodellen, eine pre-asymptotische Analyse neuronaler Skalengesetze und ein kostengematchter Vergleich von Gewichtspräzision und Options-Reihenfolgen-Mittelung.
1. StepRefine: Verfeinerung nur an Entropie-Spitzen
Zhongxing Xu, Zhonghua Wang u.a. (Monash, Cornell, UCSC, Northeastern, UMN) analysieren Denoising-Trajektorien multimodaler Diffusions-LMs: Die mittlere Masken-Entropie fällt nicht monoton; wenige Schritte zeigen scharfe Spitzen (Kriterium: Entropie-Änderung über lokalem Mittel plus einer Standardabweichung). Ca. 80 % der halluzinierten Token liegen in den Spike-Regionen; die Spitzen konzentrieren sich auf die erste Schritthälfte (71 % bei LLaDA-V, 62 % bei Dream-VL). StepRefine detektiert Spike-Schritte online und ersetzt dort das diskrete Token-Commit durch k latente Verfeinerungsrunden mit wahrscheinlichkeitsgewichteten Embeddings und einem Refinement-Controller; die Runden werden gegen das Restbudget gebucht und ersetzen spätere Schritte, sodass die Zahl der Forward-Passes unter diesem Dekodierschrittbudget konstant bleibt. Setup: Generierungslänge 256, 256 Denoising-Schritte, Low-Confidence-Remasking, Stabilitätsschwelle 0,01.
Die Autoren testen vier Backbones (LLaDA-V-8B, LLaDA-O-8B, Dream-VL-7B, LaViDa-L-8B) auf Reasoning-, Halluzinations-, Mathe- und Wissenschaftsbenchmarks. Bei LLaDA-V-8B steigt der Reasoning-Durchschnitt um rund 2,8 Prozentpunkte gegenüber der Basis. MMHalu steigt von 3,35 auf 3,50 auf einer 0-6-Skala, Bingo von 2,71 auf 2,93 auf einer 1-5-Skala. Die im Paper gedruckten +2,5/+4,4 sind somit keine Rohscore-Punkte. Ein Vergleichsbefund braucht eine Einschränkung: Auf VMCBench liegt StepRefine mit 74,4 unter WINO mit 74,7, obwohl der Fließtext einen durchgängigen Gleichstand oder Sieg behauptet. Mit Fast-dLLM auf VStar bleibt der gemeldete Speedup gegenüber der unbeschleunigten LLaDA-V-Basis nahezu gleich (8,45x ohne, 8,47x mit StepRefine; 23,21 gegenüber 23,39 Token/s). Auf diesem Vergleich steigt VStar von 52,4 auf 56,5; MMHalu mit Fast-dLLM von 3,09 auf 3,22. Die Entropie-Analyse belegt eine Korrelation, keine alleinige Ursache von Halluzinationen. Wir haben die Experimente nicht selbst reproduziert.
2. Skalengesetze jenseits der log-linearen Front
Zhao und Ren (LingQiong AI Lab) zerlegen endliche Abweichungen vom separablen Potenzgesetz in zwei Ursachen: entlang der Kapazitätsachse konkurrierende Spektralmodi (dreigliedrige Mellin-Barnes-Entwicklung der Kovarianz-Resolvente, erzeugt Krümmung und logarithmische Übergänge) und entlang der Datenachse unterschiedlich schnell sättigende Domänen (KKT-Dualität reduziert die K-Domänen-Mischung auf skalares Waterfilling mit Bottleneck-Schranken und Online-Curriculum). Auf der Iso-Compute-Front C = 6ND driftet der optimale Allokations-Exponent proportional zur Varianz der Kapazitäts- und Datenexponenten; eine Schur-Komplement-Reduktion trennt diesen intrinsischen Drift vom Bias eingefrorener Hyperparameter (Lernrate, Batchgröße, Warmup), der den geschätzten Kapazitätsexponenten nach oben verziehen kann.
Empirie (Autorenangaben): 45 Operatoren-Spektren; Pythia 70M bis 12B: Holdout-MAPE des LAMBADA-Log-Perplexitätsverlusts 5,89 % (Deduped-Split 10,22 %); Chinchilla-Archiv mit 245 Läufen: Allokations-Regret gesenkt um 56,8 % (Frontier-Maß) und 76,4 % (Surface-Maß) ; RegMix: Bei 17 Trainings- und 13 Validierungsdomänen sinkt der Domain-Mean-RMSE auf dem 1M-Holdout um 59,4 % gegenüber linearer Ridge-Regression; separat null Selektions-Regret im 64-Mischungen-Kandidatenpool bei 1B. Verfahrenspraxis: Aitken-Differenzierung erster Ordnung eliminiert den Loss-Floor-Parameter und liefert einen geschlossenen Initialisierer; auf engem Pilot-Log-Intervall sind Multi-Power-Jacobis wegen Vandermonde-Kollinearität nahezu rangdefizit, mehr Checkpoints im selben Intervall lösen das Identifizierbarkeitsproblem nicht automatisch. Grenzen: einzelne Laborschrift mit Hilbert-Raum-/Resolventen-Annahmen und lokaler quadratischer Fisher-Reduktion, Code und numerische Ergebnisse von uns nicht reproduziert. Die Regret-Zahlen sind verschiedene Verfahren und Auswahlprotokolle: 56,8 % betreffen das getrimmte Potenzgesetz beim Frontier-Matching (0,0909 auf 0,0393 nats); 76,4 % den log-quadratischen Fit bei Surface-Auswahl (0,0289 auf 0,0068 nats). Die Verlustschwelle L <= 3,15 entfernt hochverlustige Pilotläufe. Das Archiv enthält keine Lernratenpläne; der Filter beweist deshalb keinen konkreten Hyperparameterfehler. Es sind retrospektive Kandidatenpool-Auswertungen, keine direkt gemessenen Trainingskosteneinsparungen.
3. Bits oder Permutationen bei fixem Inferenzbudget
Khan, L und Misri (Intel) untersuchen die Interaktion von Gewichtsquantisierung und Optionsreihenfolge-Sensitivität: Qwen3-0.6B und Qwen3-1.7B (fixierte Revisionen), simulierte Round-to-nearest-Quantisierung auf 8/6/4/3 Bit (eine fp16-Skala pro 64 Gewichte, fp16-Referenz), Antworten aus den Logits der Buchstaben A bis D auf ARC-Easy, ARC-Challenge, MMLU, HellaSwag (300 Items je Task und Modell, 1.200 pro Modell), acht Optionsreihenfolgen, paarweise 95-%-Bootstrap-Intervalle; eine Gauß-Rausch-Kontrolle mit gleicher gruppenweiser SNR soll Rundungs- von Fehlerleistungseffekten trennen, bleibt aber uneindeutig. Resultate: 6 Bit verlieren keine Accuracy (+1,8 [+1,0; +2,5] und +0,9 [+0,3; +1,5] Punkte gegenüber fp16, unerklärt, ausdrücklich nicht als Verbesserung behauptet) bei nominal 0,39 fp16-Pässen im vereinfachten Proxy; 8 Bit: -0,7 und -0,4 Punkte. Bei 4 Bit steigt der Slot-Skew von 0,15 auf 0,53 (0.6B) bzw. 0,07 auf 0,12 (1.7B); die Rauschkontrolle liefert 0,15/0,37 (zwei Draws) und 0,19 (ein Draw), die Frage, ob Runden über reine Fehlerleistung hinaus Slot-Bias erzeugt, bleibt offen. Flip-Raten steigen, bleiben aber unter einer accuracy-gematchten Uniform-Fehler-Baseline (Exzess -5,1 und -5,3 Punkte), also kein Überschuss-Flip nachweisbar (schwacher Test).
Kostenrechnung: gelesene Gewichtsbytes mal Durchläufe, normiert auf einen fp16-Pass. Vier zyklische Orders mitteln +12,6 Punkte bei 4 Bit (0.6B; +5,3 bei fp16; 1.7B: +4,9 bei 4 Bit, +3,8 bei fp16). In den annähernd kostengematchten Paaren (Kostenverhältnis 0,53 bis 1,06) gewinnen Extra-Orders 2 von 10 Vergleichen pro Modell, stets gegen 8- oder 6-Bit-Zellen; mehr Bits gewinnen 7 von 10 gegen 4- oder 3-Bit-Zellen. Die Accuracy-Kosten-Front beider Modelle: 6-Bit-Zellen mit K = 1 bis 4 Orders plus die billigsten 3-/4-Bit-Einzelpässe; Entscheidungsregel: 6-Bit-Gewichte, Restbudget in bis zu vier Orders à ein Pass. Limitationen: zwei kleine Modelle, einfachster Quantisierer (bessere verlieren bei 3/4 Bit weniger), ein Prompt-Format, vier Benchmarks, nur Buchstaben-Logits; Qwen3-4B wegen GPU-Speicher nicht gelaufen. Die Kostenwährung ist ausdrücklich ein vereinfachter Proxy, keine Zeit- oder Energie-Messung. Die Gewichte werden gerundet und wieder in fp16 berechnet; es laufen keine gepackten Low-Bit-Kernel. Embeddings und Ausgabematrix bleiben fp16. Wenn die ganze Matrix gelesen wird, steigt der angesetzte 6-Bit-Preis von 0,39 auf 0,55 beziehungsweise 0,50 fp16-Pässe (0.6B/1.7B). Aktivierungsverkehr, Dequantisierung, Batching und geteilte Präfixe fehlen ebenfalls. Die Schwellen und Empfehlung hängen also vom Proxy und diesem Testprotokoll ab.
Quellen
- Rethinking in Spikes: Mitigating Hallucinations in MDLMs with Step-Aware Decoding, arXiv (Zhongxing Xu, Zhonghua Wang u.a.; Monash University, Cornell, UC Santa Cruz, Northeastern, University of Minnesota) (abgerufen 2026-11-12)
- Beyond the Log-Linear Frontier: Pre-Asymptotic Analysis of Finite-Budget Neural Scaling Laws, arXiv (Tianyu Zhao, Zhixiang Ren; LingQiong AI Lab, Shanghai Smart Logic Technology) (abgerufen 2026-11-12)
- Bits or permutations? Spending a fixed inference budget on weight precision or on option-order averaging in small local language models, arXiv (Mohammed Nayeem Khan, Logesh L, Aliyas Ahmad Misri; Intel Corporation) (abgerufen 2026-11-12)