 KI
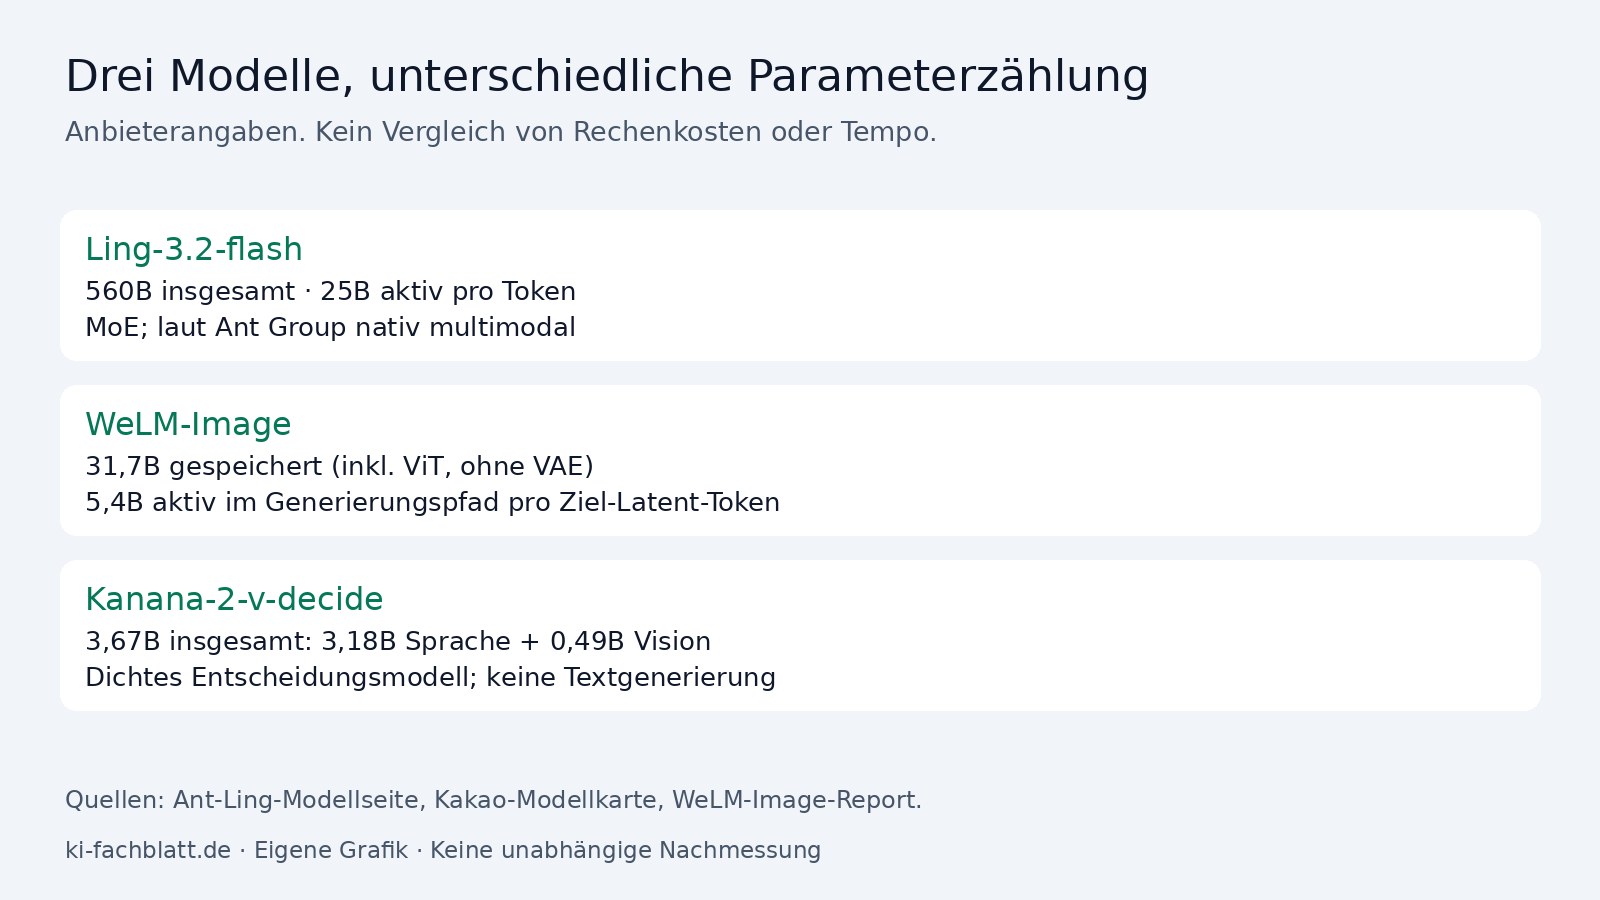
Mittagsüberblick vom 6. November 2026. Quellenstand: 10:00 Uhr MEZ. Drei multimodale Veröffentlichungen, drei Bereitstellungsmodelle: Plattform-API (Ant Group), offene Gewichte mit kommerziellen Klauseln (Kakao) und ein technischer Report ohne von uns gefundenen Release-Verweis (Tencent).
Ling-3.2-flash: native Multimodalität im 560B-A25B-Rahmen
Laut Plattform-Changelog startete Ling-3.2-flash am 5. November: 560 Milliarden Parameter, 25 Milliarden aktiviert, 1M Kontext, native Eingabe von Bild, Text und Video. Die Modellseite nennt vier Schwerpunkte: Complex Visual Understanding, Multimodal Long-Horizon Agent, 3D Understanding & Interaction und Medical Multimodal. Der Zugriff läuft über Chat und eine API, die kompatibel zu OpenAI- und Anthropic-Protokollen sein soll. Die Ling-Reihe wirbt generell mit Open-Source; für 3.2-flash haben wir auf Hugging Face jedoch bis zum Quellenstand keine Gewichte gefunden, anders als beim Vorgänger 3.1-flash (mit verfügbaren Gewichten).
Architektonisch bleibt 3.2-flash beim sparsamen MoE-Raster der Reihe (25 von 560 Milliarden aktiv). Die Positionierung richtet sich gegen die multimodalen Frontier-Modelle; die medizinische Ausrichtung und 3D-Fähigkeiten sind im Segment ungewöhnlich explizit. Wir haben die Leistungsangaben nicht unabhängig nachgemessen.
Kanana-2-v-decide: System-1-Inferenz als Embedding-Vergleich
Kakaos kanana-2-v-decide-3b-2611 (Gewichte laut Karte seit heute) ist ein Entscheidungsmodell auf Basis von Kanana-2-v-3b (3,18B Sprachmodell + 0,49B Vision-Encoder). Jede Frage wird gemeinsam mit dem Zustand (Text, JSON oder Chat-Verlauf plus bis zu zehn Bilder, bis 20.480 Token) zu einem Embedding kodiert, jede Antwortoption zu einem zweiten; eine Softmax über die Kosinus-Ähnlichkeiten liefert die Antwortverteilung. Optionen-Embeddings werden tokenbasiert gecacht. Fragetypen: choice (Mapping mit Beschreibungen), noul (Wahrscheinlichkeit für wahr) und score (2-10 geordnete Stufen). Die Karte betont: Wahrscheinlichkeiten sind relativ zu den mitgelieferten Optionen; Temperatur flacht die Verteilung ab. Serving per Transformers-Custom-Code oder Stdlib-HTTP-Server mit System-One-API.
Benchmarks laut Karte: Decision Index 61,34, Decision Index Vision 61,12 (Schnitt 61,23, bester der vier verglichenen Modelle), hauseigener koreanischer Kanana Decision Bench 72,50 (15.909 Fragen, 18 Punkte vor StartLux-Decision). Anbietervergleich ohne unabhängige Nachmessung. Lizenz: Abschnitt 4.1 der Kanana Open License verlangt eine gesonderte kommerzielle Lizenz für Angebote an Dritte über API, Cloud oder andere Fernzugriffe, als SI-/On-Premise-Lösung oder eingebettet auf Geräten. Eigene Dienste sind nach 4.2 ohne gesonderte kommerzielle Lizenz erlaubt, soweit sie nicht unter 4.1 fallen. Bei Weiterverteilung gelten unter anderem "Powered by Kanana" und ein Kanana-Präfix für damit oder mit Outputs trainierte und verbreitete Modelle. Kakao beansprucht laut Abschnitt 5 selbst keine Outputrechte; mögliche Rechte Dritter sind damit nicht geklärt.
WeLM-Image: MoT-MoE für Verstehen und Generierung
Der arXiv-Report 2611.07392 (5. November, WeChat Vision, Tencent) beschreibt ein einheitliches Bild-Foundation-Modell: Text-, Referenz- und Ziel-Latents als eine Sequenz; ein Mixture-of-Transformers-Rückgrat mit geteilter Attention, aber unabhängigen Verstehens- und Generierungsparametern; beide Pfade mit MoE-Modulen. 31,7B gespeicherte Parameter (inkl. ViT, ohne VAE), rund 5,4B aktive Generierungsparameter pro Ziel-Latent-Token. Training progressiv bis native 1,5K-Auflösung, getrennte Rubrik-/Checklisten-Rewards für Generierung und Editing, konsolidiert per Noise-aware On-Policy-Distillation. In den berichteten Gesamtvergleichen liegt das 1536er-Modell auf PRISM-Bench, Qwen-Image-Bench und UnicBench vorn - jeweils 'unter den evaluierten Open-Source-Modellen', eine Selbsteinschätzung im eigenen Aufbau.
MeanFlow-Few-Step-Distillation liefert WeLM-Image-Turbo: 1024x1024 in 4,98 Sekunden auf einer einzelnen H20 mit acht guidance-freien Schritten. Designtreiber war laut Report der Ein-GPU-Betrieb in WeChats Consumer-Anwendungen. In den hier geprüften Quellen fanden wir keinen Verweis auf veröffentlichte Gewichte oder Code.
Quellen
- Ant Ling Plattform: Changelog (Launch Ling-3.2-flash, 5.11.), Ant Group (abgerufen 2026-11-06)
- Ant Ling Plattform: Models / Ling, Ant Group (abgerufen 2026-11-06)
- kakaocorp/kanana-2-v-decide-3b-2611 (Modellkarte), Kakao / Hugging Face (abgerufen 2026-11-06)
- Kanana Open License Agreement (Lizenztext), Kakao / Hugging Face (abgerufen 2026-11-06)
- WeLM-Image: A Unified Image Generation Model towards Visual Intelligence (arXiv 2611.07392), Tencent WeChat Vision / arXiv (abgerufen 2026-11-06)
- Ling-3.1-flash: Vorgänger mit verfügbaren Gewichten, inclusionAI / Hugging Face (abgerufen 2026-11-06)
- WeLM-Image: Volltext, Architektur und Parameterzählung, Tencent / arXiv (abgerufen 2026-11-06)