 KI
Mittagsüberblick vom 11. November 2026. Quellenstand: 09:52 Uhr MEZ. Diese Ausgabe bündelt drei Arbeiten zum effizienten Betrieb von LLM-Systemen: die Kompilierung von Agentenläufen in feste Workflows, eine kostengünstige Kontrollebene für Erfahrungswiederverwendung und eine Neuronen-Analyse von MoE-Modellen mit Pruning-Anwendung. Alle Quellen sind Preprints; der Quellenabgleich stützt sich auf die Originalarbeiten, wir haben die Versuche nicht selbst wiederholt. Alle Leistungs- und Kostenzahlen sind Angaben der jeweiligen Autorenteams, keine eigenen Messungen.
1. ReTrace: Workflows aus Agenten-Traces
Setup. Business-Prozesse wiederholen dasselbe SOP auf neuen Eingaben; Agenten planen dabei jeden Schritt jedes Laufs per Modellaufruf. Auf der im Paper unbenannten Produktivplattform der Autoren waren von 5.115 Kunden-Automatisierungen (April bis Juni 2026) 91,8 Prozent Laufzeit-Planer, doch sieben der zehn meistausgeführten Automatisierungen waren feste Workflows; die Schrittwahl kostete bei drei bis fünf Werkzeugen 37 bis 43 Prozent der Ausführungszeit. ReTrace extrahiert aus den Begründungen, die der Agent zu jedem Werkzeugaufruf schreibt, Bedingung, Werkzeug und Datenquellen je Schritt, aggregiert sie über Läufe hinweg zu einem Regeldokument mit Belegzitaten (unbezeugte Alternativen bleiben markiert) und generiert daraus einmalig Code beziehungsweise einen Workflow-Graphen. Zur Laufzeit ruft kein Planer mehr ein Modell; ein Werkzeug darf weiterhin intern eines nutzen. Reparaturrunden an Trainingsfehlern sind möglich, wenn das Benchmark offline wiederholbar ist.
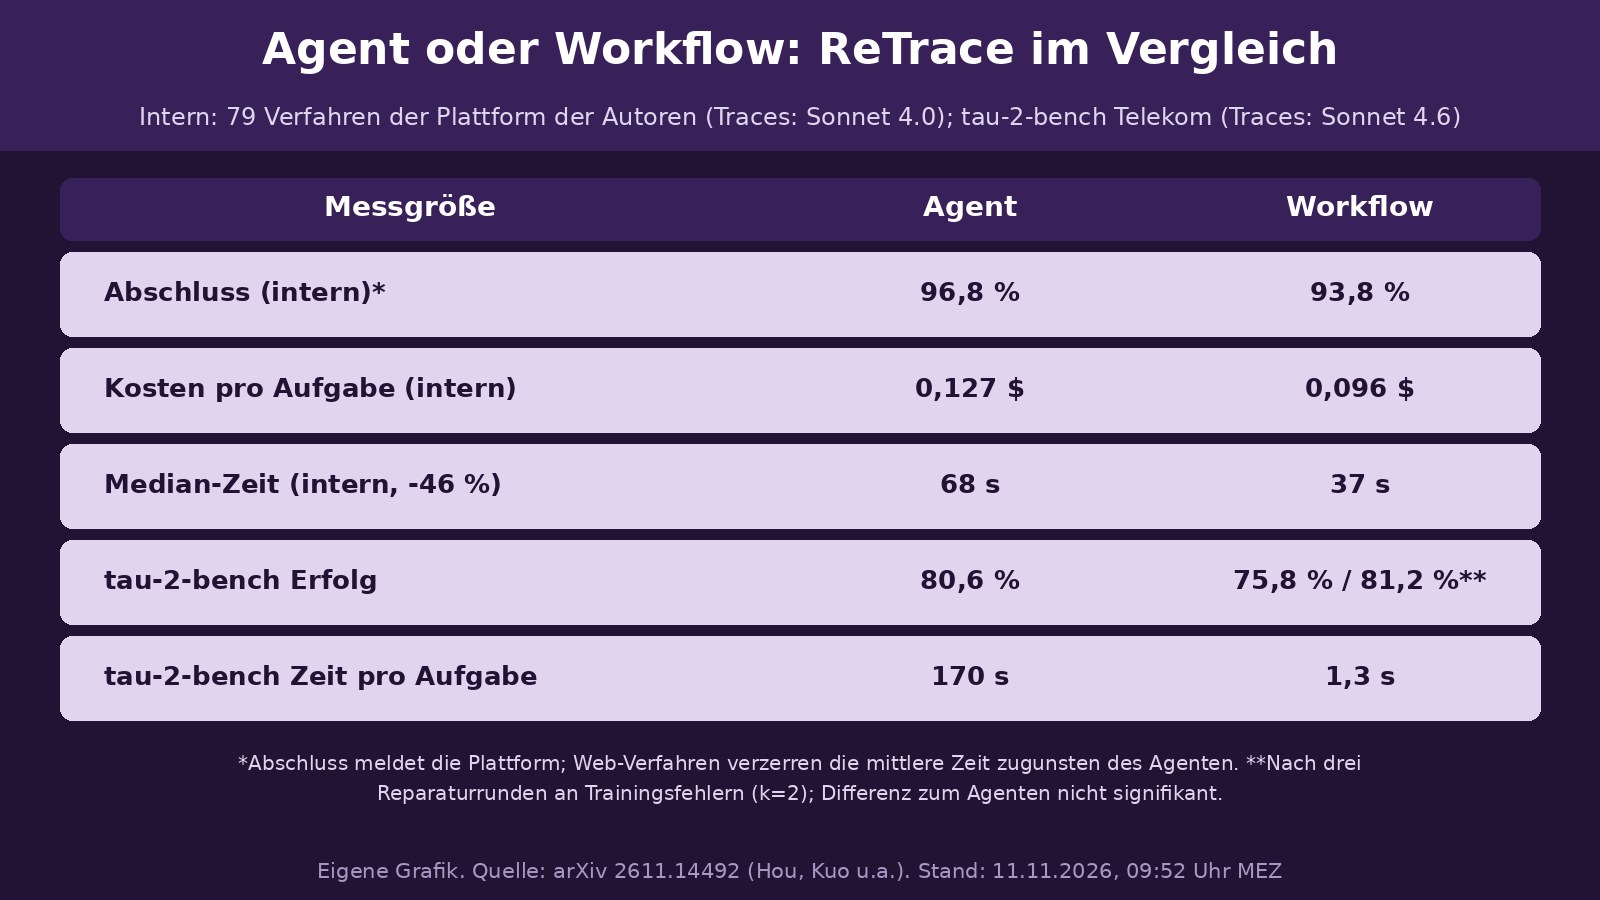
Befunde. Auf 79 nach Nutzung gezogenen Produktivverfahren: 93,8 Prozent Abschluss gegenüber 96,8 Prozent beim Agenten, Kosten pro Aufgabe 24 Prozent niedriger (0,096 gegenüber 0,127 Dollar), Medianzeit 37 statt 68 Sekunden. Die steigende mittlere Zeit erklärt sich über Web-Verfahren: Dort scheitern die Werkzeugaufrufe des Agenten zu 73 Prozent, und manche Läufe ohne erfolgreichen Aufruf gelten als abgeschlossen; ohne Web-Verfahren liegt ReTrace bei 58 gegenüber 92 Sekunden und 19 Prozent der Kosten. Auf tau-2-bench (Telekom, 74 Trainings- und 40 Testeingaben, Traces von Sonnet 4.6): 75,8 Prozent Erfolg gegenüber 80,6 beim Agenten, 1,3 statt 170 Sekunden; drei Reparaturrunden heben k=2-Workflows von 66,7 auf 81,2 Prozent (Agent 80,6, Differenz nicht signifikant). Auf acht SOP-Bench-Domänen liegt ReTrace ohne Reparatur hinter Few-Shot (80,6 gegenüber 83,6), mit Reparatur vorn (87,8 in 0,40 Sekunden gegenüber 85,5 in 46,6). Die Begründungen in den Traces tragen 6,2 (tau-2-bench) beziehungsweise 8,8 Punkte (Produktivdaten) bei, auf den kurzen SOP-Bench-Prozeduren nichts; unbezeugte Zweige sinken ohne Begründungen von 44 auf 3. Mehr vollständige Traces verschlechtern ab einem Punkt die Baurate (100 Prozent bei k=16, 31 Prozent bei k=32). Limitationen: kein Transfer auf neue Verfahren gemessen, Abschlussquoten der Plattform können Fehlläufe zählen, ein Verfahren variierte über Trace-Stichproben um bis zu 50 Punkte, Reparaturfeedback nutzt Trainingslabels. Praxisnotiz: Das generierende Modell wichtiger als das extrahierende wählen und Werkzeugergebnisse prüfen, nicht nur Abschluss-Flags.
2. Synapse-Control: Erfahrung billig steuern
Setup. Wiederherstellungssysteme wie Sentry erzeugen vor jedem Erfahrungsratschlag eine Fehlerdiagnose per Großmodell; in den Messungen der Autoren (SJTU und Ant Group) fraßen diese Hilfsaufrufe 21,4 Prozent (AppWorld) beziehungsweise 18,2 Prozent (WebShop) der Actor-Anfragezeit. Synapse-Control ersetzt das Erzeugen durch Bewerten: Regeln stellen höchstens fünf Kandidaten aus Mikroverträgen (lokale Schnittstellenfakten, keine kompletten Aufgabenprogramme), ein vollständig feinabgestimmter 1,7B-Klassifikator (Lehrerlabels eines 32B-Modells: hilfreich, unnötig, schädlich) bewertet sie gegen den sichtbaren Zustand, und eine Prompt Value Table regelt Zustellung mit Abklingzeit, 2.048-Token-Budget und einem Hinweis pro Schritt. Der Actor bleibt bei Planung und Aktion (Qwen3.5-9B, für alle Methoden gleich). Gemessen wurde auf AppWorld (168 Testaufgaben mal sechs Reihenfolgen) und WebShop (100 mal drei), zusammen 1.308 Versuche pro Methode.
Befunde. Erfolge: 270 (Synapse-Control) gegenüber 256 (Sentry) und 208 (Basis); je Benchmark 178/173/136 in AppWorld und 92/83/72 in WebShop. Die Laufzeit ersetzt 4.987 generierte Diagnoseaufrufe und halbiert die Kontrollzeit pro Versuch (minus 50,2 beziehungsweise 51,0 Prozent); die komplette Aufgabenzeit sinkt in WebShop um 21,4 Prozent gegenüber Sentry, in AppWorld um 5,0 Prozent. Pro Erfolg fallen 1,187 Millionen Eingabetoken an gegenüber 1,277 (Sentry) und 1,637 (Basis). Zulassungspräzision des Klassifikators auf zurückgehaltenen Kandidaten: 94,0 Prozent (AppWorld) und 98,15 Prozent (WebShop) bei eingefrorener Schwelle 0,90. Ablationen: Ohne Verlaufskontrolle steigen Wiederholhinweise um etwa das Dreifache; gelernte Auswahl hält 97,7 beziehungsweise 99,2 Prozent des Scores lexikalischer Auswahl bei 11,2 beziehungsweise 5,8 Prozent weniger Eingabetoken; Mikrovertrags-Fakten statt allgemeiner Prinzipien brachten in einem 318-Versuche-Probe 48,4 Prozent mehr Abschlüsse. Limitationen: ein Actor, lokale Serving-Szenarien, Lehrerlabels eines einzelnen 32B-Modells, Kalibrierung je Umgebung nötig; die Übertragung des eingefrorenen Controllers auf eine Llama-Laufzeit werten die Autoren im Anhang aus.
3. MoE jenseits der Expertengrenze
Setup. Ob MoE-Experten domänenspezialisiert sind, ist umstritten: Routing-Präferenzen sprechen dafür, Token-Identität und Syntax als Routing-Treiber dagegen. Das Team (NTU, Tencent, NUS) misst eine Ebene tiefer: RAMP gewichtet die Aktivierung eines Neurons mit Routing-Koeffizient und Ausgabeprojektionsnorm. Untersucht werden sechs offene Modelle (Qwen3-30B-A3B, Qwen3.5-35B-A3B, Qwen3.6-35B-A3B, GLM-4.7-Flash, Qwen1.5-MoE-A2.7B-Chat, OLMoE-1B-7B) Die Domänenanalyse nutzt neun Inhalts-/Aufgabenformat-Gruppen mit je 128 Texten; die spätere Pruning-Kalibrierung nutzt elf Domänen.
Befunde. Die wichtigsten Neuronensätze einer Domäne überschneiden sich über Stichproben derselben Domäne zu 58 bis 74 Prozent, über Domänen hinweg nur zu 15 bis 24 Prozent (bei 6,25 Prozent Auswahl); 66,4 bis 83,4 Prozent domänenexklusiver Neuronen konzentrieren sich in wenigen Experten, und diese Anreicherung korreliert mit Routing-Präferenzen (mediane Spearman-Korrelationen 0,37 bis 0,67). Das schlichtet den Streit: Domänenorganisation existiert auf Neuronenebene und verteilt sich über gemischte Experten. Im Training reorganisieren sich Neuronen-Rangfolgen im Pre-Training weiter (bei OLMoE 209 von 240 Übergängen trotz höchstens 5 Prozent Routing-Verschiebung), während das Post-Training sie weitgehend einfriert (mediane Korrelationen 0,997 bis 0,998; größter Schritt Base zu SFT). Anwendung: Das Pruning RAMPr hält bei 75 Prozent Neuronen 91,1 bis 97,6 Prozent der Leistung über die sechs Modelle (90 Prozent: 95,3 bis 100,8), bei 50 Prozent 83,0 bis 88,5 in vier Modellen bei zwei Ausreißern nach unten (Qwen3 61,0; GLM-4.7 66,2). Beide Fisher-Baselines liegen in allen sechs Modellen darunter; gegen REAP gewinnt die domänenbalancierte Variante auf GLM-4.7 bei 75 Prozent um 2,91 Punkte (getragen von MMLU und CMMLU), während REAP auf Qwen3 bei 50 Prozent vorn liegt (76,7 Prozent). Im gemessenen Setup (Batch 32, 2.048 Eingabetoken) sinkt bei 50 Prozent verbliebenen Neuronen der residente Speicher um 36 bis 43 Prozent und der Batched-Prefill steigt um 17 bis 39 Prozent bei praktisch unverändertem Decode; die aktiven FFN-Parameter pro Token sinken um geschätzt 32 bis 49 Prozent. Die Kalibrierung steuert, was erhalten bleibt: Bei Qwen3 (50 Prozent) heben fünf Generierungsdomänen statt elf MBPP von 4,0 auf 66,8. Limitationen: sechs Modelle, Kalibrierungsabhängigkeit, AIME wegen Nullwerten zweier Modelle aus der Makro-Wertung ausgeschlossen.
Quellen
- ReTrace: Distilling Tool-Using Agents into Planner-Free Workflows, arXiv (Hou, Kuo u.a.; Columbia University, Amazon) (abgerufen 2026-11-11)
- Synapse-Control: Making Agent Experience Actionable with Lightweight Runtime Control, arXiv (Huang, Zheng u.a.; Shanghai Jiao Tong University, Ant Group) (abgerufen 2026-11-11)
- Understanding Mixture-of-Experts Language Models Beyond Expert Boundaries, arXiv (Zhou, Zheng u.a.; NTU, Tencent, NUS) (abgerufen 2026-11-11)