 KI
Edge0 hat am 12. November 2026 Edge0-145B und Edge0-120B veröffentlicht und bezeichnet Edge0-145B als erstes quelloffenes On-Device-Modell mit 145 Milliarden Parametern [1]. Die Gewichte liegen auf Hugging Face, die zugehörige Inferenz-Engine auf GitHub [2][5]. Zwei Angaben des Herstellers verdienen eine genauere Einordnung: die Formulierung quelloffen und die Leistungsversprechen. Beides klären wir weiter unten.
Was veröffentlicht wurde
Auf Hugging Face stehen je zwei quantisierte Varianten bereit: Edge0-145B-NVFP4 und Edge0-145B-q3k sowie die entsprechenden 120B-Pendants, alle ohne Zugangsbeschränkung (Plattform-API, Stand 13.11.2026 gegen 6 Uhr UTC / 7 Uhr MEZ) [2]. Die Repositories wurden am 11. November angelegt und wiesen zum Recherchezeitpunkt null Downloads auf; ein bf16-Vollgewicht haben wir in den von uns eingesehenen Listungen nicht gefunden [2]. Das Inferenz-Framework Edge0-AI/Edge0 auf GitHub steht unter Apache 2.0 und baut nach eigenen Angaben auf der MIT-lizenzierten Strata-Engine auf, die Edge0 um Latent-MoE-Unterstützung erweitert [2][5].
Eckdaten
145 Mrd. Parameter gesamt, davon 10,12 Mrd. aktiv pro Token · 48 Schichten · 512 Experten pro Schicht (10 geroutet plus 1 geteilter Experte) · SwiGLU-Breite 640 · Kontext 256K · nativ in 4 Bit trainiert · 51,2 Mrd. Einträge umfassende N-Gramm-Einbettungstabelle in fp8, speicherabbildet (memory-mapped) · Basismodell Qwen3.8-Flash-Next (Karten-Metadaten) · Lizenz Edge0 Community Model License 1.0 [2].
Speicher: Blogversprechen und aktuelle Messbedingungen
Der Hersteller beschreibt vier zusammengreifende Maßnahmen [1]: Erstens teilen sich Gruppen von 64 Experten zwei große Matrizen; nur die Abweichungen bleiben pro Experte gespeichert, was die zu bewegende Gewichtemenge senkt. Zweitens wird das Modell von Anfang an in seiner On-Device-Architektur trainiert, statt nachträglich komprimiert zu werden. Drittens lädt die Engine gestuft: Häufig genutzte Experten bleiben im GPU-Speicher, eine Expertensammlung von etwa 40 GB liegt im Arbeitsspeicher, rund 48 GB Vokabulardaten werden bei Bedarf von der SSD gelesen. Viertens rechnen CPU und GPU parallel, und spekulative Dekodierung prüft mehrere Kandidaten-Tokens zugleich; passende Entwurfsdateien (mtp/) liegen im Repository [1][2].
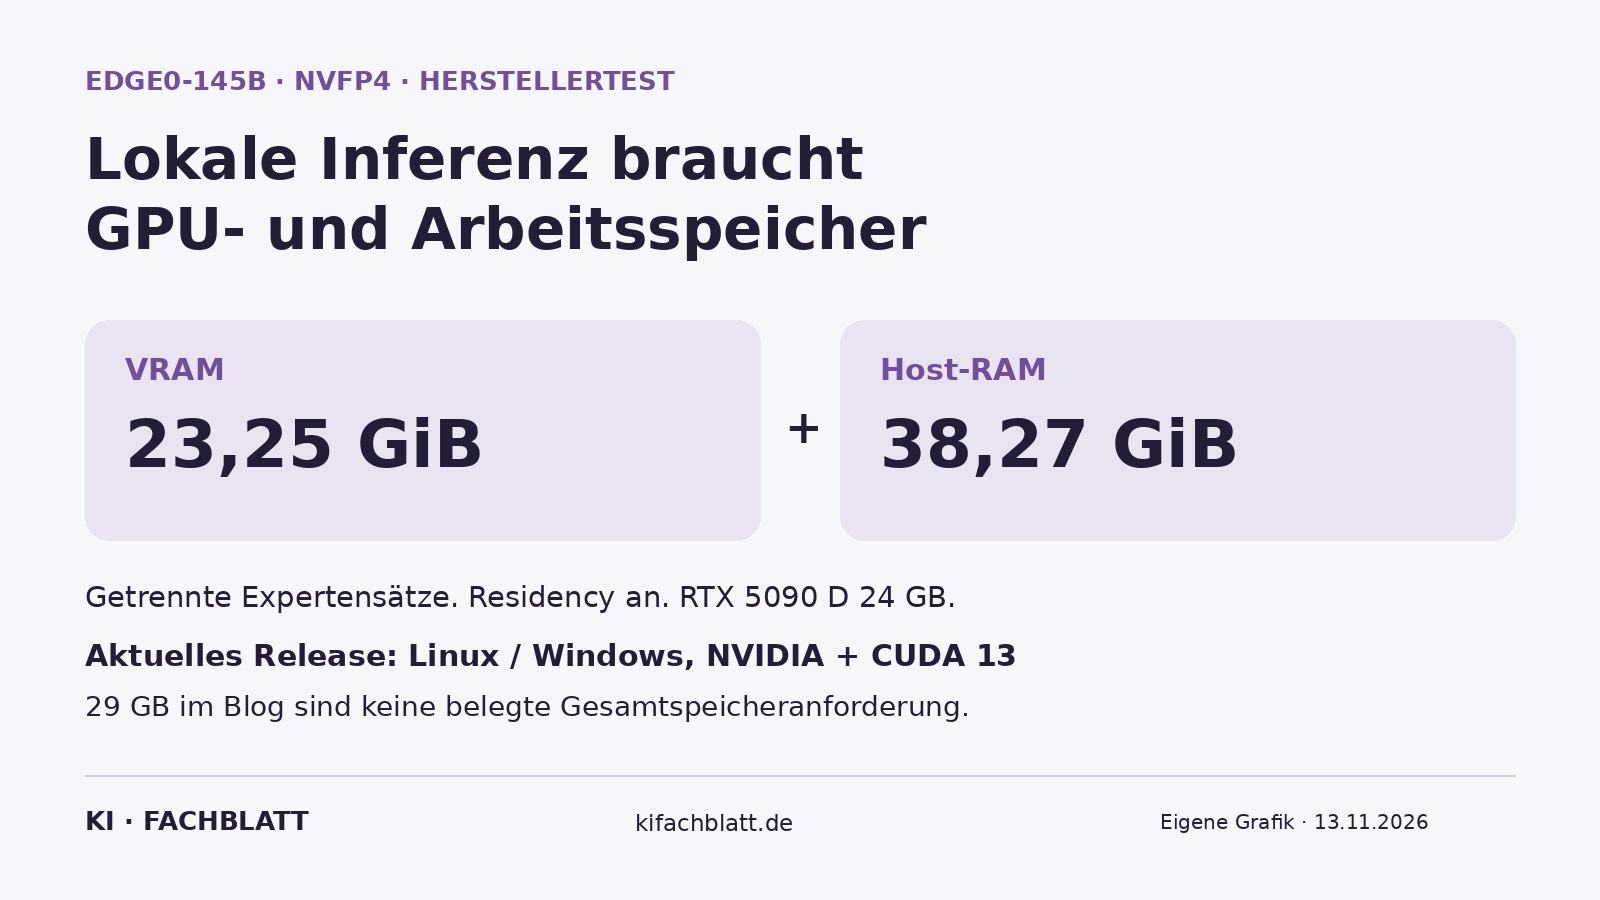
Der Ankündigungsblog nennt 29 GB Spitzenspeicher, mehr als 1.100 Token/s Prefill, über 80 Token/s Dekodierung und etwa 120 Watt [1]. Diese pauschalen Werte sind nicht mit einer Gesamtspeicheranforderung gleichzusetzen. Die aktuelle Modellkarte trennt für NVFP4 auf einer RTX 5090 D mit Residency ausdrücklich 23,25 GiB VRAM und zusätzlich 38,27 GiB Host-RAM; es handelt sich um disjunkte Expertensätze. Sie meldet 79,6 Token/s Chat, 98,3 Token/s Agent und 3.165,7 Token/s bei 16K-Prefill. Für Q3_K nennt sie 23,14 GiB VRAM plus 31,28 GiB RAM [2]. Die separat genannte Testbegrenzung auf 16 GiB VRAM und 20 GiB RAM ist keine Mindestanforderung. Sämtliche Werte stammen vom Hersteller, nicht aus eigenen Tests [2][5].
Benchmarks: interne Auswertung des Herstellers
Edge0 veröffentlicht eine Vergleichstabelle über sechs Benchmarks, darunter DeepSWE 1.1 (64,6 Punkte), Terminal-Bench 2.1 (86,52), GPQA-Diamond (90,4) und IFBench (80,6), und stellt Edge0-145B dabei vor Qwen3.8-Flash-Next und DeepSeek-V4-Flash-0731 sowie nahe an Claude-Opus-4.6 (Max) [1]. Die Werte für Edge0, Qwen, DeepSeek und Claude stammen aus Edge0s interner Auswertung; für einige weitere Tabellenmodelle verweist der Hersteller auf Drittquellen [1]. Die Speichervergleiche der Tabelle mischen gemessene Edge0-Werte mit geschätzten Basiswerten für 4-Bit-Deployments, was der Hersteller per Fußnote kenntlich macht [1]. Unabhängige Messungen haben wir in den von uns eingesehenen Quellen nicht gefunden; dass es keine gibt, können wir nicht ausschließen.
Daten als Tabelle
| Terminal-Bench 2.1 | |
|---|---|
| Edge0-145B | 86,52 |
| Qwen3.8-Flash-Next | 83,3 |
| DeepSeek-V4-Flash-0731 | 82,7 |
| Edge0-120B | 81,3 |
| Claude-Opus-4.6 (Max) | 78,2 |
Terminal-Bench 2.1 (Punkte, höher ist besser). Alle Werte aus Edge0s interner Auswertung vom 12.11.2026, von uns nicht nachgeprüft [1]. Der aktuelle GitHub-Überblick nennt für Edge0-120B abweichend 75,3 statt 81,3; die Grafik gibt ausschließlich die Blogtabelle wieder [5].
Die Lizenz: breite Erlaubnis mit kommerziellem Vorbehalt
Die Gewichte stehen nicht unter Apache 2.0 oder einer anderen Standard-Open-Source-Lizenz, sondern unter der eigens für dieses Release verfassten Edge0 Community Model License 1.0 vom 12. November 2026 (von uns am 13.11.2026 vollständig gelesen) [3]. Sie erlaubt Nutzung, Veränderung, Feintuning, Weitergabe, Forschung, die interne Nutzung in Unternehmen und die kommerzielle Nutzung von Modellausgaben, ohne Umsatz- oder Nutzergrenze (Abschnitt 3) [3].
Eine separate schriftliche Edge0-Kommerzialisierungslizenz verlangt Abschnitt 4 für Modellverkauf und kostenpflichtige Weitergabe, kommerzielle Modell-Dienste sowie unabhängige kommerzielle Coding- oder Büro-Assistenten, auch bei lokaler Inferenz. Dazu können Gebühren, Abos, Werbung und produktbezogenes Sponsoring zählen. Nicht jede kommerzielle Nutzung fällt darunter: Ausgenommen sind unter den genauen Bedingungen der Abschnitte 3/4 etwa einzelne Fachwerkzeuge, beiläufige Assistenzfunktionen eines anders ausgerichteten Produkts und reine Installationsleistungen ohne Modellverkauf. Ungebundene Spenden und belegter Kopierkostenersatz sind ebenfalls nicht automatisch entgeltliche Modellangebote. Diese Edge0-Ausnahmen setzen Qwen-Bedingungen nicht außer Kraft [3][4]. Bei Weitergabe verlangt Abschnitt 5 Lizenztexte, Herkunftshinweise und Kennzeichnung eigener Änderungen. Ausgaben unterliegen keinen zusätzlichen Edge0-Gebühren, bleiben aber an geltendes Recht, Upstream-Bedingungen und Rechte Dritter gebunden (Abschnitt 6). Bei wesentlichen Verstößen endet die Edge0-Rechteeinräumung; die erste Verletzung kann innerhalb von 30 Tagen ab Entdeckung oder Mitteilung, je nachdem was früher liegt, vollständig geheilt werden. Weitere Wiedereinsetzungen verlangen schriftliche Zustimmung (Abschnitt 9). Bereits gültige frühere Lizenzrechte werden nicht zurückgezogen [3].
Zwei Feinheiten sind wichtig: Die Lizenz gilt laut release-scope.json nur für Edge0s eigene Beiträge an diesem Release, nicht für das gesamte Modell; für die Qwen-Bestandteile gilt weiterhin die Qwen Community License 1.0, die unverändert im Repository liegt [3][4]. Und während die früheren Vorschau-Modelle Edge0-35B und Edge0-8B noch unter Apache 2.0 standen (Plattform-API), weichen die neuen Flaggschiffe auf die eigene Lizenz aus [2]. Wer Edge0-145B also quelloffen im üblichen Sinn erwartet, wird enttäuscht: Es ist eine Community-Lizenz mit klar kommerziellem Vorbehalt.
Einordnung
Das Release macht eine große sparse MoE-Architektur für lokale NVIDIA-Inferenz zugänglich. Aus dem Blogversprechen eines 48-GB-Laptops folgt aber keine pauschale Eignung konkreter Laptops. Das aktuelle Plattformraster nennt für 145B/120B Linux und Windows mit NVIDIA/CUDA 13. Eine aufgeführte Apple-M2-Ultra-Metal-Messung belegt ausdrücklich noch keine macOS-Veröffentlichung; die plattformübergreifenden Funktionen der früheren 35B-Version dürfen nicht auf 145B übertragen werden [2][5]. Ohne eigene Hardwaretests ist deshalb eine Prüfung am geplanten Gerät nötig. Ebenso reicht die Edge0-Lizenz allein nicht als Freigabe eines kommerziellen Produkts. Der separat gelesene Qwen-Lizenztext nennt eigene Bedingungen für Model-as-a-Service- und AI-Work-Assistant-Geschäfte. Die Datei release-scope.json belegt weder eine separate Qwen-Kommerzialisierungsfreigabe noch eine unabhängig verifizierte Trainingsrevision [3][4][6]. Dies ist eine Zusammenfassung der Texte, keine rechtliche Einzelfallprüfung.
Methode
Quellenabgleich am 13. November 2026 gegen 07:15 Uhr MEZ: Herstellerblog, aktuelle Modellkarte und Plattform-API, vollständige Edge0-Lizenz, release-scope.json, GitHub-README und referenzierter Qwen-Lizenztext selbst gelesen. Blog, Modellkarte und GitHub weichen bei Speicher, Plattformdarstellung und einzelnen Benchmarkwerten voneinander ab; Angaben sind daher quellenbezogen. Keine eigenen Hardwaretests.
Grenzen
Leistungs- und Speicherwerte sind interne Herstellerangaben. 29 GB im Blog sind nicht als vollständige RAM-plus-VRAM-Anforderung verifiziert. Aktuelle Residency-Werte und Release-Plattformen sind gesondert ausgewiesen; M2-Messung ist keine macOS-Verfügbarkeit. Blog/GitHub nennen für Edge0-120B unterschiedliche Terminal-Bench-Werte. Ein bf16-Vollgewicht fand sich nicht in den geprüften Listungen; das ist kein allgemeiner Fehlensbeleg. Lizenzübersicht ohne Einzelfallberatung; Edge0-Designation beweist keine Qwen-Kommerzialisierungsfreigabe und keine verifizierte Trainingsrevision.
Quellen
- Introducing Edge0-145B: Frontier AI Capabilities on Your Own Computer (Ankündigung, 12.11.2026), Edge0 (abgerufen 2026-11-13) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Edge0/Edge0-145B-NVFP4 (Modellkarte und Plattform-API), Hugging Face (abgerufen 2026-11-13) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Edge0 Community Model License, Version 1.0 (Lizenztext), Edge0 (Hugging Face) (abgerufen 2026-11-13) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- release-scope.json (Lizenzumfang und Upstream-Angaben), Edge0 (Hugging Face) (abgerufen 2026-11-13) ↩1 ↩2 ↩3
- Edge0-AI/Edge0 (Inferenz-Framework, Apache 2.0), GitHub (abgerufen 2026-11-13) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Qwen Community License 1.0, referenzierte Revision (Lizenztext), Qwen (Hugging Face) (abgerufen 2026-11-13) ↩