 KI
Fachüberblick am Abend, 28. Oktober 2026. Quellenstand: 15:50 Uhr MEZ. Diese erste zusätzliche Ausgabe behandelt drei Veröffentlichungen vom 26. und 27. Oktober, die in unseren heutigen Analysen zu LFM3 und Genie 4 nicht im Mittelpunkt standen. Die gemeinsame Frage ist die Verlässlichkeit agentischer Arbeitsabläufe: menschliche Entscheidung, technische Sicherheitsgrenze und reproduzierbarer Betrieb.
1. Agenteneinfluss: Was die randomisierte Studie isoliert
Anthropic rekrutierte 61 Fachleute mit Erfahrung in kausaler Datenanalyse. 50 arbeiteten in der Aufgabe mit Claude Code auf Basis von Claude Opus 4.8; elf verzichteten darauf. Die Aufgabe betraf die Wirkung eines fiktiven landwirtschaftlichen Beratungsprogramms. Offen blieben vier methodische Festlegungen sowie die abschließende Empfehlung. Für jede Entscheidung wurde die Präferenz des Agenten per Münzwurf festgelegt, ohne die Teilnehmenden zu informieren [1].
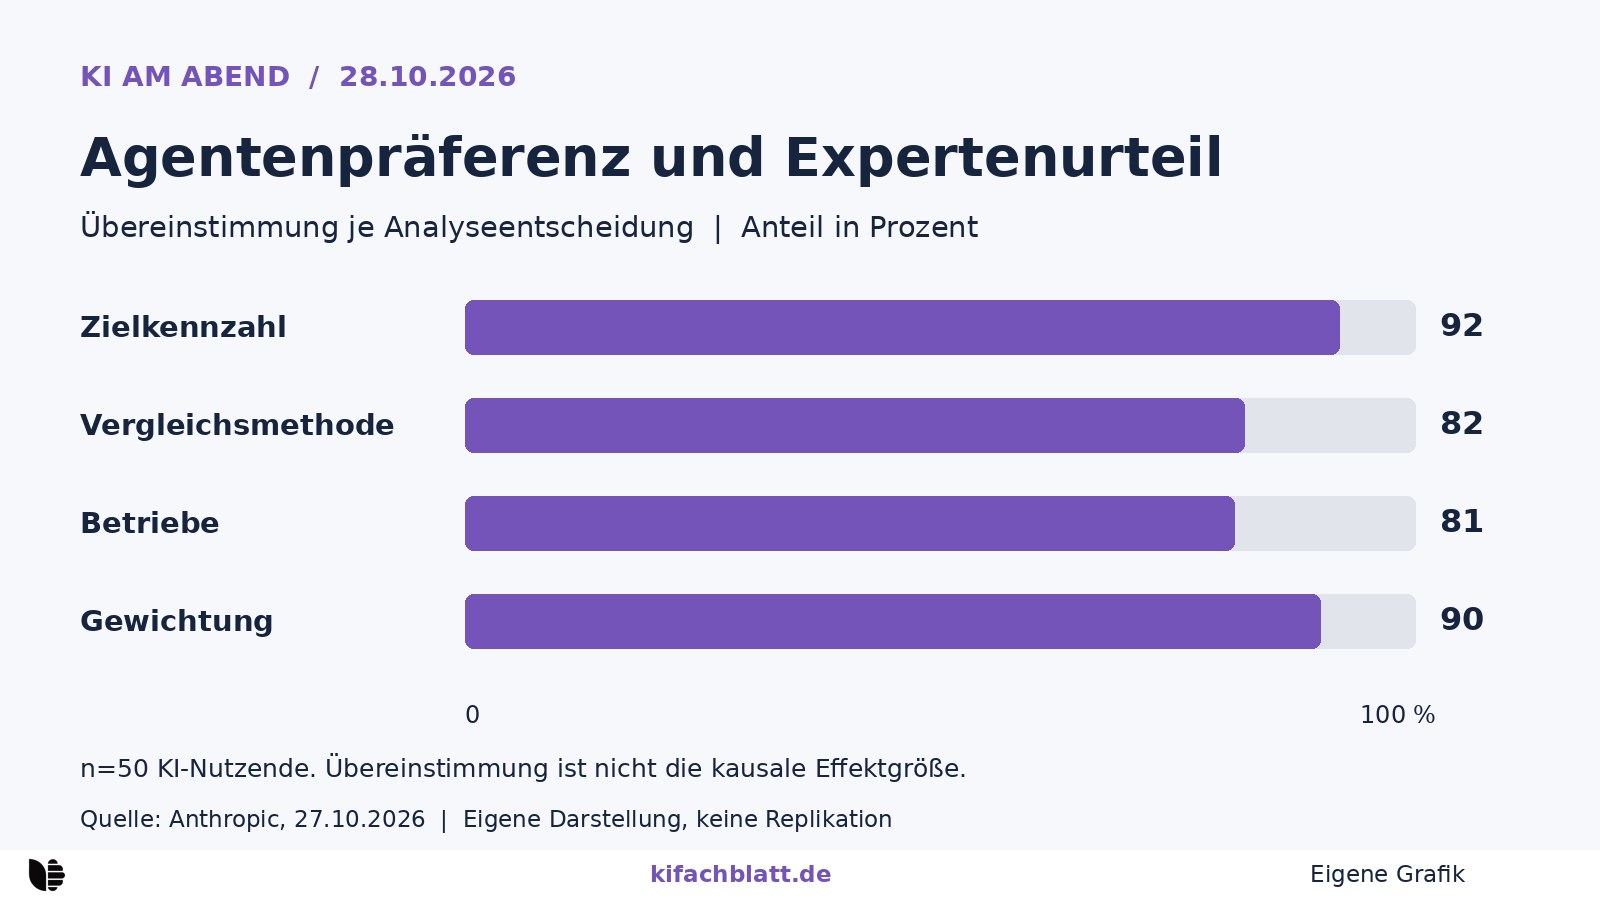
Der Bericht nennt für die vier methodischen Entscheidungen zusammen 86 Prozent Übereinstimmung mit der Agentenpräferenz. Nach Entscheidung aufgeschlüsselt waren es 92 Prozent für die Zielkennzahl, 82 Prozent für die Vergleichsmethode, 81 Prozent für die einbezogenen Betriebe und 90 Prozent für die Gewichtung. Die Gesamtzahl sollte nicht aus den gerundeten Einzelwerten neu berechnet werden: Sie ist der von den Autoren berichtete aggregierte Wert.
Diese Zahlen beschreiben Übereinstimmung, nicht unmittelbar die Effektgröße einer Veränderung zwischen Versuchsarmen. Für den Einfluss ist der Vergleich der zufällig zugewiesenen Präferenzen entscheidend. Die Publikation berichtet für die vier Entscheidungen Verschiebungen von 62 bis 82 Prozentpunkten zwischen den Gruppen. Die endgültige Empfehlung reagierte schwächer: 54 Prozent empfahlen eine Ausweitung, wenn der Agent dafür war, gegenüber 36 Prozent bei entgegengesetzter Präferenz [1].
Interpretationsgrenzen: keine globale Automationsbias-Quote
Die zufällige Zuweisung der Agentenpräferenz trägt den experimentellen Vergleich. Sie macht aus dem Vergleich von KI-Nutzenden und Nichtnutzenden jedoch keinen randomisierten Wirksamkeitsnachweis. Die elf Personen ohne Agenten hatten sich selbst dagegen entschieden und waren im Mittel weniger erfahren. Ihre höhere Fehlerrate und längere Bearbeitungszeit lassen deshalb keine saubere kausale Aussage über den Nutzen des Agenten zu.
Auch die oft zitierte Wechselquote von 60 Prozent bei widersprechendem Agenten beruht auf nur 38 Fällen mit zuvor geäußerter eigener Präferenz. Anthropic bezeichnet die Schätzung als unpräzise. Untersucht wurden eine Aufgabe, ein Fachgebiet und ein Modell mit gezielt verstärkter Präferenz. Der unabhängige Bericht von Al Jazeera greift die Kernergebnisse auf, ist aber keine Replikation [4].
Für Forschungsteams ergibt sich daraus eine überprüfbare Prozessidee: Vor der KI-Beratung Zielvariable, Grundannahmen und akzeptable Alternativen festhalten. Spätere Änderungen werden mit Begründung dokumentiert. Das ist unsere methodische Ableitung, keine in der Studie bereits getestete Gegenmaßnahme.
2. Sicherheitsfähigkeiten: interne Demonstration ist keine Produktmessung
Anthropics Bericht vom 27. Oktober beschreibt fünf Angriffsketten eines unveröffentlichten internen Forschungsmodells gegen Browser und Betriebssysteme. Der Hersteller meldet koordinierte Offenlegung und inzwischen verfügbare Korrekturen. Als konkreten Umfang nennt er für Chrome 62 zugewiesene und bis Chrome 156 gepatchte CVEs, darunter 13 Sandbox-Ausbrüche [2].
Für die Bewertung sind drei Ebenen zu trennen: ein gemeldeter Fehler, eine funktionierende Angriffskette in einer beschriebenen Testumgebung und die Verteilung dieser Fähigkeit über reale Aufgaben. Der Bericht liefert Fallstudien zu den ersten beiden Ebenen, aber keine allgemeine Erfolgsquote über beliebige Systeme. Unsere Redaktion hat die Ketten weder ausgeführt noch die Herstellerkorrekturen unabhängig auditiert.
Die defensive Konsequenz liegt in kontrollierter Exposition, zügigen Updates und mehrschichtigen Rechten. Eine Kombination aus Schutzschichten ist nur so gut wie ihre tatsächlichen Übergänge. Die Veröffentlichung ist kein Nachweis dafür, dass öffentlich verfügbare Claude-Versionen dieselbe Leistung unter denselben Bedingungen erreichen.
3. Hugging Face: Betriebsverbesserungen mit klaren Messgrenzen
Der Werkzeug-Rückblick vom 26. Oktober beschreibt einen gemeinsamen Cache für identische Xet-Dateien über Repositories hinweg. Hugging Face nennt als Beispiel einen 9,5-GB-Textencoder, den mehrere FLUX-Repositories nutzen: Die Datei soll nur einmal auf dem Datenträger liegen. Zusätzliche Funktionen betreffen Job-Wiederholungen, erneut gestartete Jobs und experimentelle isolierte Ausführungsumgebungen [3].
Für Storage Buckets berichtet Hugging Face einen Downloadtest einer 2,15-GB-Parquet-Datei auf HF Jobs: ungefähr zwei Minuten zuvor, ungefähr sieben Sekunden danach. Beim Laden derselben Datei mit der datasets-Bibliothek nennt der Anbieter 130 gegenüber 17 Sekunden. Das sind unterschiedliche Vorgänge; ihre Zeiten dürfen nicht zu einem einzigen Beschleunigungsfaktor vermischt werden. Netz, Cachezustand und Infrastruktur begrenzen die Übertragbarkeit.
Für einen eigenen Test wären identische Datei, festgehaltene Bibliotheksversionen, kalter und warmer Cache sowie wiederholte Messungen nötig. Kosten und Zugriffsrechte für Cloud-Ressourcen sind separat zu prüfen. Wir haben im Rahmen dieses Überblicks keine Jobs oder kostenpflichtigen Ressourcen gestartet.
Unsere Einordnung: Evidenzklassen statt eine einzige Leistungszahl
Die Entscheidungsstudie liefert einen begrenzten experimentellen Befund; der Sicherheitsbericht Fallstudien eines internen Modells; das Werkzeug-Update Anbieterbenchmarks. Keiner dieser Belege ersetzt die anderen. Fachlich sinnvoll ist, bei jeder Kennzahl zuerst Aufgabe, Vergleich, Modell und Umgebung festzuhalten. Erst dann lässt sich entscheiden, ob sie eine Produktwahl, ein Sicherheitsurteil oder eine Prozessänderung trägt.
Vertiefend dazu: Unsere Einordnung von Hersteller-Benchmarks erklärt Vergleichsgrenzen. Die heutige Genie-4-Analyse zeigt ein anderes Beispiel für einen Agenten im Regelkreis.
Quellen
- How AI agents shape experts’ judgment calls, Anthropic (abgerufen 2026-10-28)
- Discovering and exploiting vulnerabilities in critical, real-world software with Claude, Anthropic (abgerufen 2026-10-28)
- What’s new in the hf CLI and huggingface_hub library, Hugging Face (abgerufen 2026-10-28)
- Experts defer to AI in decision-making, Anthropic study finds, Al Jazeera (abgerufen 2026-10-28)