 KI
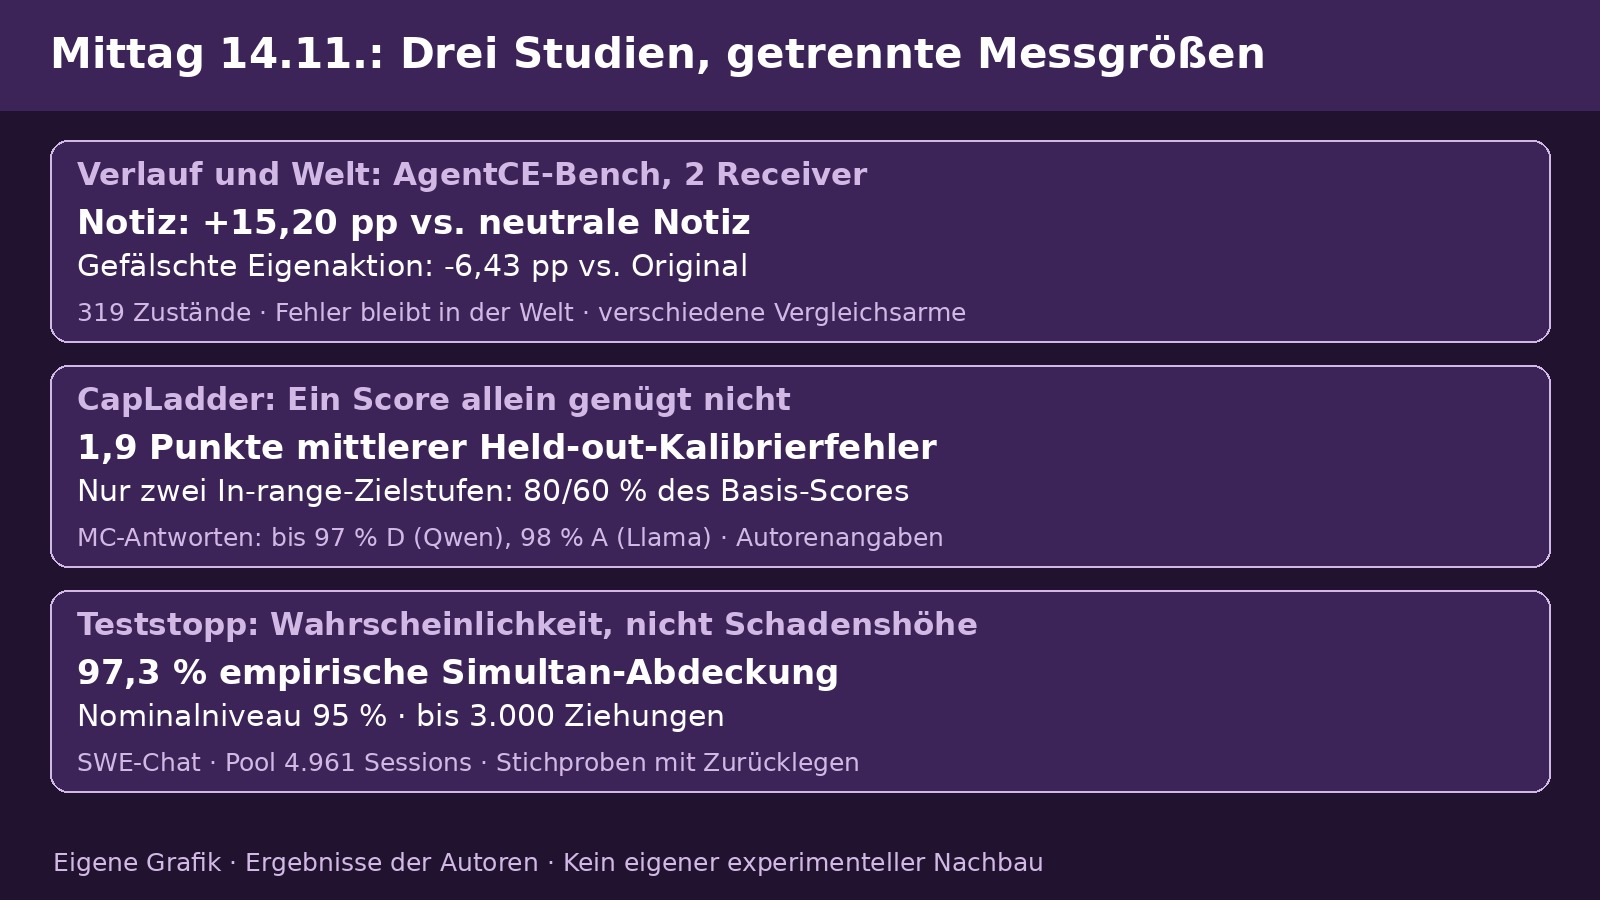
Fachüberblick vom 14. November, Quellenstand 09:50 Uhr MEZ. Drei Preprints: kontrollierte Verlaufs- und Welt-Edits für Agenten-Handoffs, eine Glaubwürdigkeits-Auditierung künstlich gesenkter Benchmark-Scores und ein sequentielles Stoppkriterium für Pre-Deployment-Tests.
1. Cleaning an Agent's History Hurts
Pakhomov, Koul, Liu, Pang, Joty und Nijkamp (Salesforce AI Research) trennen, was ein Verlaufs-Edit mitteilt, von dem, was er behauptet: Agenten werden mitten in der Aufgabe bitgenau eingefroren (Restore-Zertifizierung 200/200 AgentCE-Bench, Clopper-Pearson-Untergrenze 0,9817; AppWorld 20/20), Verlauf oder Welt werden editiert, ein Receiver führt fort. Design 1 (AgentCE-Bench, fester World-State, 319 Zustände mit committetem Fehler): Recovery = Anteil korrekter Look-ahead-Ziele. Wahre Notiz T neben erhaltenem Fehler: 65,78 % [62,54; 68,97] vs. neutrale Notiz N 50,57 %, T-N = +15,20 pp [12,46; 18,00]; gleicher Wert als eigene erledigte Aktion F: 43,70 %, F-O = -6,43 pp [-8,88; -3,97] gegen unbearbeitet; N-O = +0,44 pp unaufgelöst. Primärgröße D = +21,63 pp [18,21; 25,08], vor Erhebung fixiert, positiv in beiden Receivern (gpt-5.5: 24,03; claude-sonnet-5: 19,23); 95-%-Task-Cluster-Bootstrap; Gewinn lokal (+11,57 pp am benannten Slot, +3,63 pp Rest). Neun-Arme-Kontrolle (Appendix E): Spezifität +4,63 pp [2,989; 6,317] bei 97,5 % - der korrekte Wert allein erklärt die Effekte nicht; er bewahrt in einer eigenen Notiz-Kontrolle bereits den Großteil des Gewinns. Ein eindeutiger Nachweis, dass allein der Hinweis auf offene Arbeit wirkt, folgt daraus nicht.
Design 2 (AppWorld, fester Verlauf, Welt variiert; 8 Receiver, 4 Anbieter; Kalibrierband 25-75 %, claude-sonnet-5 unter Band = Konfundierung): Erfolgsquittung ohne Welt-Effekt -16,92 pp [-24,62; -9,62], mit Effekt +10,38 pp [3,46; 17,69], Interaktion +27,31 pp [14,23; 41,54] bei 97,5 %, über die zwei Hauptreceiver gepoolt; unter acht Receivern bei sechs auf 97,5-%-Niveau positiv aufgelöst und bei sieben auf 95-%-Niveau; gpt-4o-mini bleibt unaufgelöst; konsistente Zellen (failpre/succpost) nur 3,47 pp auseinander; Re-Issue unter gleicher Erfolgsquittung: 52,7 % bei fehlendem gegen 10,4 % bei vorhandenem Welteffekt. Deskriptiver Weltzustandsvergleich, keine Mediationsschätzung oder allgemeine Aussage über Agentenvertrauen. Limitationen: T und F unterscheiden sich in Kanal, Autorschaft, Position, Wahrheit (kein Faktorial); 2 Receiver im Hauptdesign; Schrittbudget bindet ungleich (71,4 % ausgeschöpft); eine Fortsetzung je Zelle. Code/Daten als arXiv-Ancillary (anc/).
2. Believable Performance Throttling (CapLadder)
Gan, Liang, Wei, Zhang und Ni fragen, ob ein Modell auf einen Ziel-Score gedrosselt werden kann, ohne sich von einem natürlich schwächeren Modell zu unterscheiden. CapLadder: 1.985 Items über Mathe, Code, MC-Reasoning und Tool-Use, IRT-Schwierigkeit aus 12 Respondenten; Glaubwürdigkeit = Zielkalibrierung + Schwierigkeitsprofil + Fehlerverteilung gegen schwache Referenz w. Weak-Teacher-LoRA-Dial (Skalar alpha): Reasoning-Zielwerte 0,24-0,90 erreichbar, Held-out-TCE 1,9 pt über zwei in-range Zielstufen (80/60 % des Basis-Scores); Prompting, Temperatur und Gewichtsrauschen erreichen Reichweite plus Präzision nicht. Aber MC: Answer-Token-Attraktor, bis 97 % aller MC-Antworten lauten D bei Qwen3.5-4B, bis 98 % A bei Llama-3.2-3B und Llama-3.1-8B; eine dominante Logit-Verschiebung identifiziert, Subtraktion auf Held-out-Items holt 52-59 % der verlorenen Accuracy zurück und entfernt den Attraktor; Options-Permutation bestätigt Token- statt Inhaltsbindung.
Audit-Asymmetrie: Naive Buchstaben-Histogramme detektieren die Drossel, ein shift-bewusster Gegner schwächt die Detektion durch Entfernen der dominanten Signatur; eine Restunwucht bleibt; menschenkodierte Fehlerkategorien sind dagegen referenznah (Reasoning JS = 0,00, kappa = 0,94); Tool-Use degradiert am natürlichsten (feingranulares JS = 0,09), jedoch nur in der Qwen-Familie belegt (Llama-Repeat unaufgelöst); globale alpha-Einstellung überträgt auf zwei nutzbare Benchmarks mit 14,2 pt Fehler. Limitationen: offene Modelle <= 9B, englische Items, ein Trainingslauf je Konfiguration (Punktschätzer, keine Trainingsstreuung), Deckeneffekt im Mathe-Teil, dual-use (Signatur-Entfernung wird mitgezeigt). CapLadder-Veröffentlichung im Paper behauptet; kein verifizierter Bezugslink im Preprint.
3. Unknown Unknowns: Missing Mass als Stoppkriterium
Li, Hays (beide Erstautoren), Ramdas und Raghavan (MIT, Stanford) formulieren Pre-Deployment-Testing als sequentielle Missing-Mass-Schätzung (Good-Turing-Tradition): Gesucht ist eine obere Konfidenzfolge U_t(alpha) auf die Wahrscheinlichkeit R_unseen, dass der nächste Lauf einen ungesehenen Fehlermodus zeigt; anytime-valid heißt: P(für alle t: R_unseen <= U_t) >= 1 - alpha (Theorem 3.2), der Entwickler darf also beliebig oft nachsehen und bei U_t < epsilon stoppen. Konstruktion: nichtnegativer Wett-Supermartingal über Restart-Segmente; Stoppzeit fast sicher endlich und bis auf Konstante optimal (Matching Lower Bound). Voraussetzungen: abzählbarer Ausgaberaum, iid-Züge aus der Zielverteilung P; ohne Verteilungsannahmen ist die Schranke trivial 1 (Heavy-Tail-Gegenbeispiel).
Empirie auf SWE-Chat (Baumann et al. 2026): 5.001 Sessions nach Preprocessing, 1.033 Fehlerkandidaten (Success-Score < 70), Judge GPT-5.6 Sol, Embedding-Cluster = 538 Fehlermodi; 1.000 Trials mit Ziehen aus 4.961 Test-Sessions mit Zurücklegen, alpha = 0,05, lambda-Grid. Ergebnis: empirische Simultan-Abdeckung 0,973 bis t = 3.000 (nominal 0,95); Schranke enger als multiple-testing-korrigierte Good-Turing-UCB und als punktuelle (nicht sequentielle) GT-UCB; wahre fehlende Masse sinkt von ~0,15 unter 0,1; ungünstigste Verteilung zeigt Coverage gegen 0,95 asymptotisch scharf. Erweiterungen: Verteilungsshift via Importance-Weighting (modest längere Stoppzeiten) und unperfekte Proxy-Labels: PPI (Labels sparen, 896 vs. 3.297 Ground-Truth bei epsilon = 0,1, Kosten 8.943 vs. 6.291 Sessions) und PAC-Labeler (3.297 Labels, 6.291 Sessions); perfekte Basis: 3.045. Limitationen: ökologische Validität (öffentliche Daten, fixe Taxonomie, LLM-Judges statt Anbieter-interner Praxis), PAC-Variante braucht Unsicherheitsscore und Audit-Mindestwahrscheinlichkeit je echtem Fehler. Code: github.com/rachelli2019/unseen-failures-code. Quellenabgleich von README, Runner-Dokumentation und einer Konfiguration, keine Ausführung der Experimente.
Zur Teststopp-Schranke: Sie begrenzt die Wahrscheinlichkeit ungesehener Fehlermodi unter den angegebenen Verteilungs- und Klassifikationsannahmen, nicht deren Schadenshöhe. Seltene katastrophale Fehler, bekannte ungelöste Fehler und ein allgemeiner Sicherheitsnachweis sind damit nicht abgedeckt. Alle empirischen Werte sind Autorenangaben; keine eigenen Agenten- oder Modelltests.
Methode
Quellenabgleich der Original-Preprints und der genannten Code-Dokumentation. Kein eigener experimenteller Nachbau. Abhängigkeiten von Rollen, Vergleichsarmen, Modellfamilien und statistischen Annahmen werden getrennt benannt.
Quellen
- Cleaning an Agent's History Hurts When the World Still Holds the Error, arXiv (Egor Pakhomov, Anurag Koul, Hongjun Liu, Bo Pang, Shafiq Joty, Erik Nijkamp; Salesforce AI Research) (abgerufen 2026-11-14)
- Can We Make an LLM Dumber, or Is It Just Playing Dumb? An Empirical Study of Believable Performance Throttling, arXiv (Chengguang Gan, Yunhao Liang, Hanjun Wei, QingHao Zhang, Shiwen Ni) (abgerufen 2026-11-14)
- Controlling the Probability of Unknown Unknowns in Pre-Deployment Testing of AI Systems, arXiv (Rachel Li, Chris Hays, Aaditya Ramdas, Manish Raghavan; MIT, Stanford) (abgerufen 2026-11-14)
- Unseen Failures: Quellcode, Runner und Konfigurationen, Rachel Li / GitHub (abgerufen 2026-11-14)