 KI
Abendüberblick vom 7. November 2026. Quellenstand: 16:07 Uhr MEZ. Drei Themen: Google validiert ein Smartwatch-Blutdruck-Screening gegen den klinischen Goldstandard, Harness-S transferiert Lösungswege aus Geschwister-Ausführungsgerüsten in die Policy, und Open-HumanWAM beschreibt Roboter-Vortraining im 50.000-Stunden-Maßstab bei noch laufendem Release.
Google: Smartwatch-Screening gegen den Goldstandard
Google Research beschreibt in einem Blogbeitrag vom 5. November das System AI-PPG-ACC-HTN, das Hypertonie-Anzeichen passiv aus PPG- und Beschleunigungssignalen (inklusive Ballistokardiogramm) einer Consumer-Smartwatch klassifiziert - ohne Kalibrierung an einer Armmanschette. Die zugehörige Studie erschien in Nature (Kooperation mit Beth Israel Deaconess Medical Center und Harvard Medical School). Methodik laut Beitrag: selbstüberwachtes Vortraining eines Wellenform-Encoders auf 492.347 Stunden Daten von 2.109 Teilnehmenden, anschließend Mittelung der Embeddings über mehrere Trage-Tage und Klassifikation inklusive Körpergröße als Proxy für die arterielle Pfadlänge.
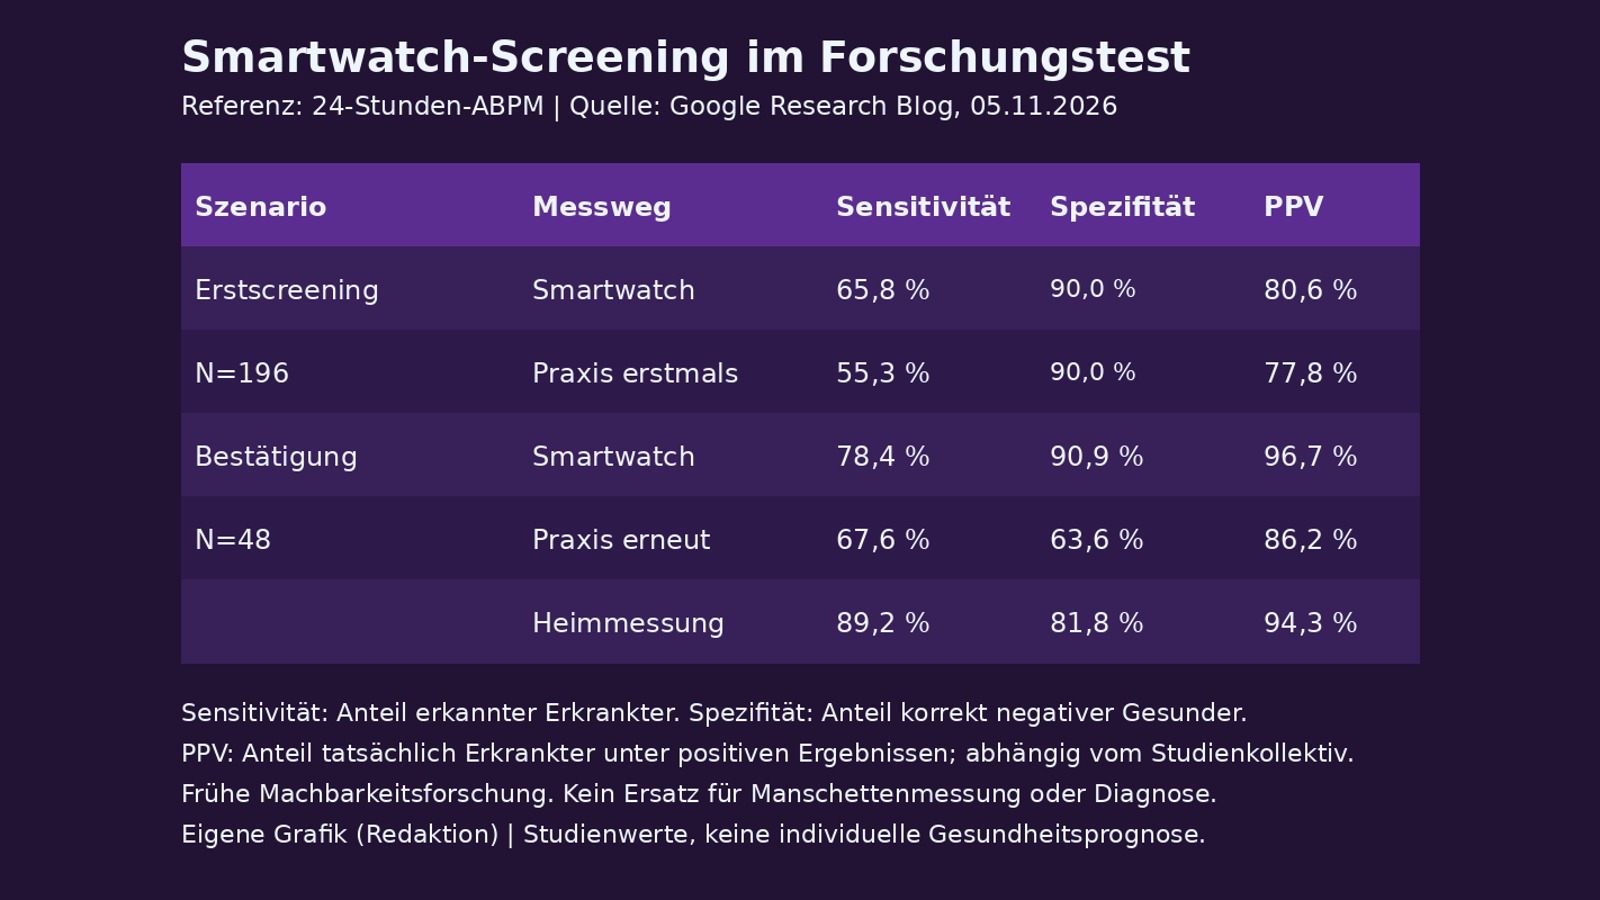
Validiert wurde prospektiv an fünf US-Standorten mit 196 Teilnehmenden ohne bekannte kardiovaskuläre Erkrankung gegen 24-Stunden-ABPM. Erstscreening: Sensitivität 65,8 Prozent, Spezifität 90,0 Prozent, PPV 80,6 Prozent (Praxis-Erstmessung: 55,3 Prozent Sensitivität und 90,0 Prozent Spezifität, PPV 77,8 Prozent). Bestätigungsprüfung bei zuvor auffälligem Praxiswert (N=48): Sensitivität 78,4 Prozent, Spezifität 90,9 Prozent, PPV 96,7 Prozent - mit höheren Punktschätzungen als bei der erneuten Praxismessung (67,6/63,6/86,2 Prozent) und im Bereich mehrtägiger Heimmessung (89,2/81,8/94,3 Prozent). Google stellt klar: kein Ersatz für Manschettenmessung oder Diagnose, sondern frühe Machbarkeitsforschung. Die Teilnehmenden nahmen keine blutdrucksenkenden Medikamente; die Übertragbarkeit auf andere Gruppen ist damit nicht belegt.
Harness-S: Rescue-Training aus dem Geschwister-Pool
Ein Team um Kangning Zhang und Wenxiang Jiao (arXiv, eingereicht 3. November) adressiert die Abhängigkeit von Agenten-Leistung vom Ausführungs-Harness. Statt ein universal bestes Gerüst zu suchen, erzeugt Directional Harness Evolution spezialisierte Geschwister-Harnesses mit unterschiedlichen Reparaturrichtungen und hält sie als festen Pool vor. Scheitern alle Versuche unter dem Basis-Harness, erzeugt dieselbe Policy Rollouts unter einem ausgewählten Ersatz-Harness; diese Trajektorien ersetzen die Fehlschlaggruppe im Verstärkungslernen (Complementary Harness Rescue Training). Ein Adaptive Harness Router wählt Top-k-Varianten über Verhaltensprofile und Mehr-LLM-Voting und aktualisiert die Profile mit der lernenden Policy.
Autorenangaben zufolge übertrifft die trainierte Policy (Qwen3.5-4B und -9B) auf AppWorld, SWE-Gym und DBBench reines Policy-Training, gemessen wieder unter dem Basis-Harness; Verhaltensanalysen und Held-out-Fälle stützen einen Transfer der Gerüst-Verhaltensweisen in die Policy, und Rank-1-Routing bei der Inferenz bringt weitere Gewinne bei gleicher Rollout-Anzahl. Die Werte sind nicht unabhängig geprüft. Die erste Codeausgabe deckt AppWorld ab; regelbasierte Auswahl ist voreingestellt, Profilkalibrierung und LLM-Voting sind optional. Laut README hat der portable GPU-Launcher noch keinen vollständigen Trainingslauf abgeschlossen. Die Veröffentlichung ist keine neue Bestätigung der Paperwerte.
Open-HumanWAM: offene Rezeptur für 50.000 Stunden Vortraining
Das Team um Juncheng Ma (Universität Peking, arXiv, v2 vom 5. November) veröffentlicht mit Open-HumanWAM eine als offen angekündigte Rezeptur für egozentrisches Vortraining: Der Korpus Open-HumanWAM-50K umfasst 50.000 Stunden Menschenvideo mit Handbewegungs- und Sprachannotationen; in Simulationen mit geschlossenem Regelkreis beschreiben die Autoren ein log-lineares Skalierungsgesetz zwischen Vortrainingsstunden und Roboter-Erfolgsrate.
HumanWAM-Vanilla (reines Menschenvideo-Vortraining) meldet nach Nachtraining 92,08 Prozent auf RoboTwin 2.0 Clean2Clean und 68,88 Prozent auf Clean2Random; HumanWAM-Goal mit gemeinsamem Mensch-Roboter-Vortraining erreicht 92,70 beziehungsweise 84,60 Prozent und zeigt auf physischen Robotern eine Form von In-Context-Lernen für ungesehene visuelle Ziele ohne Parameterupdate. Alle Zahlen sind Autorenangaben. Das GitHub-README begrenzt die Verfügbarkeit: Korpus-Upload läuft, Teile der Gewichte und Dokumentation stehen aus. Die öffentliche Vanilla-Evaluation nutzt 50 Episoden je Aufgabe statt 100 im Bericht; die öffentliche Goal-Evaluation nennt das berichtete 10.000-Episoden-Protokoll. Paperwerte und Releasezustand sind deshalb getrennt zu betrachten.
Quellen
- Detecting signs of hypertension using wearable sensors, Google Research Blog (abgerufen 2026-11-07)
- Opportunistically Detecting Signs of Hypertension on a Consumer Smartwatch, Nature (abgerufen 2026-11-07)
- Harness-S: Learning from Sibling Harnesses for Generalizable Agent Training, arXiv (Kangning Zhang, Wenxiang Jiao u. a.) (abgerufen 2026-11-07)
- DeepExperience/Harness-S (GitHub-Repository), GitHub (abgerufen 2026-11-07)
- Open-HumanWAM: An Open Recipe for Scaling Human and Robot Experience for Embodied Foundation Models, arXiv (Juncheng Ma, Jiaxin Li u. a.) (abgerufen 2026-11-07)
- DAGroup-PKU/HumanNet, Branch open-humanscale (GitHub-Repository), GitHub (abgerufen 2026-11-07)