 KI
Fachüberblick vom 13. November, Quellenstand 06:40 Uhr MEZ. Drei Preprints: eine Spektralanalyse von In-Context-Lernen ohne Merkmalslernen, numerische Online-Verifikation lokaler mathematischer Identitäten und eine vorregistrierte Analyse von LLM-Validatoren in Minimal-Pair-Benchmarks.
1. You Don't Need Feature Learning to Do In-Context Learning
Turnbull und Simon (UC Berkeley, Imbue) analysieren die ICL-Linearregressionsaufgabe von Raventós et al. (2023) mit rotationsinvarianten Kernel-Maschinen in der Kernel-Eigenbasis. Befund: Mit wachsendem Sample lernt die Maschine sukzessive höhergradige Komponenten der memorisierenden Lösung, die auf Statistiken entsprechend hoher Ordnung des Trainings-Tasksets beruhen; die generalisierende Lösung ist approximativ eine Low-Degree-Trunkierung der memorisierenden, das Modell generalisiert also zuerst und degradiert dann ins Memorisieren. Konsequenzen der Autoren: Generalisieren ist hier Underfitting des Auswendiglernens; Feature Learning ist für ICL nicht essenziell; die Task-Diversity-Story von Raventós et al. ist architekturunabhängig. Setup der Kernelexperimente u.a.: d = 5, L = 7, T = 16 Tasks, 20 Trials.
Transformer-Check: 12-schichtige GPT-2-Modelle mit Adam auf T = 256 Tasks (d = 8, L = 16) memorisieren über nicht-gaußsche Statistiken des Task-Pools; bei symmetrischem Pool ohne Kurtosis bleibt das Modell durchgehend generalisierend, mit Teilkurtosis länger als mit voller, wie die Theorie für den Grad-7-Modus vorhersagt. Limitationen laut Paper: nur lineare Regression mit gaußschen Inputs, keine Aussage zu natürlichsprachlichem ICL; die Memorisierungsphase ist für Modelle ohne Feature Learning schwer erreichbar. Code: github.com/JoeyTurn/kernels_can_icl (öffentlich erreichbar).
2. Catch It Where It Happens: Online-Verifikation beim Denken
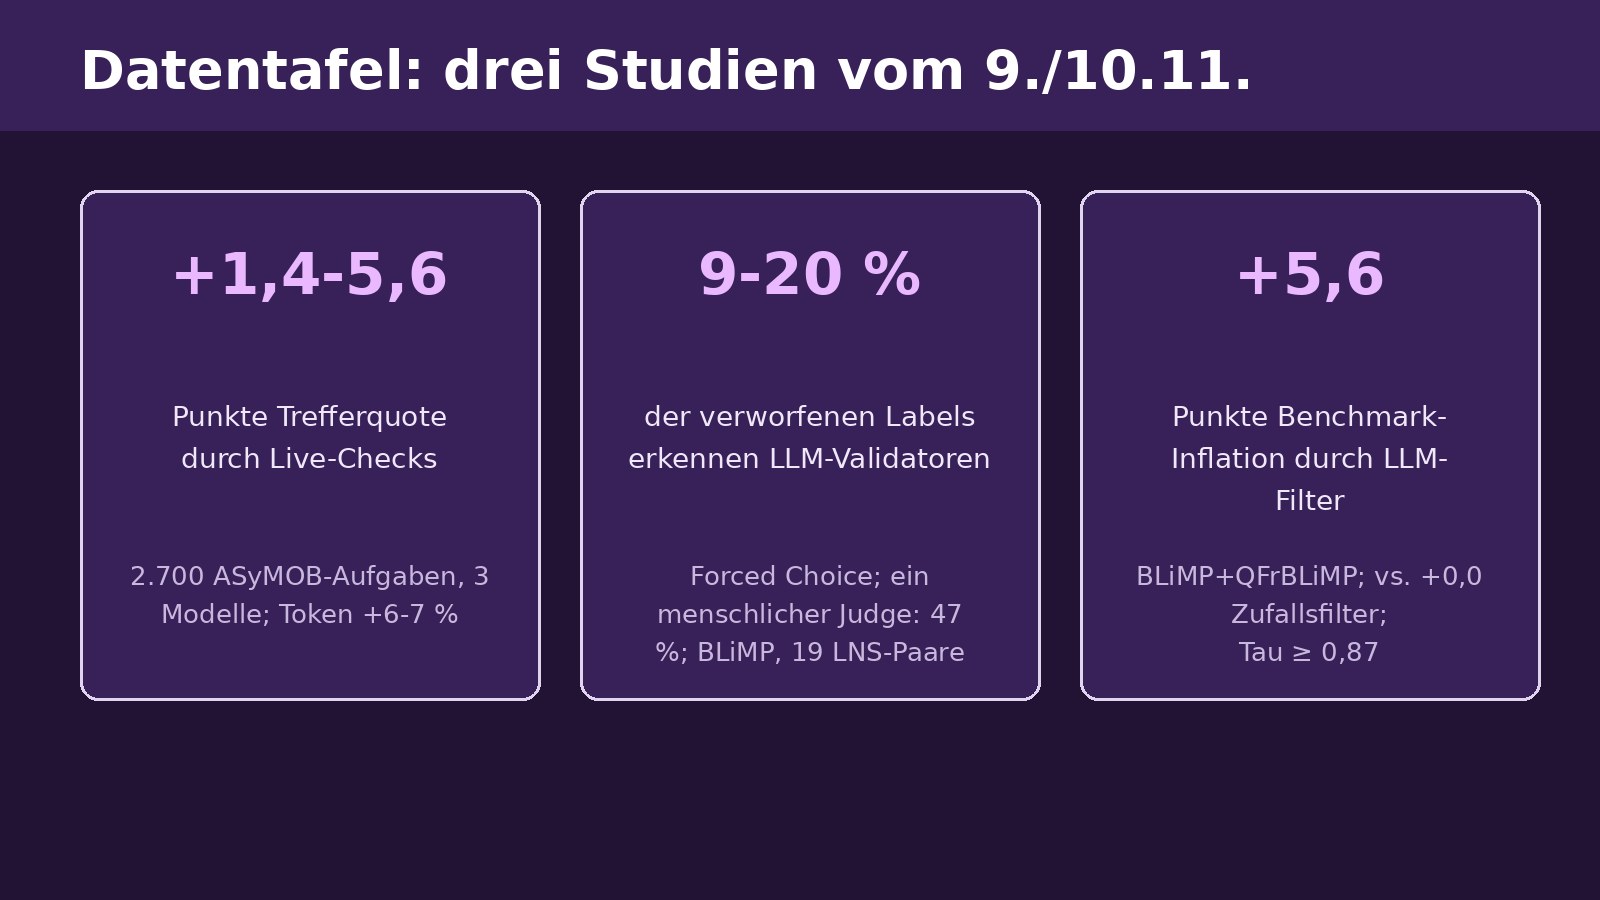
Elimelech, Shalyt und Kaminer (Technion) verifizieren mathematische Behauptungen während der Generierung: Regex-Extraktion fertiger Gleichungen aus dem Stream (Kettengleichungen werden in Paarclaims zerlegt, Definitionen und Bedingungsgleichungen heuristisch herausgefiltert), numerische Evaluation per Computer-Algebra-System auf CPU (22-25 ms pro Check, Toleranzvergleich über Stichproben-Substitutionen; holds ist numerische Übereinstimmung, kein Beweis). Nur fails löst Eingriff aus: Verwerfen der Fortsetzung hinter dem Fehlschritt, kurzes Korrektur-Feedback in Modellstimme, Generierung läuft weiter; maximal 3 Rollbacks pro Frage. Evaluation: 2.700 leichte bis mittlere ASyMOB-Aufgaben, Qwen3-30B-A3B-Instruct-2507, Qwen3-4B-Instruct-2507, Gemma-4-12B-it, je 5 Runs plain vs. checked. Accuracy: 62,4->68,0,23,4->24,8,45,2->48,2 Prozent (+1,4 bis +5,6 Punkte; Nettoreduktion falscher Antworten 1,8 bis 14,9 Prozent); Token +6-7 %; verworfene Token im Mittel 1,4 bis 15,6; Eingriffsquoten 21,8 bis 53,1 Prozent der Antworten. Das misst Prüf-CPU-Zeit und Tokenverbrauch, nicht den gesamten Zeitaufwand: Unterbrechen, erneute Promptverarbeitung und Cacheverwaltung können zusätzlich kosten. Kontrollierte End-to-End-Latenz- und Durchsatzvergleiche stehen aus.
Effektkanal: In den geflaggten Antworten steigt die Accuracy um 6,0 (Qwen3-4B), 6,4 (Gemma-4-12B) und 10,2 (Qwen3-30B) Punkte; in den ungeflaggten sind alle 95-%-Intervalle null-einschließend; die Flag-Anteile unterscheiden sich um höchstens rund zwei Punkte. Limitationen laut Autoren: nur lokal prüfbare Identitäten, keine Prüfung von Prämisse, Strategie oder Aufgabenbezug; kontextfreie Evaluation kann unter untersagten Annahmen gültige Identitäten verwerfen; numerisches Sampling kann Unstimmigkeiten übersehen; ein Benchmark, drei Modelle aus zwei Familien. Zu kontextualisieren: ASyMOB stammt von Shalyt et al., also aus derselben Gruppe; wir haben die Experimente nicht selbst reproduziert. Genannt als Erweiterungen: Syntax-/Type-Checks für Code, Dimensionsprüfung, Schema-Validierung von Tool-Calls.
3. LLM-Validatoren machen Minimal-Pair-Benchmarks leichter
Tang (Ghostcloud) testet LLM-Validatoren als Ersatz menschlicher Label-Prüfung auf BLiMP (348 Paare, 19-21 Crowd-Judges, 19 LNS-Paare = 5,5 %) und QFrBLiMP (1.693 Paare nach Entfernen identischer Dubletten, 12 Native Speaker, 112 LNS = 6,6 %); LNS = höchstens halbe Judge-Mehrheit für das Soll-Label. Drei API-Modelle, drei Prompt-Formate (Forced Choice, RATE 1-5, VERIFY post hoc), 1.000 Judge-Reshuffles gegen Held-out-Judges. Ergebnis: FC-Validatoren erreichen Agree mit gehaltenen Menschenmehrheiten 0,937-0,953 (BLiMP; Fünfer-Panel 0,934), aber LNS-Recall nur 0,09-0,20 gegen 0,47 eines Einzeljudges; das LLM-Panel flaggt 1,7 % der Paare bei 5,5 % LNS. RATE recalled mehr (BLiMP 0,38-0,52; QFrBLiMP 0,68-0,75) bei Precision-Verlust (5,4-23,2 % False Flags auf Paaren mit mindestens 75 % Judge-Support). Das vorregistrierte Phase-0-Urteil (nur BLiMP; QFrBLiMP unter der Reliabilitätsschwelle 0,5 bei Split-Half 0,454): bester Validator minus Dreier-Panel F1 = -0,077, Intervall [-0,304; +0,150], ein schwaches Pass.
Downstream-Effekt (Phase 1, 10 offene LMs von 1,5B bis 9B aus 7 Entwicklern, Primärfilter Gemini RATE): Menschlich gestützte Paare, die der Validator flaggt, sind im Mittel 18,9 Punkte schwerer für die LMs [-22,1; -15,8], negativ in allen 70 LM-x-Validator-Kombinationen (Holm p < 0,001); Entfernen der geflaggten Paare hebt die Accuracy um +5,6 Punkte [+4,6; +6,7] gegen +0,0 bei Zufallsentfernung. Auf QFrBLiMP entfernt der LLM-Filter 426 Paare (davon 85 LNS) und behält 27 der 112 LNS-Paare; jedes LM liegt auf der LLM-gefilterten Version über der menschlich gefilterten (+3,4 Punkte [+2,6; +4,3]). Die Rangfolge bleibt nahezu stabil (Kendall-Tau >= 0,87, maximal 2 von 45 Paarvertauschungen): verschoben werden in diesem Test vor allem Absolutwerte und Fehlersichtbarkeit, die Rangfolge bleibt weitgehend erhalten. Grenzen: drei Datensätze, korrelativer Mechanismus, LMs nur bis 9B, VERIFY erst post hoc; Code und Validator-Outputs laut Paper veröffentlicht, ohne genannten Link.
Quellen
- You Don't Need Feature Learning to Do In-Context Learning, arXiv (Joseph Turnbull, Jamie Simon; UC Berkeley, Imbue) (abgerufen 2026-11-13)
- Catch It Where It Happens: Real Time Error Correction During LLM Reasoning, arXiv (Rotem Elimelech, Michael Shalyt, Ido Kaminer; Technion - Israel Institute of Technology) (abgerufen 2026-11-13)
- LLM Validation Makes Minimal-Pair Benchmarks Easier for Language Models, arXiv (Guofang Tang; Ghostcloud) (abgerufen 2026-11-13)