 KI
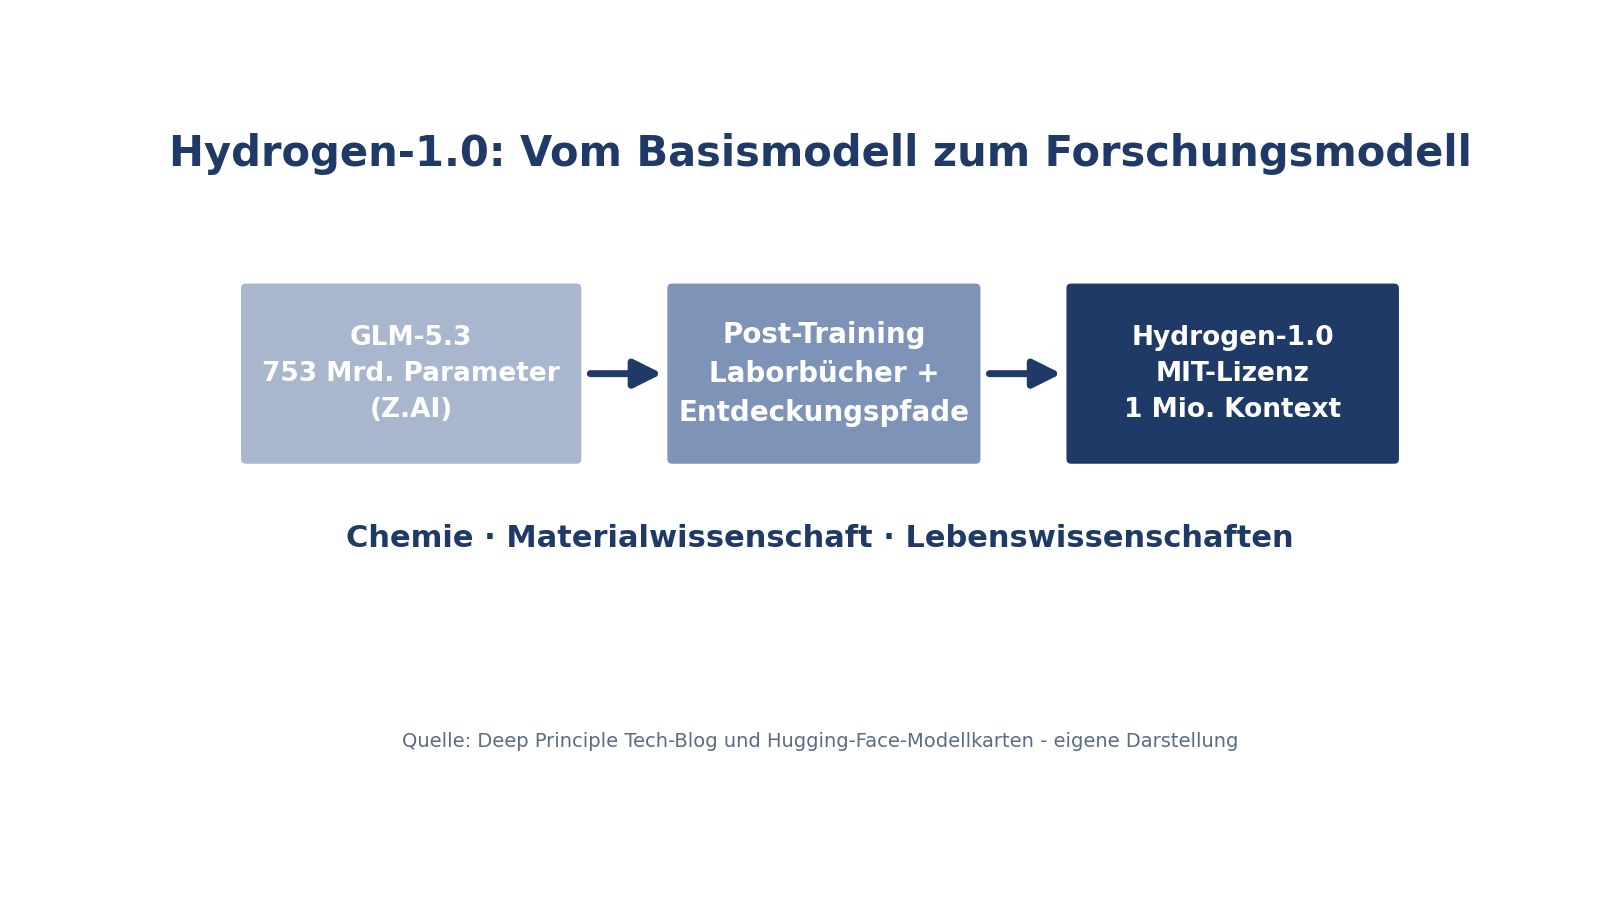
Deep Principle hat Hydrogen-1.0 vorgestellt, ein offenes Modell für wissenschaftliche Fragestellungen. Grundlage ist GLM-5.3 von Z.AI mit 753 Milliarden Parametern laut dessen Modellkarte; Deep Principle trainiert es mit Domänendaten aus Chemie, Material- und Lebenswissenschaften sowie mit Aufzeichnungen aus eigenen Laboren nach. Das Gewichts-Repository wurde laut Plattform-API am 31. Oktober angelegt; dieses Datum belegt nicht den Veröffentlichungszeitpunkt des Modells. Der Download auf Hugging Face erfordert eine Zugangsanfrage [1][2][3].
Die Eckdaten
Hydrogen-1.0 im Überblick (Herstellerangaben) [1][2][3]
Basis
GLM-5.3 (Z.AI), 753 Mrd. Parameter laut Basiskarte; vollständiges MoE-Post-Training
Kontext
1 Mio. Tokens konfiguriert; maximale Ausgabe 128.000 Tokens
Lizenz
MIT für die Gewichte laut Modellkarte; die Lizenzdateien selbst sind ohne Zugang nicht abrufbar
Varianten
BF16 unquantisiert (303 Shards); NVFP4 für NVIDIA B200/B300; MXFP4 für AMD MI350X/355X
Zugang
Hugging Face und ModelScope (Gewichte), NeuroSpark (API), Mira (AI-Scientist-Produkt)
Betrieb
Mit SGLang auf 8 GPUs getestet; die generation_config.json ist Pflicht, sonst stoppt die Ausgabe nicht am Antwortende
Was der Hersteller meldet
Der Tech-Blog berichtet ausschließlich interne Auswertungen: Hydrogen-1.0 schlage GPT-6-Astra auf FrontierScience-Research (Erfolgsquote) und verbessere GLM-5.3 auf GPQA-Diamond, ungefähr auf dem Niveau von Kimi-K3. Absolute Werte nennt der Beitrag nicht. In drei internen Szenarien bei maximaler Denkstufe liegt Hydrogen-1.0 demnach beim wissenschaftlichen Rechnen 5,13 Prozentpunkte und bei der einstufigen Vorwärtsreaktion 4,76 Prozentpunkte vor GPT-6-Astra; bei der NMR-Strukturaufklärung liegt Astra 3,33 Punkte vorn. Der Blog warnt selbst, die absoluten Werte zwischen den Aufgaben nicht als Modellvergleich zu lesen [1].
Zwei weitere Angaben: Bei der Experimentplanung (117 gemeinsame Fragen, Rubrik 0 bis 10) meldet der Blog einen Vorteil gegenüber Kimi-K3; GPT-6-Astra und Opus-5.5 seien ausgenommen worden, weil sie mehr als die Hälfte der Anfragen abgelehnt hätten. Und beim Design von Übergangsmetallkomplexen erreicht Hydrogen-1.0 nach fünf Runden einen mittleren besten HOMO-LUMO-Abstand von 4,318 Elektronenvolt - die Vergleichswerte der beiden Referenzmodelle aus derselben Grafik geben wir nicht wieder [1].
Daten als Tabelle
| Vorsprung in Prozentpunkten | |
|---|---|
| Wissenschaftliches Rechnen | 5,13 |
| Vorwärtsreaktion (ein Schritt) | 4,76 |
Herstellerangaben aus dem Tech-Blog (interne Auswertung, maximale Denkstufe), nicht unabhängig verifiziert [1]. Absolute Werte nennt der Blog nicht; bei der Kernresonanz-Strukturaufklärung (NMR) liegt GPT-6-Astra 3,33 Punkte vorn - siehe Text.
Beispiele aus dem Blog
Vier Demonstrationen zeigen den Arbeitsmodus: Das Modell schreibt eine Molekulardynamik-Simulation einer Polyethylen-Schmelze in GROMACS, erkennt einen Topologie-Fehler, repariert ihn und wertet die 40-Nanosekunden-Trajektorie aus. Es erkundet ein Ireland-Claisen-Reaktionsnetzwerk mit 27 Strukturen über 30 Reaktionen. Es arbeitet sich durch ein 1H-NMR-Spektrum, um unter sieben Monoformylierungs-Kandidaten von 2-Bromnaphthalin eine Struktur zu begründen. Und es schreibt ein JSON-Protokoll für eine Suzuki-Kopplung mit zwölf Gefäßen; eine virtuelle Laborprobe fängt dabei einen Pipettierschritt ohne frische Spitze ab, bevor reale Ressourcen gebunden werden [1].
Wie trainiert wurde
Die Pipeline kombiniert überwachtes Feintuning und bestärkendes Lernen auf vier Datenkategorien: Domänenwissen, Forschungsszenarien mit Feedback eigener Wissenschaftler, vollständige Laborbuch-Aufzeichnungen (elektronisch, über das hauseigene System Mira dokumentiert) und Entdeckungspfade, also Sequenzen aus Wahl, Ergebnis und Revision. Die Infrastruktur baut auf Megatron und SGLang, läuft auf NVIDIA-CUDA- und AMD-ROCm-Hardware, lagert den Muon-Optimiererzustand backendabhängig aus und kann RL-Rollouts fortsetzen: Jedes Token behält die Wahrscheinlichkeit der Politik, die es erzeugt hat. Bevor ein Trainingseffekt verbucht wird, messen die Autoren Export- und Quantisierungsdrift. Vollständige Datensätze und Rezepte veröffentlicht Deep Principle ausdrücklich nicht; beteiligt waren UniPat, Mind Lab und NeuroSpark [1][2].
Einordnung
Die Kombination ist selten: offene Gewichte unter der MIT-Lizenz in dieser Größenklasse, dazu ein ungewöhnlich detaillierter Blick in Trainingsinfrastruktur und Datenkategorien. Die Grenzen sind aber klar: Sämtliche Messwerte stammen aus einer Hand, absolute Ergebnisse fehlen, Trainingsdaten bleiben geschlossen, und der Download setzt eine Zugangsanfrage voraus. Der Betrieb bleibt Großrechner-Sache - die unquantisierte BF16-Variante belegt rund 1,5 Terabyte in 303 Shards, getestet ist eine 8-GPU-SGLang-Konfiguration. Die Verbreitung ist bislang gering: 56 Downloads im letzten Monat zählt die Plattform (Stand 4. November). Wer damit arbeiten will, sollte die Ausgaben wie der Hersteller selbst einordnen: als Material zur Prüfung, nicht als verifiziertes Ergebnis [1][2].
Methode
Analyse auf Basis des vollständig gelesenen Tech-Blogs von Deep Principle, der vollständig gelesenen Hugging-Face-Modellkarte (README; Lizenzangabe laut Modellkarte, Lizenzdateien nicht separat abrufbar), der Hugging-Face-Repository-API (Anlagedatum, Shard-Zahl, Download-Zähler) und der GLM-5.3-Modellkarte für die Parameterzahl. Alle Messwerte sind Herstellerangaben; Vergleichswerte anderer Modelle aus Herstellergrafiken werden nicht als deren eigene Werte wiedergegeben.
Grenzen
Keine eigenen Tests und kein eigener Zugriff auf die Gewichte (Repository mit Zugangsbeschränkung). Sämtliche Leistungsangaben stammen aus Herstellerquellen und nennen teils keine absoluten Werte. Trainingsdatensätze und vollständige Rezepte sind nicht veröffentlicht. Uns ist keine unabhängige Fremdmessung bekannt.