 KI
Morgenüberblick vom 8. November 2026. Quellenstand: 06:36 Uhr MEZ. Im Fokus stehen drei Entwickler-Updates: ADK Python 2.14.0, generative Chat-SDK-Karten mit json-render und Zyphras FP8-Prefill-Kernels ZYFA. Funktionsumfang, inkompatible Änderungen und Messgrenzen sind jeweils getrennt zu lesen.
ADK Python 2.14.0: Tests, Integrationen und Migrationen
Die GitHub-Veröffentlichung von ADK Python 2.14.0 ist auf den 7. November datiert, die Changelog-Überschrift auf den 4. November. Google erklärt dort ausgewählte Ausführungsumgebungen, die A2A-Integration sowie App-, Evaluations- und Simulationsmodule für stabil. Der Status bezieht sich auf die genannten Implementierungen im Python-SDK, nicht auf sämtliche ADK-Sprachversionen oder auf den A2A-Standard als Ganzes.
MultiRunConfig beziehungsweise adk eval --num_runs und --parallelism wiederholen Evaluationsfälle und aggregieren Scores oder Passraten. ToolArgsMatcher ergänzt exakten, case-insensitiven, numerisch toleranten und LLM-basierten semantischen Argumentvergleich. TeamsRunner und OpenAIDecisionsClassifier erweitern die Integrationen. Migrationsrelevant: FunctionTool liefert Enum-Argumente nun als Mitglieder des Enum-Typs statt als Strings. RunSkillScriptTool akzeptiert im Umgebungsmodus args, short_options und positional_args anstelle eines freien command-Strings; unterstützt sind dort .py-, .sh- und .bash-Skripte. Alte Aufrufe müssen angepasst werden. Außerdem können mit dieser Version geschriebene Firestore-Sitzungen laut Release Notes nach einem Rollback nicht von 2.13.0 oder älter gelesen werden.
Vercel: Schema-Prüfung für gestreamte Chat-Karten
Vercels Changelog vom 6. November verbindet json-render mit dem Chat SDK. Ein typisierter Katalog beschreibt Komponenten; das Modell erzeugt eine JSON-Spezifikation, die in eine Karte übersetzt wird. Adapter liefern native Formate wie Slack Block Kit und Teams Adaptive Cards. streamCard postet eine Teilkarte, sobald die Wurzel Inhalt trägt, und aktualisiert sie standardmäßig höchstens alle 500 Millisekunden.
Die API-Dokumentation trennt Teil- und Endvalidierung: toPartialCard behält bereits gültige Elemente; toCard prüft Props und Struktur und wirft bei Problemen CardSpecError. Auch streamCard kann am Ende scheitern, nachdem die Teilnachricht schon sichtbar wurde. Ohne explizite limits können Adapter Inhalte bei Plattformgrenzen herabstufen, etwa eine zweite Slack-Tabelle zum Codeblock. Mit limits lassen sich solche Spezifikationen ablehnen. Die Prüfung belegt weder die Richtigkeit der Kartenaussagen noch eine schadlose Ausführung angeschlossener Aktionen.
ZYFA: Zyphra meldet FP8-Gewinne im Prefill
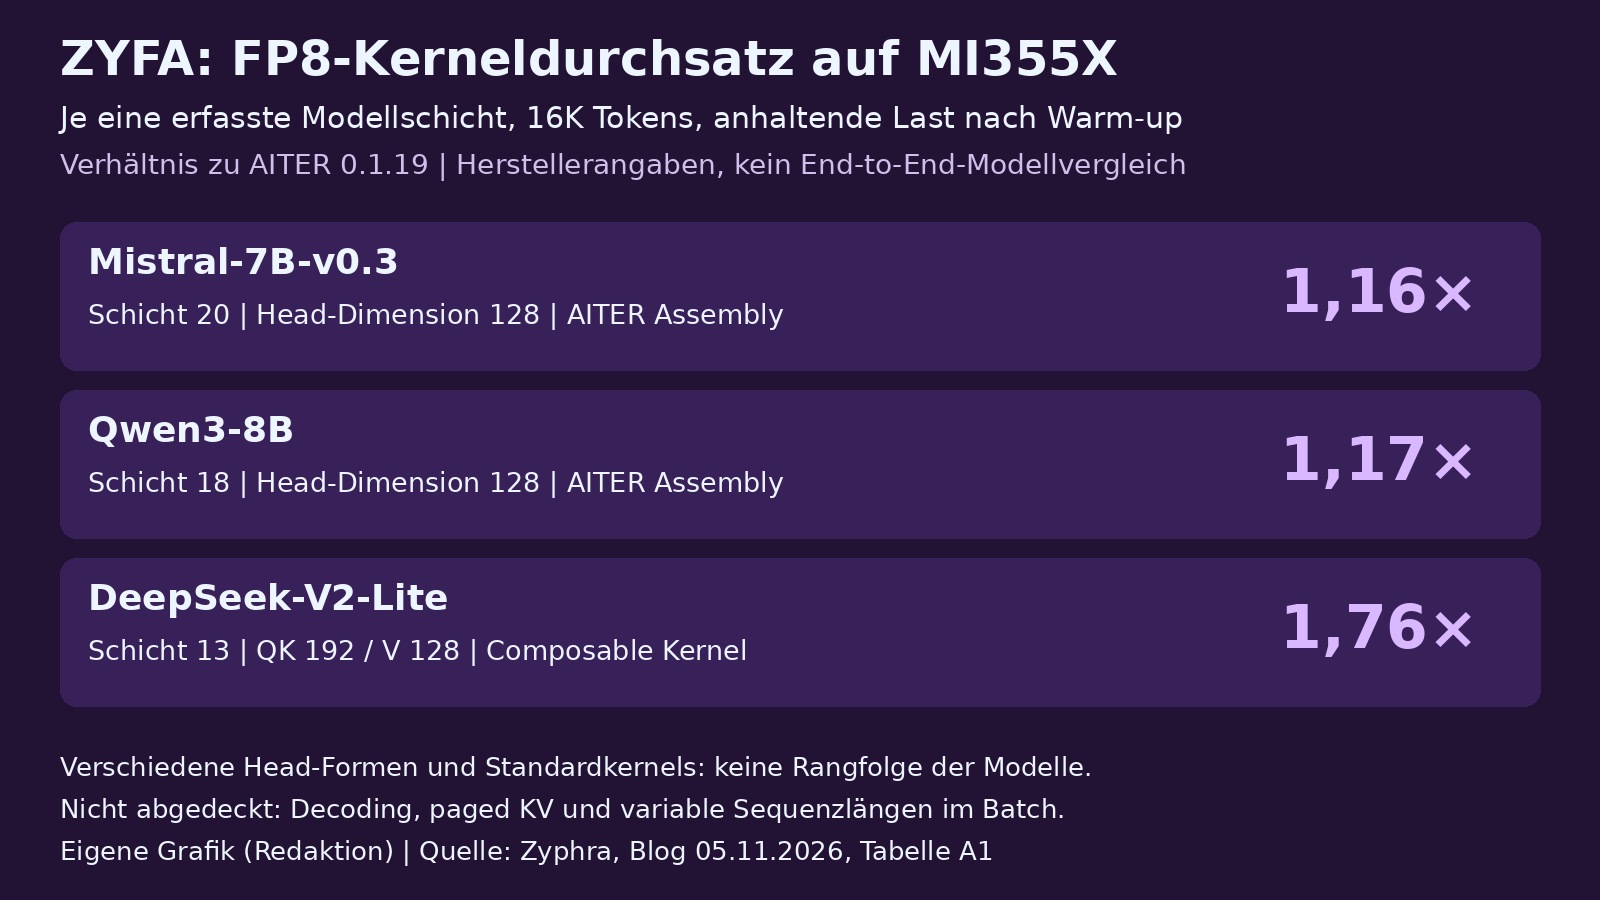
Zyphras Originalblog vom 5. November beschreibt FP8- und BF16-Attention-Kernels für MI355X (CDNA4). Die FP8-Variante kombiniert eine vereinfachte Wahrscheinlichkeitsberechnung, überlappte Softmax-/Matrixarbeit und blockweises Skalieren. Auf Aktivierungen je einer Schicht von Mistral-7B, Qwen3-8B und DeepSeek-V2-Lite bei 16K Tokens meldet Tabelle A1 den 1,16-, 1,17- und 1,76-fachen Durchsatz gegenüber dem jeweiligen AITER-0.1.19-Standardkernel. Es handelt sich um anhaltende Last nach Warm-up, nicht um eine Gesamtlaufzeit des Sprachmodells.
Alle Werte stammen vom Hersteller, sind nicht unabhängig geprüft und gelten als Momentaufnahme eines Knotens mit acht MI355X unter ROCm 7.2.3. Bei DeepSeek-V2-Lite ist die FP8-Baseline Composable Kernel, während die beiden anderen Formen den AITER-Assemblykernel nutzen. Synthetische Gauß-Eingaben ergeben andere Verhältnisse, weil Daten und Bitwechsel den Takt beeinflussen. Die README beschränkt ZYFA auf kausalen Forward-Prefill mit gleich langen Query-/Key-Sequenzen. Decoding, paged KV, variable Sequenzlängen im Batch und Backpropagation sind nicht unterstützt. Daraus lässt sich weder eine universelle Inferenzbeschleunigung noch eine Aussage über nachgelagerte Aufgabenqualität ableiten.
Quellen
- ADK Python v2.14.0: Release Notes, Google / GitHub (abgerufen 2026-11-08)
- Chat SDK agents can now stream generative UI with json-render, Vercel (abgerufen 2026-11-08)
- @json-render/chat: API-Dokumentation, json-render (abgerufen 2026-11-08)
- ZYFA: Fast and Accurate FP8 Attention on AMD MI355X, Zyphra (abgerufen 2026-11-08)
- Zyphra/zyfa: README und Implementierung, Zyphra / GitHub (abgerufen 2026-11-08)