 KI
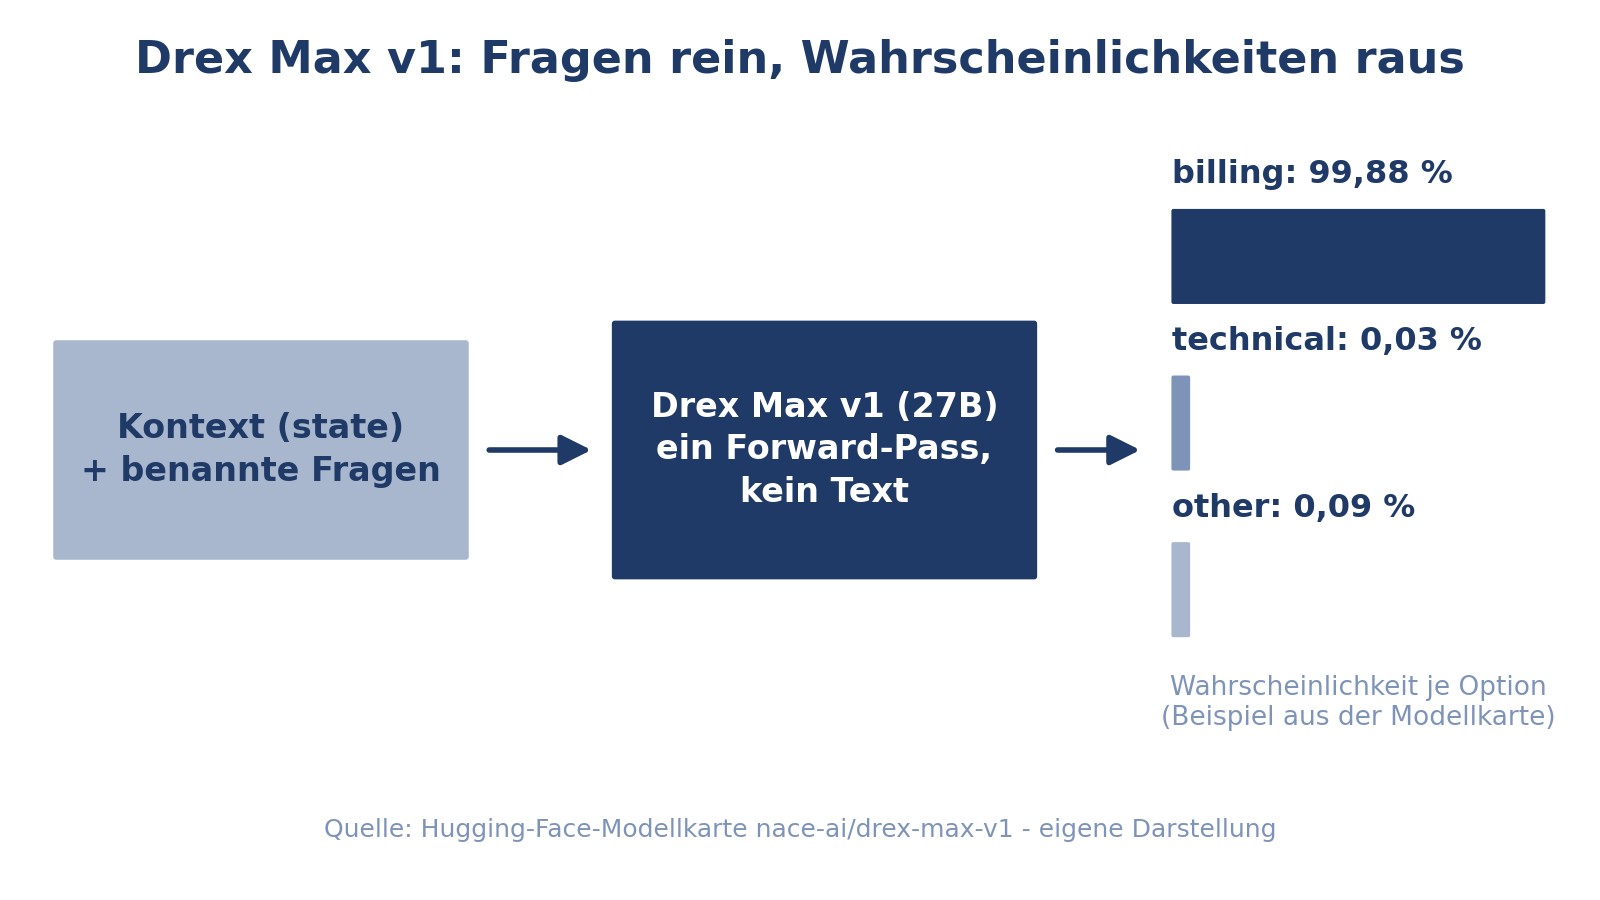
Die meisten Sprachmodelle erzeugen Text, aus dem man eine Entscheidung herauslesen muss. Nace AI baut die Gegenrichtung: Seine Drex-Modelle nehmen einen Kontext und benannte Fragen entgegen und liefern pro Frage Wahrscheinlichkeiten für die vorgegebenen Optionen - in einem einzigen Forward-Pass, ohne dass ein Token generiert wird. Am 1. November meldete der unabhängige Release-Tracker AIFOD die offenen Gewichte von Drex Max v1, dem stärksten Modell der Reihe; das Gewichts-Repository ist seit dem 13. Oktober auf Hugging Face [1][4].
Die Eckdaten
| Eigenschaft | Wert |
|---|---|
| Architektur | Dichtes 27B-Modell, 64 Schichten: 48 Gated-DeltaNet-Linear-Attention-Schichten (kausal) und 16 nicht-kausale Voll-Attention-Schichten (jede vierte) |
| Ausgabe | 255-Wege-Readout-Kopf: Wahrscheinlichkeiten für bis zu 255 Optionen; Fragetypen choice, noul (Ja/Nein), score |
| Kontextfenster | 16.384 Tokens pro Anfrage (Standard), erweiterbar bis 262.144 Tokens |
| Multimodal | Text und Bilder; Bilder nur über den Python-Pfad, nicht im GGUF |
| Speicherbedarf | bf16-Gewichte ca. 49 GB; Backbone in 8-bit ca. 26 GB; Q8_0-GGUF 48 GB RAM; affines Q4 ab 24 GB (Apple Silicon) |
| Lizenzen | Gewichte: Nace.AI Open RAIL-M (Version 1.0, Oktober 2026); Code: Apache 2.0 |
| Hosted-API | Modelle drex-max und drex-max-v1.1; 0,03 US-Dollar pro Million Eingabetokens, Ausgabetokens unberechnet |
Was ein Entscheidungsmodell anders macht
Eine Anfrage besteht aus einem Zustand (state) und einer oder mehreren benannten Fragen. Das Modell bewertet jede Frage gegen denselben Kontext und antwortet mit Wahrscheinlichkeiten: Im Beispiel der Modellkarte wird ein Support-Ticket der Option billing mit 99,88 Prozent zugeordnet, technical liegt bei 0,03 Prozent [1]. Solche Verteilungen lassen sich direkt an Schwellenwerte und Automatisierungslogik hängen - ohne Parsing freien Texts. Technisch entscheidend: Die 16 Voll-Attention-Schichten arbeiten nicht-kausal, jedes Token kann die ganze Sequenz sehen. Der mitgelieferte Loader setzt das um; ein gewöhnlicher kausaler Chat-Lauf reproduziert die gemeldeten Werte nicht [1].
Die gemeldeten Messwerte
Auf Nace AIs eigenem öffentlichen Decision Index 0.4 - 37 Benchmarks in fünf Bereichen, 140.178 auswertbare Anfragen, unbeantwortete Anfragen zählen als falsch - erreicht Drex Max nach Herstellerangaben 67,52 Punkte, der Vorgänger Drex v2.0 (35B, MoE mit rund 3B aktiven Parametern) 61,25 [1][3]. Auf dem Fremdindex Artificial Analysis Decision Index liegt das Modell laut Modellkarte bei 64 Punkten und Rang 4 von 18, einen Punkt hinter drei Modellen mit 65 und vor Claude Haiku 5.5 (Low) mit 61 [1]. Beim Bildverstehen meldet die Karte einen Vision-Index von 73,92, darunter 97,3 auf InfographicVQA, aber auch Schwachstellen: 40,6 bei Moderation (Hateful Memes) und 38,6 auf R-Bench-M [1].
Daten als Tabelle
| Zufallskorrigierter Skill × 100 | |
|---|---|
| Wissen & Schlussfolgern | 57,1 |
| Sprache | 72,2 |
| Retrieval | 68,8 |
| Tools | 81,9 |
| Arts | 53,4 |
Herstellerangaben aus der Modellkarte (Messstand 19.10.2026), nicht unabhängig verifiziert [1]. Zufallskorrigierte Skill-Werte mal 100 je Bereich; der Gesamtindex von 67,52 bildet sich aus 37 Benchmarks und ist kein Durchschnitt dieser fünf Werte.
Lokal betreiben
Die Karte nennt drei getestete Wege: Python auf NVIDIA-GPU (H100 80 GB mit bf16, L40S 48 GB mit 8-bit-Backbone), llama.cpp- und Ollama-Forks (Branch drex-max-v1) auf Apple Silicon und CPU, sowie Kapitsa und MLX für das affine Q4-Checkpoint ab 24 GB. Auf einem Mac mit M5 Pro (48 GB) lagen die Q8_0-Antworten laut Karte innerhalb von 0,02 der bf16-Referenz [1]. Zu beachten: Bilder stecken nicht im GGUF, sie laufen nur über den Python-Pfad; das Standardlimit von 16.384 Tokens pro Anfrage lässt sich per Umgebungsvariable bis auf 262.144 Tokens anheben [1]. Die Verbreitung ist bislang gering: 192 Downloads im letzten Monat auf Hugging Face [1].
Einordnung
Drex Max v1 ist kein Chat-Ersatz, sondern ein Baustein für Systeme, die klassifizieren, routen oder freigeben: Tickets verteilen, Inhalte prüfen, nächste Schritte wählen. Dass ein dichter 27B-Entscheider auf dem hauseigenen Index den größeren MoE-Vorgänger schlägt, ist plausibel, aber eine Herstellerrechnung - der Decision Index 0.4 stammt von Nace AI selbst. Die Lizenz ist zweigeteilt: Der Code steht unter Apache 2.0, die Gewichte unter einer Open-RAIL-M-Variante: kommerzielle Nutzung ist erlaubt, solange Umsatz und Funding der Organisation unter je einer Million US-Dollar liegen (persönliche Nutzung und Forschung ausgenommen); darüber verlangt Nace AI eine separate Lizenz, und die Nutzungsbeschränkungen sind an Weiterempfänger weiterzugeben [3][5]. Wer einfach nur ausprobieren will, findet das Modell auch als Hosted-API für 0,03 US-Dollar pro Million Eingabetokens [2].
Methode
Analyse auf Basis der Hugging-Face-Modellkarte, der Hersteller-Dokumentation, des Code-Repositorys, des Lizenztexts und des unabhängigen Release-Trackers; alle Quellen wurden gelesen. Sämtliche Messwerte sind Herstellerangaben und als solche gekennzeichnet; Werte konkurrierender Modelle aus Herstellertabellen werden nicht als deren eigene Werte wiedergegeben.
Grenzen
Keine eigenen Benchmark- oder Inferenz-Tests. Der Decision Index 0.4 ist eine Hersteller-Suite; die Platzierung auf dem Artificial Analysis Decision Index stammt aus der Modellkarte und wurde nicht am Originalindex gegengeprüft. Verbreitungs- und Stabilitätsaussagen sind wegen der geringen Downloadzahl (192 im letzten Monat) nicht möglich.
Quellen
- nace-ai/drex-max-v1 - Modellkarte, Hugging Face / Nace AI (abgerufen 2026-11-02) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Drex Max - Drex Docs, Nace AI (abgerufen 2026-11-02) ↩1 ↩2
- nace-ai/drex-decision-models - Repository, GitHub / Nace AI (abgerufen 2026-11-02) ↩1 ↩2 ↩3 ↩4
- AI Model Releases - November 2026 (Live Tracker), AIFOD / af.net (abgerufen 2026-11-02) ↩
- Nace.AI Open RAIL-M License (Modified), Version 1.0, Hugging Face / Nace AI (abgerufen 2026-11-02) ↩1 ↩2 ↩3